3.2 随机访问:引物地址的发明
3.2 随机访问:引物地址的发明
本节摘要:随机访问指在包含海量异构分子的文库中,按需特异性富集并解码目标文件所对应的分子子集,而不必触碰其余数据。本节讲清它的实现原理——引物地址、PCR 富集与磁珠捕获,梳理 2015 到 2018 年间从概念演示到两级寻址系统的演化,并给出索引设计的工程阈值:熔解温度窗口、汉明距离与正交性校验。
先算一笔检索的账
想象一个归档了十万份文件的 DNA 文库。现在老板要第三千七百号文件,两种做法:其一,把整个池子拿去测序,全部解码后从磁盘上翻出目标——按 2018 年的通量,光测序就要以天计,账单以万美元计,而且百分之九十九点九的测序量花在与你无关的文件上。其二,只在分子层面把第三千七百号"捞"出来,只测序捞到的那一小撮——时间以分钟到小时计,成本降几个数量级。随机访问的全部意义,就是把做法二变成可靠工程。
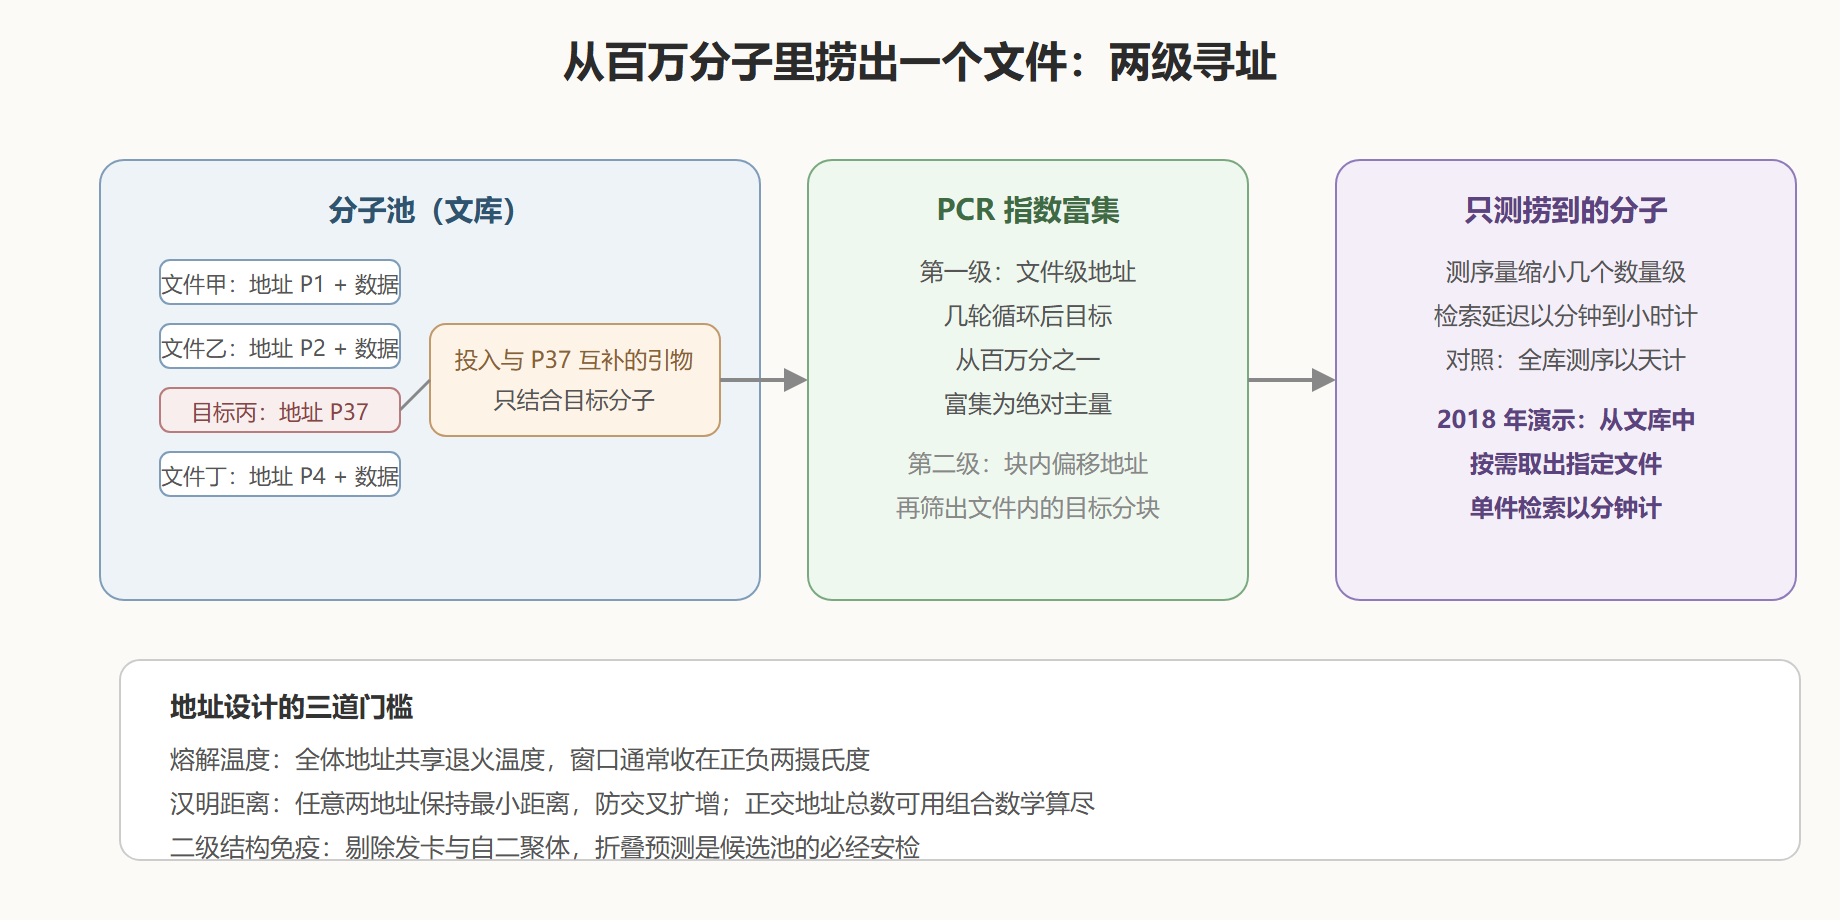
捞的动作靠的是分子生物学最老的工具:聚合酶链式反应。每条 oligo 的两端都带有一小段"地址序列"(引物结合位点);要捞某个文件,就往池子里投入与该文件地址互补的引物,引物只与带相应地址的分子结合并触发指数扩增,几轮循环后目标分子从背景里的百万分之一富集到绝对主量,随后纯化、测序、解码。物理原理与诊断实验室用了几十年的 PCR 完全相同——真正的发明不在反应本身,而在"把地址当成文件系统"的设计意识。
地址设计的工程阈值
引物地址不是随便挑一段序列就行的,它有自己的三道门槛。
第一道是熔解温度。所有地址序列的熔解温度必须落在统一的窄窗口里,工程上通常要求偏离设定值不超过两摄氏度。原因很实际:同一轮 PCR 里几十种引物共享同一个退火温度,谁的熔点偏高谁就可能错误配对,偏低的则根本结合不上。
第二道是汉明距离。任意两个地址序列之间必须保持足够的最小汉明距离——即至少差出若干个碱基——否则一个地址的引物可能结合到另一个地址的分子上,文件甲的内容串进文件乙的扩增产物。距离阈值的设定要用组合数学算覆盖率:给定地址长度与最小距离,可用的正交地址总数是有限的,文库规模越大、地址越长,这道数学题越紧。
第三道是二级结构免疫。地址序列自身不能折叠成发卡、也不能彼此配对成双链,否则引物还没找到目标就先被自己人锁死。实际设计中要在候选地址池上跑热力学折叠预测,把自由能不达标的序列剔除。
用一段伪代码概括设计流程:
输入:文件数 N=10万,地址长度 L=20 1. 生成候选池:随机序列,GC 含量限 40%–60% 2. 计算每个候选的熔解温度,保留落在 55±2 ℃ 窗口者 3. 两两计算汉明距离,用贪心图着色选出最大正交子集 4. 对入选者跑折叠预测,剔除发卡与自二聚体 5. 若正交池不足 N,加长 L 或引入两级寻址重试 输出:N 个可分配地址
图:两级引物寻址的随机访问原理
从单级地址到存储系统
2015 到 2018 年间,随机访问走完了从技巧到系统的演化。2015 年伊利诺伊大学的团队演示了可重写、可随机访问的原型:用引物把文库划分成逻辑分区,更新数据时用"地址覆盖"实现分子层面的改写。2018 年微软与华盛顿大学的联合团队把两级寻址做进了 200 兆比特级的文库:第一级地址定位文件,第二级地址定位文件内分块,任意取一份文件只需两轮富集,检索延迟以分钟计——而此前全库测序的方案要以天计。这组对比数字后来被广泛引用,成为"分子硬盘"概念成立的标志性证据。
系统化的另一面是开销显性化。地址要占序列长度:每条 oligo 两端各二十来个碱基的地址加引物区,纯数据区从名义长度里实打实扣掉一截;地址池的正交性上限决定了单库能挂多少文件;检索的并发度还受 PCR 通道数限制。这些开销在第三章的全景图里只值一句话,到第六章算总账时,每一项都会以成本的形式重新出现。
要点回顾
- 随机访问的本质是用引物在分子池里"点名":互补配对触发的特异性富集,让检索成本从"全库测序以天计"降到"单件富集以分钟计"。
- 地址设计有三道门槛:熔解温度窗口、最小汉明距离、二级结构免疫;正交地址池的容量可用组合数学精确计算。
- 两级寻址(文件级加分块级)是系统化的关键一步,2018 年的演示标志着"分子硬盘"从概念变成可检索的系统。
- 地址开销会直接吃掉序列的名义密度,这是语法奠基期的普遍规律:每个部件都在用密度换能力。
历史旁注:从基因诊断借来的手艺
随机访问的每一步都能在基因诊断行业找到原型。临床 PCR 用引物特异性区分病原与宿主,产前筛查用探针从海量背景序列里富集目标片段——分子"点名"在诊断实验室里已经运行了三十年。存储领域的真正增量,是把这套手艺从"检测单一靶标"扩展为"管理百万地址的文件系统":地址要正交设计、要分层次、要可注册、要与纠错码联动。这是一次教科书式的技术迁移——底层化学一行没改,上层语义全部重写。
值得记住的时间线:2015 年伊利诺伊大学的原型演示验证了可重写与随机访问的可行性;2016 年前后的工作把正交地址池扩到十万量级并验证了 PCR 多路复用的上限;2018 年微软与华盛顿大学的两级寻址把检索延迟压到分钟级。三年一个台阶,节奏与任何软件子系统的成熟曲线相似——随机访问不是灵光乍现,而是一段被压缩播放的工程史。
还有一条工程经验值得留给后来者:地址资源要留余量。正交地址池的总数是硬约束,若按当前文件数满打满算,后续每次扩容都要重新洗牌全库地址。成熟系统会按地址长度的理论上限预留数倍余量,宁可初期浪费几个碱基,不把未来的扩展性锁死在今天的文件数上。
追问补遗
PCR 的指数放大会不会把错误也放大? 会,这是随机访问最需要管理的副作用。每一轮复制都有新增差错,循环数越多、群体里错误拷贝占比越高。对策是控制循环数在"富集够用"的最小值,并让纠错码的容量覆盖 PCR 引入的错误预算——这个预算必须显式记账,不能含糊地并入"测序噪声"。精细的系统还会在富集后做一次小规模质检测序,用实测错误率回填下一轮的纠错参数。
地址能不能也拿来存数据? 有方案这么做过:把地址区与数据区用同一套编码复用,读回后再解复用。理论上省几个碱基,代价是地址必须全库唯一且不可协商——一旦两份数据共用地址,富集与定位都会打架。工程结论是省下的密度不值得换回的复杂度,主流方案仍把地址区当纯开销处理。
寻址解决"找得到",纠错解决"读得回",但所有这些设计都在一条看不见的边界内作业——碱基约束。下一节把这条边界摊开:GC 含量、同聚物、二级结构,分子世界的三条交通规则。