4.1 寡核苷酸池合成:写入的经济学
4.1 寡核苷酸池合成:写入的经济学
本节摘要:寡核苷酸池(oligo pool)合成是 DNA 存储当前的主力写入方式:一条 oligo 一条数据分块,数十万条序列在芯片上一批合成,按池计价。本节拆解它的化学原理与成本结构——偶联效率的指数衰减如何限定读长,并行规模如何摊薄单价——并给出写入端的真实账本:按现行行业口径,写入一兆字节数据的合成开销仍在千美元量级。
先看化学:一条链怎么长出来
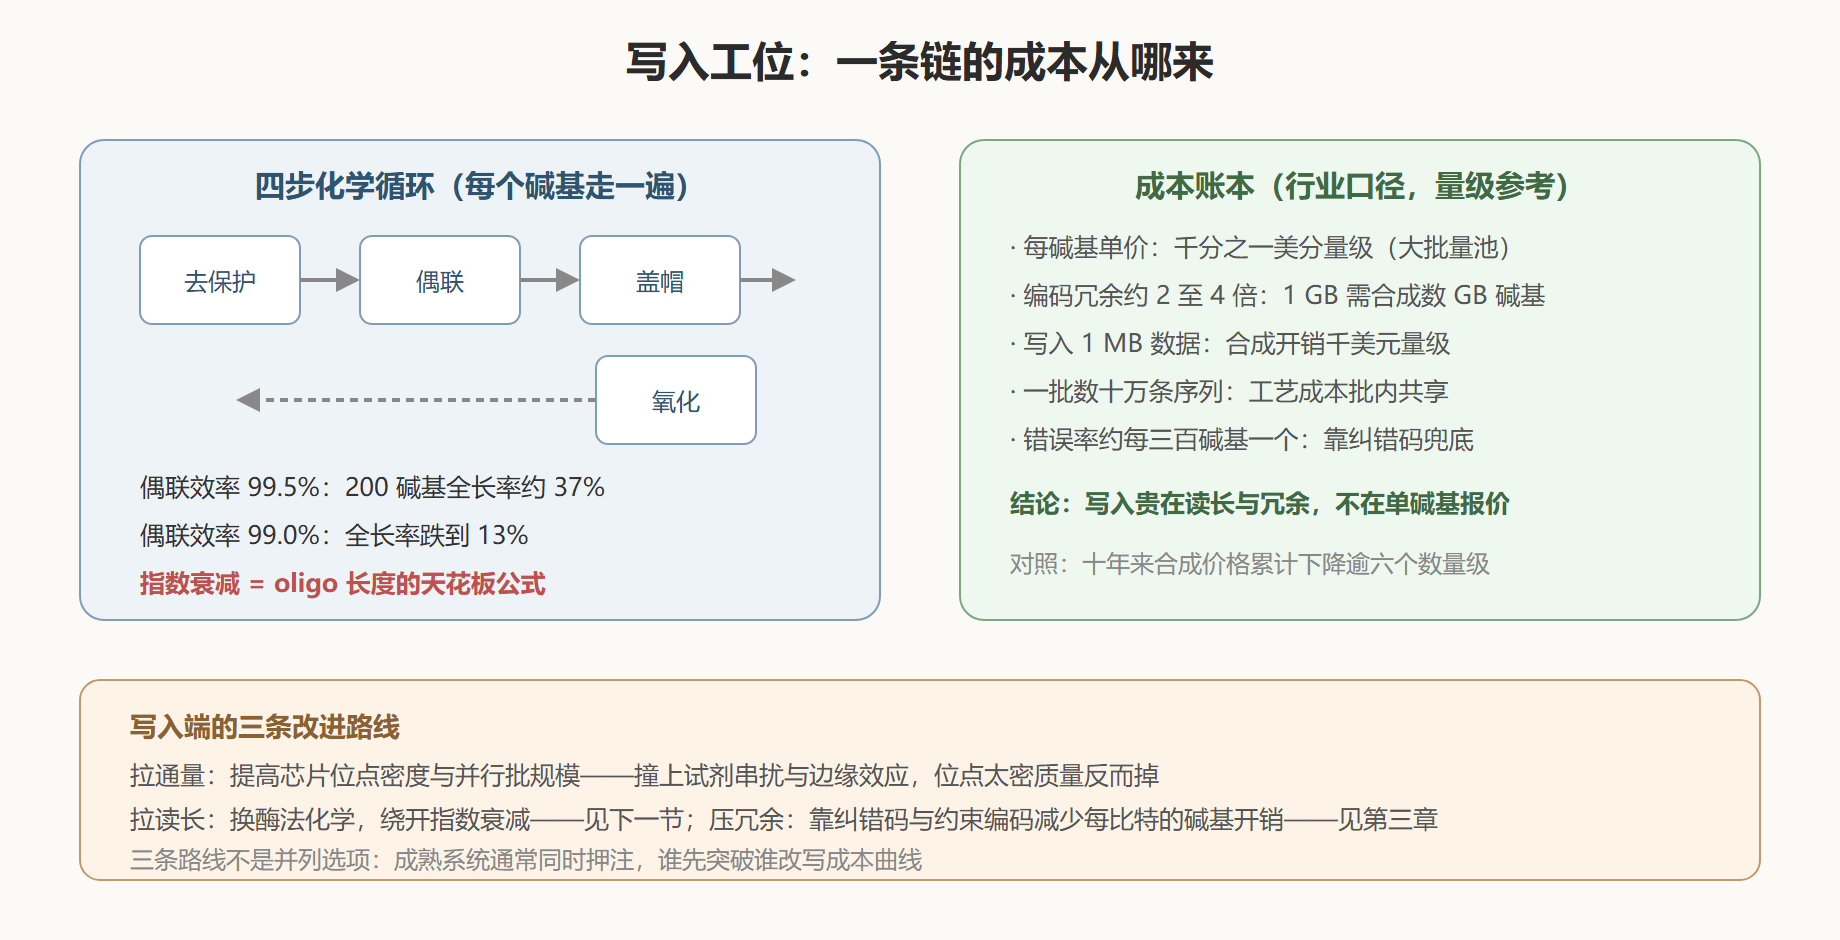
主流的亚磷酰胺合成法是一套四步循环:去保护——把链尾羟基的保护基脱掉,露出反应位点;偶联——加入下一个带保护基的核苷酸亚磷酰胺单体,在活化剂催化下与链尾成键;盖帽——把极少量没有偶联成功的链尾封死,防止它们继续长成错误序列;氧化——把亚磷酸三酯键氧化成稳定的磷酸二酯键。一个循环接一个碱基,链从固体载体上一节一节长出来。整条化学流水线在 1980 年代定型,今天芯片上的每平方毫米都在重复这套动作。
这套化学有个绕不开的物理属性:单步偶联效率不是百分之百。哪怕工艺把效率做到九十九点五,全长产率也按幂次衰减——合成两百个碱基的全长链,产率只有零点九九五的两百次方,约百分之三十六点七;效率掉到九十九,全长率跌到一成三出头。这条指数曲线就是 oligo 长度的"天花板公式":链越长,废品率越高,纯化成本越陡。这就是为什么十几年过去,商业合成的交付长度始终盘桓在一百到两百碱基之间——不是没人想写长,是化学不答应。
再看并行化,这是寡池经济的另一半。早期一根柱子合成一条序列,通量按"条"计;芯片级合成把位点密度提上去之后,一块芯片一批能产出数十万条定制序列,通量按"批"计。批内所有序列共享试剂与工艺步骤——去保护、偶联、盖帽、氧化对整片同时发生——因此总成本与序列数量的关系远小于线性,这就是"池"字的经济含义:摊薄到每条序列的工艺开销随批量急剧下降。
图:寡池写入管线与成本结构
再看账本:写入贵在哪
把寡池写入的账拆成三笔。第一笔是碱基账:存储数据不能裸写,编码冗余、纠错校验、索引地址都要摊进碱基数,一兆字节数据的实际合成量通常是它的几倍。第二笔是错误账:合成错误率约每三百碱基一个,以缺失为主,这决定了纠错码的最小配置与冗余倍数——错误率每恶化一档,纠错开销就上一个台阶。第三笔是批量账:单价报价建立在批量摊薄之上,小批量实验拿到的报价可能是标称值的十倍以上。
三笔账合起来的行业现状是:按现行口径,写入一兆字节数据的合成开销在千美元量级,写入一吉字节要到百万美元级。与磁带每太字节几十美元的归档行情相比,中间隔着五六个数量级的鸿沟——这就是第五章介质对决的起跑线,也是"DNA 存储适合冷数据"这一判断的数字来源。值得记住的是改善速度:过去十年合成价格累计下降超过六个数量级,若斜率保持,鸿沟的宽度是会变的。
通量上的另一组对照同样重要:写入速度。寡池一批合成以天计,吞吐折算下来每秒不过千字节量级,与磁盘每秒数百兆字节相差八个数量级。这决定了 DNA 不可能进入在线存储市场,连温数据的门槛都够不着——冷数据归档的定位由此被写入通量的物理现实锁死。
要点回顾
- 亚磷酰胺四步循环是写入端的化学底盘;偶联效率的指数衰减给出全长产率公式,是 oligo 长度停留在百碱基量级的根本原因。
- 寡池经济的本质是批内共享工艺:序列数量暴涨而工艺步骤不变,单价随批量急剧摊薄。
- 写入成本=碱基账、错误账、批量账之和:现行口径写入一兆字节在千美元量级,与磁带相差五六个数量级,但十年降了六个数量级的斜率不容忽视。
- 写入通量每秒千字节量级的现实,把 DNA 的战场锁定在冷数据归档,这是物理约束而非策略选择。
常见追问
合成错误长什么样,能提前预测吗? 主流错误是缺失——某个循环偶联失败,盖帽又没能及时封住,链就此少了一个碱基;其次是替换与截短。错误率约每三百碱基一个,且与序列上下文相关:GC 失衡区、同聚物边缘、修饰位点附近概率上浮。提前预测靠的是"序列难度模型"——用历史批次数据训练出的统计模型给每条序列打难度分,编码器据此绕开高危模式,或为高危序列多排一份冗余。预测不能消灭错误,但能把错误的分布从不可控变成可预算。
为什么不能把 oligo 做长一点来摊薄索引开销? 这正是全行业的愿望,而化学不配合。回顾那条指数曲线:偶联效率九十九点五时,两百碱基全长率约三成七,三百碱基只剩一成三——链越长,废品占比越高,纯化成本与错误率同步上扬。在化学框架内加长是负收益,出路只有换化学:酶法与半导体路线的核心卖点,都是把这条衰减曲线的斜率打平。读长战争是写入端的主战场,第四章其余两节与第六章都会回到它。
数字备忘
再补三组数字完善写入端的账。批量:商业寡池单批可交付数十万条定制序列,交期以周计,小批量报价可达标称单价的十倍——这是学术实验与产业报价常见的鸿沟。错误结构:缺失约占合成错误的大头,替换次之,截短链靠纯化去除;每三百碱基一个的量级十年间改善缓慢——化学循环的物理极限就在附近。库存寿命:合成好的寡池冻干态常温可存数年,归档必须转封装态——这也是为什么写入工位的产出只是半成品,第四章的保存科学才是它的下一站。
补充账目
给写入账再补一笔容易被忽略的科目:设计周转。寡池是按批生产的,从提交序列清单到收到冻干产物,交期以周计;这意味着每一次编码迭代、每一轮参数调整都要付出整批的时间成本。对一次性的归档写入这无关痛痒,对研发阶段却是主要摩擦——它解释了为什么本领域的编码研究者普遍练就了"一次设计、周密仿真、少轮迭代"的工作习惯,也解释了为什么仿真器与错误模型在这个领域格外受重视:算得准的团队,才等得起正确的批次。
三句话备忘
自测一问:偶联效率若从九十九点五提到九十九点八,两百碱基的全长率从三成七涨到多少?约六成七——效率零点三个百分点的改善,换来产率近一倍的提升。这就是为什么合成厂商在工艺上锱铢必较:指数曲线面前,每个千分之一都值钱。
一句话记化学:四步循环定精度,偶联效率定读长,批内共享定价格。一句话记瓶颈:通量与读长互相锁死——位点越密越难做长,链越长废品越多。一句话记出路:单碱基报价已经白菜化,下一轮降本只能来自读长突破与冗余压缩,这正是随后两节与第三章接力的话题。
化学法的长与贵已经看清,挑战者正在门口:用聚合酶把碱基逐个"打印"出来的酶法合成。下一节看这条路线的原理与现状。