4.2 酶法写入:让聚合酶打印DNA
4.2 酶法写入:让聚合酶打印DNA
本节摘要:酶法合成(enzymatic DNA synthesis)用末端转移酶等聚合酶在水相温和条件下逐个添加碱基,试图绕开化学法的长链衰减与有机试剂负担。2018 年后这项技术从论文走向创业公司与商用仪器,读长潜力与水相工艺是它的两张牌,可控性与成本是它的两道坎。本节拆解其原理、演化节点与对存储管线的影响。
从一个不对称说起
化学法与酶法之间存在一个历史性的不对称:读端早就用上了酶——测序仪里的聚合酶一秒能掺入成百上千个碱基;写端却一直靠有机化学的四步循环,一个碱基一个循环地磨。这个不对称让不少研究者心里不平:既然聚合酶在细胞里每秒钟复制上千个碱基还自带校对,为什么不能让它替我们"打印"序列?
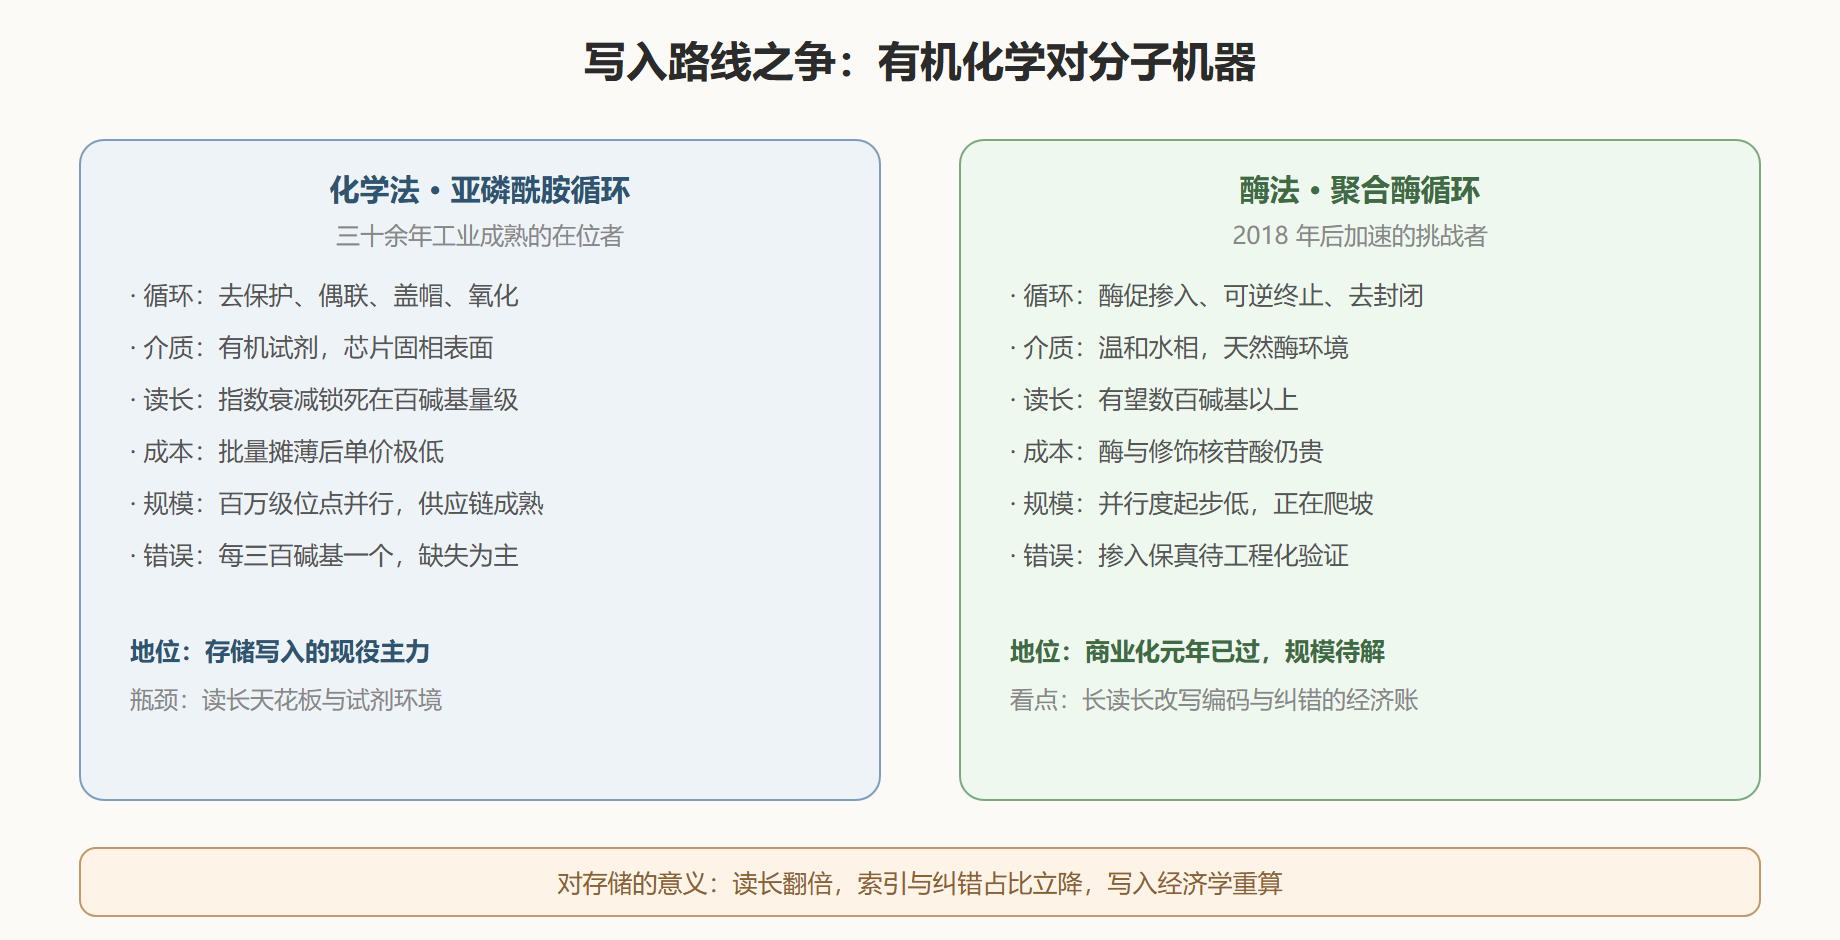
答案在于控制问题。细胞里的聚合酶照着模板链抄写,抄什么由模板决定;而合成存储需要无模板的从头合成——决定"下一个加哪个碱基"的不是模板,而是我们的编码意图。要让酶听话,就得在"加什么"上做手脚。早期方案用可逆终止的核苷酸类似物:给碱基装上封闭基团,酶每加一个碱基链就停住,洗掉试剂、定位、去封闭,再加下一个——把化学法的四步循环换成了"酶促掺入加可逆终止"的新循环。这套思路的化学步骤更少、条件是温和的水相,理论上读长不再受偶联效率的指数衰减制约——酶对百碱基以上的链照样勤恳,长序列合成的天花板有望被大幅推高。
图:化学法与酶法写入的路线对比
演化节点:从论文到商用仪器
这条路线的产业化速度超出多数人的预期。2018 年,用末端转移酶做模板无关延伸的方案在顶级期刊连发数篇,证明了可控掺入的可行性;随后多家创业公司围绕不同酶策略立旗:有的押注可逆终止核苷酸,有的押注酶与偶联剂化学,有的直接改造酶本身——用蛋白质工程给末端转移酶装上"底物偏好开关",让不同突变体只认特定碱基。2020 年前后,头部玩家发布了面向实验室的台式酶合成仪,把"水相、常温、无有机废液"作为卖点;到 2022 年之后,数百碱基的合成读长已进入公开演示的视野。
用历史视角看,酶法正在重演测序技术的老剧本:新原理刚出现时通量与成本全面落后,但参数曲线的斜率更陡。化学法三十年的工艺护城河——位点密度、试剂供应链、良率数据——不是几年能追平的;但酶法一旦在长读长上站稳,整个编码经济学就要重算:oligo 从一百碱基拉到五百碱基,索引、纠错、地址在每条链里的占比被稀释数倍,同样冗余度下的有效密度翻着倍地上扬。
对存储管线的连锁影响
酶法若成,改的不只是写入工位。其一,长读长让"文件少切几刀"成为可能,分块数量下降,索引总量下降,随机访问的地址池压力同步缓解。其二,酶促掺入的错误谱系与化学缺失不同,纠错码的参数要按新信道重新整定——第三章那套语法会原样复用,但参数表要换。其三,水相工艺与常规生物实验室的基础设施天然兼容,写入工位未来的部署形态可能从"专用合成中心"变成"实验室级台式机",这对生物安全治理(第六章)是全新的命题:当写入能力像 PCR 仪一样普及,合成订单筛查那套中心化的闸门还够不够用。
冷静地说,酶法尚未证明它能在存储需要的规模上同时满足成本与保真——两条曲线的交点还没到。工程上的稳妥姿势是把酶法当作读长期权来配置:关注它每一年的读长纪录与错误率,一旦长读长稳定交付,编码方案要能在几个月内完成参数迁移。存储系统设计者的功课,不是押注某一条路线,而是让系统对路线之争保持中立。
要点回顾
- 酶法合成用"酶促掺入加可逆终止"的新循环替代化学四步循环,核心承诺是绕开偶联效率的指数衰减、把读长推向数百碱基以上。
- 路线分化体现在酶策略上:可逆终止核苷酸、末端转移酶工程化改造各有拥趸,2020 年前后台式酶合成仪已进入实验室。
- 读长是存储经济学的杠杆:读长翻倍,索引与纠错的占比被稀释数倍,有效密度与写入成本同步改善。
- 系统设计者的正确姿势是路线中立:约束编码与纠错语法保持可迁移,等参数曲线的交点自己走过来。
历史旁注:一场迟到的公平
enzyme 路线的 supporter 常抱怨历史不公:聚合酶明明是分子世界里最快的书写机器——细胞内每秒掺入上千碱基还自带校对——却直到最近十年才被认真当作合成工具。迟到的原因是控制,不是性能:化学法的问题是一步步太慢,酶法的问题是它太快、且不听指挥。可逆终止核苷酸相当于给酶装了刹车,酶工程改造相当于换了司机的偏好——两条路都是先让酶"慢下来听话",再谈快。这个"先驯服再提速"的剧本,与测序行业的单分子实时路线如出一辙:后者同样花了十几年把聚合酶的动力学驯服到工程可用。
给学习者一个跟踪这条路线的观察清单:一看长读长纪录——公开演示的最长交付长度,它决定编码经济学的改善斜率;二看保真数据——每千碱基错误数及其谱系,它决定纠错参数要不要换表;三看并行规模——单台仪器同时合成的序列数,它决定通量能不能进入存储的量级。三条曲线任意一条跳变,都值得回来重读本节。
数字补遗
补三组便于跟踪路线的数字口径。读长口径:化学法的商业交付长期在百五十碱基上下,酶法公开演示已越过数百碱基线——两者交汇的那天,存储 oligo 的名义长度大概率直接翻倍。保真口径:化学法每三百碱基约一个差错且缺失为主,酶法的掺入差错谱系以替换为主——谱系不同意味着纠错参数可以分别调优,而不是简单类比。成本口径:酶试剂与修饰核苷酸目前仍是化学单体的数十倍价差,但它摊薄的对象是"每碱基反应步骤"而非"每碱基原料"——量级走向取决于工艺放大,这正是要年年复查的原因。
三句话备忘
自测一问:如果酶法把交付读长推到五百碱基,一条 oligo 的名义长度翻了几倍,纯数据区占比从约一半涨到几成?名义长度三倍多,纯数据区占比能到七成上下——索引与引物是固定开销,读长越长摊得越薄。这道算术就是"读长是写入经济学第一杠杆"的全部秘密。
一句话记原理:可逆终止给酶装刹车,酶工程改造换司机的手——先驯服,再提速。一句话记现状:读长纪录持续上探,保真与并行还在爬坡,商用元年已过、规模之年未到。一句话记策略:把它当读长期权配置,系统保持路线中立,参数表随时可换。
写入端看完了,把镜头转向读端:测序平台的通量与错误谱系如何决定读取策略,纳米孔又改写了哪些工艺假设。下一节讲读取通量。