4.3 读取通量:从桥式扩增到纳米孔
4.3 读取通量:从桥式扩增到纳米孔
本节摘要:读取端的账本由三组参数决定:通量、读长、错误谱系。本节按平台逐一核对——短读旗舰一轮数百吉碱基但读长受限,纳米孔读长以千计但原始错误率以百分点计——并解释这三组参数如何决定存储系统的覆盖深度需求、纠错配置与取回成本,以及"混合读取策略"为何成为工程标配。
三个决定读取策略的参数
读 DNA 与读磁盘在工程上毫无相似之处,但决策框架可以类比:你关心的都是"多快、多准、多贵"。测序语境里这三个词对应三组参数。
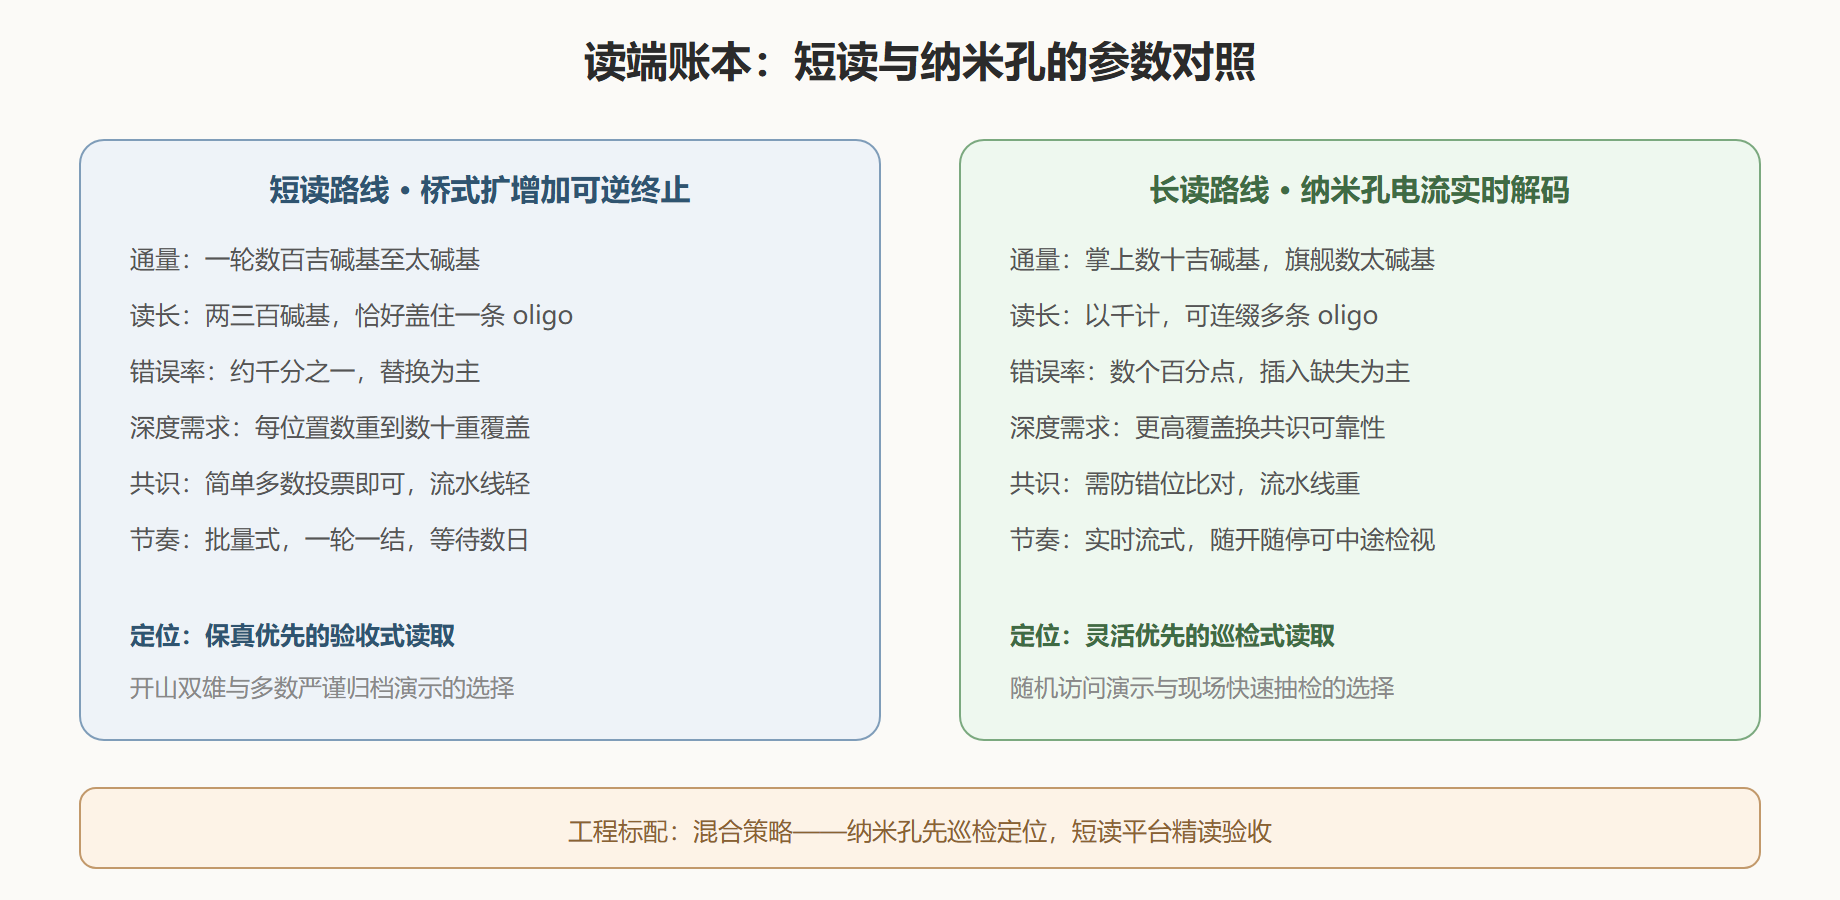
第一组是通量,即一轮运行产出多少碱基。短读旗舰平台一轮可产出数百吉碱基到太碱基量级,折算下来,读完一个太字节级的存储文库理论上只需数轮——通量本身不是瓶颈,瓶颈在后面的深度需求。纳米孔平台的通量曲线更陡:掌上设备一轮数十吉碱基,台式旗舰一轮可达数太碱基量级,且实时输出、随开随停。单看通量数字,两个平台都足以覆盖存储场景的读取需求。
第二组是读长,即单条读段的长度。短读平台受桥式扩增与光学成像的物理限制,读长稳定在两三百碱基——恰好略长于一条存储 oligo,这个"刚好够用"的匹配是开山实验选用短读平台的原因。纳米孔则完全不同:单链分子穿过多长的孔,它就读多长的序列,读长以千计甚至以万计。对存储而言,长读长打开了一种新可能:多条 oligo 连缀读出,索引与地址在每碱基里的占比被稀释。
第三组是错误谱系,也是两条路线真正的分水岭。短读平台的原始错误率在千分之一量级,且以替换为主——错一个碱基,位置不错。纳米孔的原始错误率历史上高达一成上下,近年随化学与算法迭代降到数个百分点,但错误类型以插入缺失为主——不仅读错,还会读歪:整条读段的碱基位置发生漂移。替换错一个字,插入缺失则是整段错位,对聚类、比对、共识的影响完全不同。第三章解码工程里"噪声画像决定流水线参数"的论断,源头就在这里。
图:两条读取路线的能力雷达
深度需求:取回成本的第二根杠杆
通量数字容易让人乐观,真正的成本公式里还有一个乘数:覆盖深度。一条 oligo 要被测到几遍才能可靠还原?答案是它错误率的函数:错误率千分之一时,几重覆盖的多数投票就足够;错误率百分之五时,要么堆覆盖深度稀释随机错误,要么升级共识算法硬啃错位。两个平台的深度需求因此相差一个数量级,取回同样一份数据,测序的绝对碱基量也随之相差一档。
把账连起来算:存储 oligo 的有效负载里,数据只占一部分,其余是索引、引物与纠错冗余;读回时要为每个位置付出深度倍的碱基成本;纳米孔路线读长虽长,深度需求又把省下的补了回去。所以"取回一份数据要多少钱"这个问题的答案,从来不取决于单平台通量,而取决于编码冗余、深度需求与平台单价三者的乘积——第六章成本史会把这三个乘数的历史曲线逐一画出来。
混合策略与未来的读端
工程实践里两条路线不是对手而是搭档。典型流程:归档数据封装后进库,例行巡检用纳米孔——实时、便携、抽检几个文件确认分子状态;正式取回或审计验收用短读平台——保真高、共识轻、校验链路成熟。这套"巡检用长读、验收用短读"的混合策略,正在成为归档系统的默认配置。
读端的下一个变量是原位读取:不把 DNA 从封装介质里提取纯化出来,直接对着微球或芯片测序。提取纯化环节的分子损失与偏好性是现行流程的隐性成本,若原位读取成熟,取回流程将再砍掉一道工序。与之相配的还有压缩感知式的读取思路——不把文库测穿,只测到满足纠错容量为止,让深度需求跟着纠错码的冗余结构动态收缩。这些方向都还年轻,但共同指向一个趋势:读端正从"标准化的生物流程"变成"可按需定制的系统部件"。
要点回顾
- 读端决策框架是通量、读长、错误谱系三参数:短读平台保真高读长短,纳米孔读长千碱基级但插入缺失为主。
- 覆盖深度是取回成本的第二根杠杆,两个平台的深度需求相差一个数量级,单看通量数字会误判成本。
- 取回成本等于编码冗余、深度需求、平台单价三者之积;优化必须算乘积,不能只盯一个因子。
- 混合策略是工程标配:纳米孔做实时巡检,短读做验收精读;原位读取与按需深度是读端的下一个变量。
常见追问
为什么取回一份数据要测这么多遍? 因为测序读段是"草稿"而不是"定稿"。单条读段的错误率决定了它不可单独信任,共识机制要求每个位置有多票支撑;错误率越高,需要的票数越多。短读平台千分之一错误率下,每个分子测到数遍即可投票;纳米孔数个百分点错误率下,票数要上一个数量级,还得先解决插入缺失导致的票面错位。覆盖深度不是浪费,是把"单读段不可信"修正为"共识可信"的必要冗余——它本质上是把纠错的活儿分了一半给统计学。
纳米孔的实时性对存储有什么实际价值? 比想象中大。批量式平台要等整轮跑完才能结算数据,纳米孔可以边测边看:巡检场景里,读够验证所需的数据量即可停机,深度按需而非按轮;应急场景里,几分钟内先拿到部分读段,判断文库是否完好的初检可以在提取后立刻开始。对归档系统,实时性改变的不只是速度,还有运维模式——巡检从"排期的大事"变成"随手的抽查"。
读长变长后,编码要跟着改吗? 要,但改的是参数不是语法。长读让多条 oligo 连缀读出,聚类与共识可以按"连缀组"而不是单条做,深度需求在组内摊薄;地址的解析方式也要适配连缀边界。第三章那套语法——聚类、共识、纠错、重组——原样成立,参数表换一版即可。这正是语法与参数分离设计的回报。
补充账目
读取端还有一笔隐性账:建库。测序前要把 DNA 加接接头、加索引、做扩增,这套文库制备在存储场景里同样要跑,工时与损耗都计在取回成本里;纳米孔流程虽省了扩增,接头与纯化仍在。原位读取之所以诱人,正是因为它许诺把整笔建库账从流程里划掉。在此之前,评估取回成本请记得用"三段式":制备、测序、解码——只看测序单价的对比表都会失真。这笔账在第六章的成本曲线里还会出现一次。
三句话备忘
一句话记短读:保真高、读长短、共识轻,验收精读的正选。一句话记纳米孔:读长长、实时流、插入缺失多,巡检抽读的正选。一句话记成本:通量乘深度乘单价才是取回总账,只盯任何一个因子都会算错。
写与读的工位都摸清了,中间还缺一环:分子在两次访问之间如何活过十年百年?下一节讲保存科学——脱水、封装与半衰期工程。