3.4 解码工程:从噪声读回原始文件
3.4 解码工程:从噪声读回原始文件
本节摘要:解码是编码的逆过程,却远比逆过程复杂:测序读段带插入、删除、替换三类噪声,整条 oligo 可能丢失,海量子序列要在没有参考基因组的情况下聚合成簇、合成共识、纠错验收,最后重组为原始文件。本节按回程的四个阶段拆解整条流水线,并指出每个阶段最容易引入不可逆损失的位置。
回程比去程难在哪
去程是确定性计算:给定文件,编码器输出的碱基序列唯一且可复现。回程面对的是另一个世界:测序仪吐出的是数以百万计的短读段,每条读段与设计序列相比都有零点一到一成的差错——短读平台的替换为主,纳米孔平台的插入缺失为主;部分设计序列可能根本没被测到;每条读段也不知道自己属于谁,除非先读懂它的地址区。去程是从一行字节到一列碱基,回程是从一锅带噪分子汤到一份校验通过的文件——这不是简单的反向查表,而是一条独立的工程流水线。
把这条流水线讲透之前,先锚定一个反直觉的事实:解码消耗的算力常常超过编码几个数量级。归档场景里写入一次、读取一次,读取端的聚类、比对、共识、纠错全部是大数据操作,这个成本结构直接影响了后面章节的系统设计——解码端值得优化,因为它决定"取回一次"的真实代价。
流水线四阶段
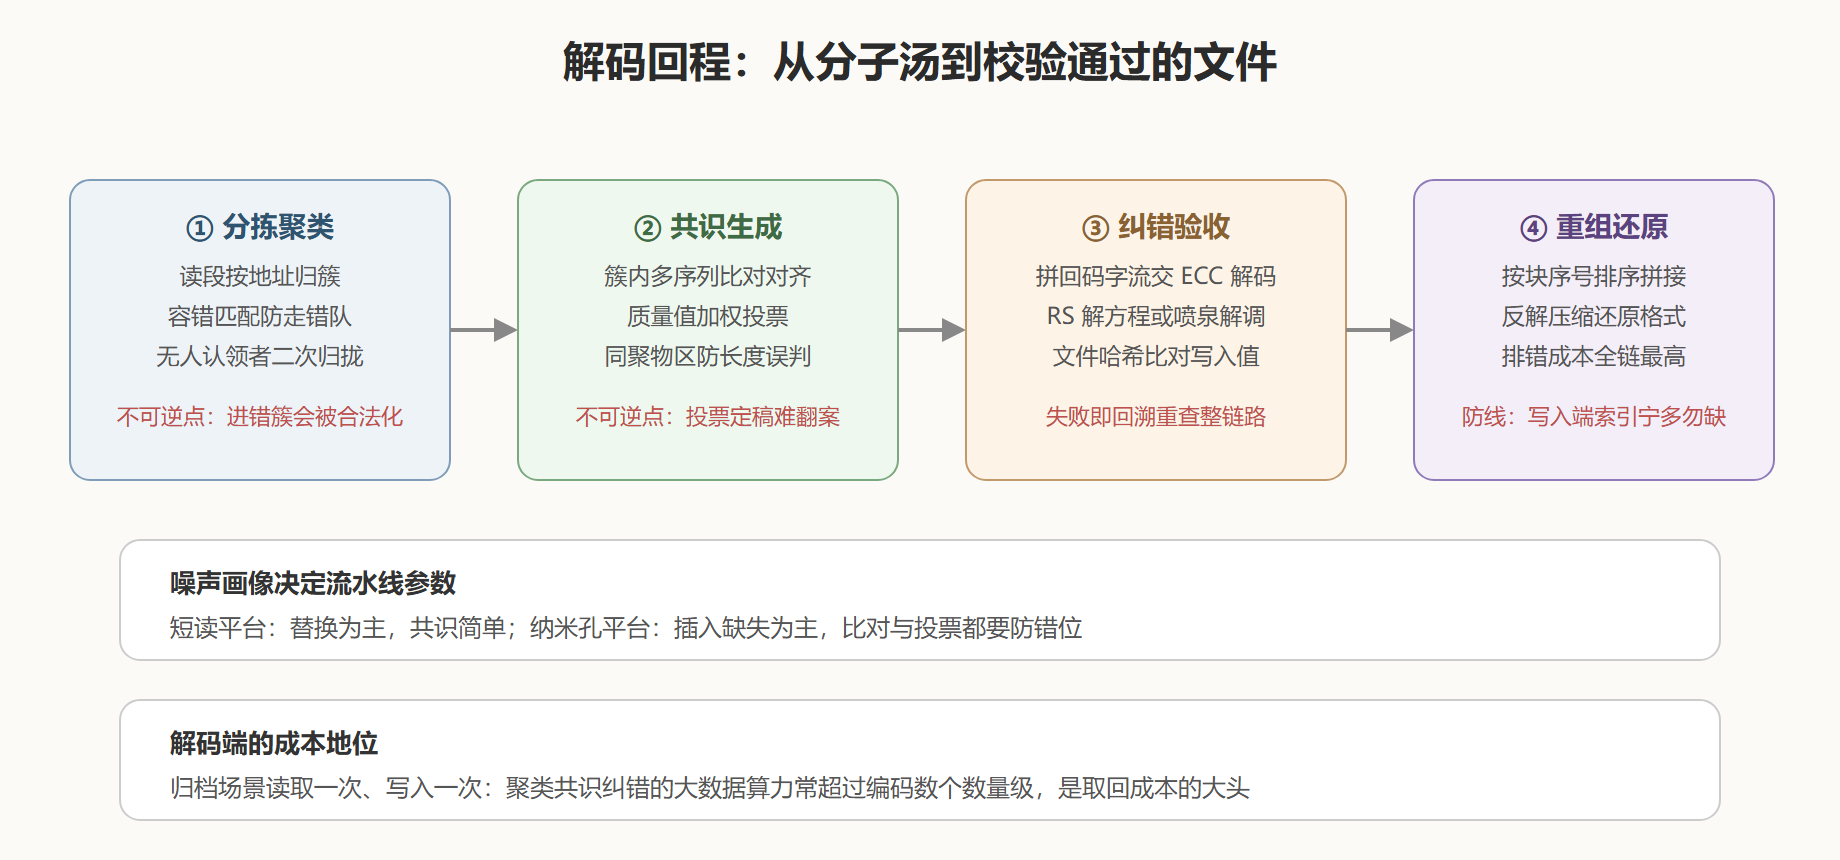
第一阶段:分拣与聚类。读段进来先按地址区归堆,同一地址的读段聚成一个簇,每个簇对应一条设计序列。听着简单,坑在低质量读段:地址区自身带错时,读段会走错队伍。工程做法有两层,一是允许模糊匹配的容错分拣,二是对无人认领的读段做二次归拢——用内容区与前缀的相似度做二次聚类。聚类是整条流水线的第一处不可逆点:一旦读段进了错误的簇,后续共识只会把这个错误"合法化"。
第二阶段:共识生成。同一个簇里几十上百条读段各带各的错,要合成一条"多数派序列"。朴素多数投票在高覆盖度下够用,但有两个盲区:插入缺失错误会让读段之间错位,投票投的不是同一位;纳米孔的同聚物区信号展宽,会让长度本身成为分歧点。成熟方案先做多序列比对把读段对齐,再做加权投票——权重来自测序质量值,高置信碱基话语权更大。共识是第二处不可逆点:投票一旦定稿,单条读段再翻案就难了。
第三阶段:纠错验收。共识序列按索引拼回码字流,交纠错码解码——里德-所罗门码字级纠错、喷泉码的置信传播解调,各按门派流程走。这一阶段的产出要过两道验收:纠错码自身的校验方程全部成立;顶层文件的哈希校验和与写入时一致。哈希不过关,说明上游某处引入了纠错容量之外的损伤,整条链路要回溯重查。
第四阶段:重组与还原。码字按文件内的块序号排序、拼接,反解压缩,还原为原始格式。这一步最平淡也最容易麻痹:块序错乱、重复块、缺块都是常见事故,靠的是写入端索引设计的完备性——语法奠基期的共识是"索引宁多勿缺",因为重组阶段的排错成本是所有阶段里最高的。
阶段一 分拣聚类:读段 → 按地址归簇(容错匹配 + 二次归拢) 阶段二 共识生成:簇内比对对齐 → 质量值加权投票 → 共识序列 阶段三 纠错验收:码字流 → ECC 解码 → 哈希校验比对 阶段四 重组还原:块序排序 → 拼接 → 解压 → 原始文件
图:解码回程四阶段流水线
一个反直觉的优化方向
既然解码端是成本大头,优化自然会往那里倾斜,领域里因此出现了一个反直觉的设计原则:把复杂度从解码端挪回写入端。做法包括:写入时增加 oligo 冗余倍数,换取读回时聚类与共识的容错余量;给每条序列附加内容校验段,让分拣阶段就能识别走错队伍的读段;甚至预先计算"期望读段指纹",解码时按指纹快速配对。这些手段全都吃写入密度与成本——又一次印证了本节的母题:语法的每个部件都在互相买卖,账要算总账。
对学习者的实操建议:解码工程是四个部件里最适合动手复现的。公开数据集上有带标注的测序读段,用一门顺手的高级语言实现"分拣—投票—纠错—重组"的极简版,跑通一遍胜过读十篇综述——你会亲身遇到"进错簇""同聚物错位"这些纸面上毫无感觉的坑。
要点回顾
- 解码不是反向查表而是独立流水线:分拣聚类、共识生成、纠错验收、重组还原,四个阶段各有一处不可逆损失点。
- 噪声画像决定流水线形态:短读平台替换为主、共识简单;纳米孔平台插入缺失为主,比对与投票都必须防错位。
- 哈希校验是全链路的最终裁判:不过关即回溯,这把"可审计性"从写入端一路贯通到读取端。
- 解码端是取回成本的大头,优化方向是复杂度前移到写入端——密度换算力的交易贯穿始终。
常见追问
解码失败最常见的原因是什么? 不是算法不够聪明,而是输入分布超出假设。最常见的三类事故:覆盖深度不足——某些 oligo 只被测到一两次,共识投票没有 majority 可投;地址区带错——读段进了错误的簇,共识序列看似正常实则张冠李戴;丢失率超出纠错容量——设计时按百分之一丢失配的校验符,实际批次丢了百分之三。三者里只有第一类能用多测解决,后两类都要回到编码与索引设计去修——所以解码工程的功夫,一半在写入端。
为什么不用人工智能端到端地做解码? 正在试,但要冷静。聚类与共识环节已经有基于学习的模型在探索,对纳米孔信号的去噪也有成效;但归档场景对"可审计"的要求与端到端黑箱天然紧张——验收报告需要解释每个比特为什么可信,纯神经网络的输出目前给不出这条证据链。务实的格局是分层混合:信号层与比对层用模型提效,码字层与验收层保持代数可验证。这个格局短期内不会反转。
解码端可以做成通用软件吗? 趋势如此。早期每个团队的解码脚本自用自弃,后来开源社区出现了把分拣、共识、纠错封装成流水线的通用工具,参数按信道档案加载。通用化的意义不止省事:它让编码方案与解码实现解耦,让第三方可以独立验证一份文库的可读性——这正是标准化的前奏,与 6.2 节的注册制一脉相承。
追问补遗
共识投票用中位数还是众数? 都不是——用的是质量值加权的贝叶斯后验。每条读段的每个碱基都带置信分,投票不是数人头,是按置信度折算权重;对纳米孔读段还要先过信号级的再校准。这套机制解释了为什么同样五重覆盖,短读平台与纳米孔平台的共识可靠性差一大截:不是票数不同,是每票的含金量不同。
验收报告应该包含什么? 行业正在收敛的共识字段:批次标识与编码参数注册号、覆盖深度分布、共识后的残余错误率、纠错码的校验结果、顶层哈希比对结论、巡检抽样的记录。把这份清单记住,将来拿到任何一份"可验证归档"的合同,都能一眼看出对方承诺的是真验收还是走过场。
至此语法奠基期四个部件全部就位。下一章管线闭环:合成、保存、读取、解码如何在 2018 到 2021 年间被焊成一条全自动流水线。