3.3 碱基约束:与分子物理的谈判
3.3 碱基约束:与分子物理的谈判
本节摘要:碱基约束是编码与分子物理之间的契约:GC 含量控制在四成到六成、同聚物长度受限、规避发卡与回文结构。本节讲清这三条规则各自的化学成因、常见阈值,以及约束对编码空间的收缩效应——理论上每碱基两比特的密度,在约束过滤后往往要折价,而约束的宽严随读写装备的演进而不断重谈。
规则从哪里来
任何一条碱基约束,背后都是一类会在湿实验里咬人的化学现象。把它们逐条对应起来,语法就不再像咒语。
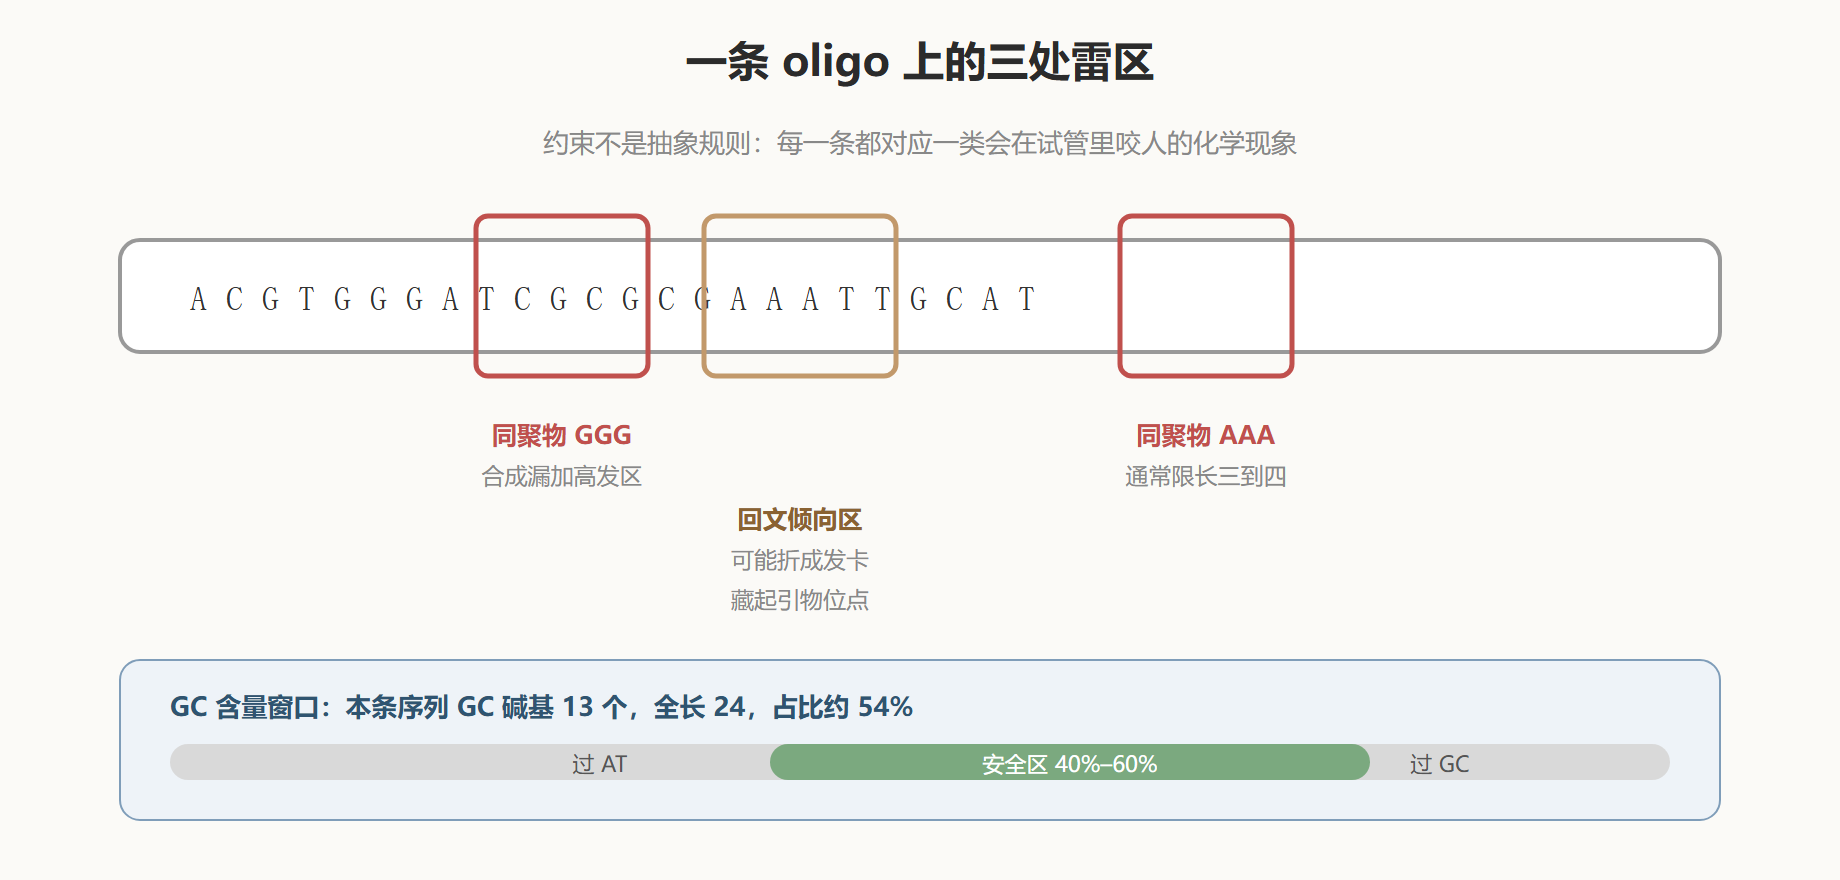
第一条,GC 含量。G 与 C 之间是三根氢键,A 与 T 之间只有两根。序列里 GC 比例过高,双链结合得过于牢固,PCR 扩增与测序的变性步骤解不开链,产物锐减;比例过低,链又绑不牢,特异性丢失。合成化学对这条曲线格外敏感:GC 失衡区的偶联效率明显偏离均值。所以编码时通常要求每条 oligo 的 GC 含量落在百分之四十到六十的窗口内,严格的方案甚至要求每个滑动窗口都达标。
第二条,同聚物长度。连续相同碱基是合成的坑:每个循环都有少量漏加,同聚物区段漏加后长度失真,且失真无法被后续反应纠正;对测序而言,同聚物更是传统重灾区——早期焦磷酸测序平台靠信号强度数碱基个数,四五个连排以上就开始数错。于是约束通常规定同聚物长度不超过三或四。有意思的是,这条规则正随装备演化而松动:纳米孔的电流信号对同聚物的分辨能力随化学升级持续改善,约束自然放宽——这是"约束与装备共进化"最直观的例子。
第三条,二级结构。单链 DNA 会跟自己玩配对:回文区段折叠成发卡,序列间互补则抱团成双链。发卡一旦形成,引物结合位点被藏进茎环里,扩增与测序双双失灵。约束上要求规避长回文与高互补区段,正式的方案会对每条候选序列做折叠自由能预测,不达标即弃。
图:三条约束在一条序列上的落点
约束的代价:编码空间收缩
约束不是白给的,每一道约束都在收缩可用的编码空间。做个量级估算:一条一百碱基的 oligo,理论上有一千六百种可能序列中挑四种的三百次方种组合;加上同聚物不超四、每窗口 GC 限幅、无长回文之后,存活序列的比例大幅下降。有研究对随机生成的八十碱基序列做过统计:不加工直接映射的比特流,能同时满足全部约束的比例不足百分之一。换句话说,若不做任何设计,九成九的候选序列会撞上雷区。
工程上有两种应对。其一是过滤重试:普通映射之后逐条检验,不合格就换一种映射再试,实现简单,代价是索引区外还要挂上重试种子,且高约束密度下重试次数暴涨。其二是约束感知编码:把约束直接编进码本或生成算法——戈德曼的三联体码本里根本没有同聚物,喷泉码在生成水滴时就丢弃触碰约束的组合。前者像事后质检,后者像源头工艺,成熟方案清一色走向后者。此外还有第三条路:转置与打散——先把比特流做矩阵转置,让相邻比特分散到不同 oligo,从统计上改善碱基分布,成本几乎为零。
约束还会随装备演化而重谈。合成端从柱式到酶法,读端从短读到纳米孔,每换代一次,各条约束的宽严就要重新校准:纳米孔时代同聚物限长放宽了,但碱基修饰敏感性上升,新约束随之登场。所以成熟系统会把约束参数做成可配置的"信道档案",而不是硬编码在编码器里——写编码器的人为合成仪写一份档案、为纳米孔写另一份,同一份数据可以按目标信道重新编码。
要点回顾
- 三条核心约束各有化学成因:GC 含量对应氢键数与变性动力学,同聚物对应合成漏加与测序计数失真,二级结构对应发卡屏蔽引物位点。
- 无约束映射的候选序列几乎全线撞雷——满足全部约束的比例不足百分之一,约束感知编码因此成为主流而非可选项。
- 约束本质是编码空间对分子物理的折价:每道约束都在吃密度、吃搜索空间,工程任务是让这笔折价最小且可配置。
- 约束与装备共进化:合成与测序每换代一次,约束的宽严就重谈一次,成熟系统以"信道档案"管理约束参数。
常见追问
约束的阈值是全世界统一的吗? 不是,阈值跟着平台走。同聚物限长:短读平台时代常见上限是三到四,纳米孔平台的更新化学下可以放宽到五甚至更多;GC 窗口:多数方案取百分之四十到六十,对纳米孔通道可以适度收窄以换取信号质量;二级结构判定:取决于折叠预测算法的版本与温度参数。所以严谨的编码器从不硬编码阈值,而是读一份"信道档案"——这也是 6.2 节标准化里"参数族注册制"的技术根源。
约束之间会打架吗? 会,而且常打。最典型的冲突:为满足 GC 窗口需要插入更多 G、C,而纠正同聚物需要打散连续碱基,两个目标在序列末端的自由度上互相挤压;再比如惰性约束(6.3 节的避开始密码子与启动子核心)会与霍夫曼码的最优分配冲突,必须用受约束的码本重排。工程上的解法是优先级排序加可满足性搜索:硬约束(同聚物、惰性)不许破,软约束(GC 窗口的精度、压缩率)允许折价——约束工程的一多半功夫,花在给约束排序上。
数字备忘
记三组数字感受约束的分量。随机生成的八十碱基序列,同时满足全部常规约束的比例不足百分之一——不做约束感知设计的方案,九成九的序列要重试。一条一百五十碱基的存储 oligo,索引与引物区合计约五十碱基,纠错与校验再占两三成,纯数据区常常只有一半——约束不是唯一吃密度的,但它是第一张嘴。约束感知编码的搜索开销:生成一条合格序列的尝试次数通常在个位数到十位数之间,工程上完全可接受——这是"源头工艺"优于"事后质检"的量化证据。
追问补遗
为什么不等合成端自己解决约束? 有人这么主张:合成仪升级后,同聚物与 GC 失衡的耐受性都在改善,编码器何必自我设限。反驳来自账本:约束满足在编码端几乎免费——码本设计或生成时过滤,一次性的计算开销;而合成端的耐受性提升要摊在每一个批次、每一台仪器上,且从未降到零。把约束放在源头,是"一处成本换处处成本"的典型划算交易,这也是约束感知编码稳居主流的根本原因。
约束清单会不会无限膨胀? 会有压力,但有收敛机制。每加一条约束都在收缩编码空间,收缩到某个程度后搜索开销与密度损失会反过来惩罚过度约束;工程实践因此形成了一个隐性的准入门槛——新约束必须证明它拦住的风险大于它吃掉的密度。生物惰性约束(6.3 节)能过这个门槛,因为它对冲的是监管风险;而多数花哨的微调约束过不了。清单在膨胀,膨胀得很挑剔。
纠错管修复、寻址管定位、约束管合规,三件套就位后还剩最后一环:当测序仪吐出海量带噪读段,如何一步步还原出原始文件?下一节讲解码工程的完整回程。