5.3 混合存储架构:冷数据的梯队部署
5.3 混合存储架构:冷数据的梯队部署
本节摘要:混合存储架构把磁盘、磁带与 DNA 编成梯队:热数据在闪存与磁盘,温冷数据下沉磁带,最深层的百年归档交给 DNA。本节讲清梯队的分层依据(访问频率与保存年限)、层间迁移的触发条件与调度器的设计要点,以及 DNA 层融入机房的两个前提——语义驱动的分层元数据与生物原生的访问接口。
分层的依据不是温度,是数据的生命周期
存储行业习惯用"冷热"描述数据,这个词容易误导:温度的本质是访问频率随时间衰减的曲线。一份影像诊断记录,产生当天访问频繁,一个月后近乎归零;一份科研原始数据,论文发表前被反复读取,发表后十年无人问津。分层系统的正确姿势是按生命周期建模:数据的访问频率何时跌破阈值、保存义务有几年、合规要求是否强制留存——这三问决定它在梯队的初始位置与下沉节奏。
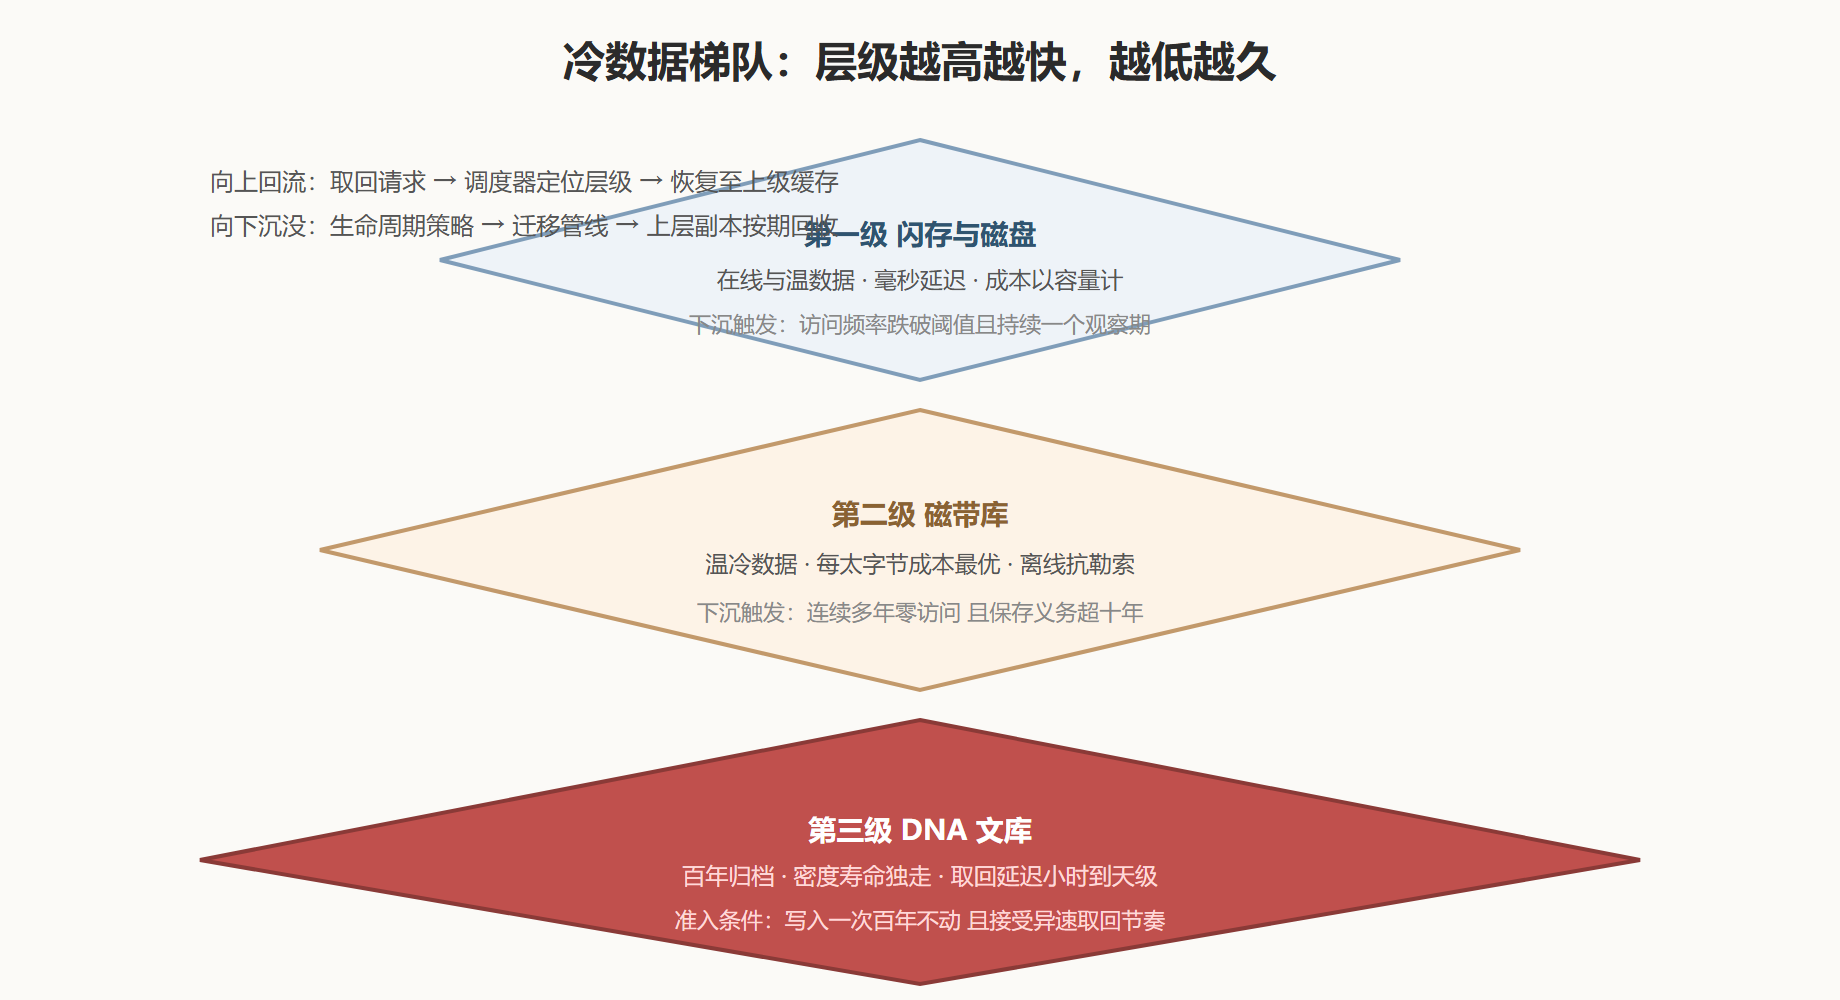
三级梯队的分工由此明确。第一级闪存与磁盘:承接在线与温数据,追求毫秒延迟,成本以容量计价。第二级磁带库:承接确定不再活跃但未来可能访问的数据,追求每太字节成本与离线安全(磁带离库即物理隔离,天然抗勒索软件)。第三级 DNA 文库:承接"写入一次、读取近零、保存以十年百年计"的深层归档——物种资源库、国家级档案、文明级快照。注意第三级的准入条件最苛刻:不仅访问频率要低到可忽略,还要求接受小时级到天级的取回延迟——DNA 层不是慢速磁带,而是另一个时间尺度的柜子。
图:三级梯队与迁移触发条件
调度器:梯队的大脑
梯队不是三个柜子并排,而是一台带策略引擎的调度系统。调度器维护每个数据对象的生命周期档案:创建时间、访问历史、保存义务、合规标签、副本分布。策略引擎按这些字段持续决策:谁该下沉、谁该回收、谁在触碰下沉条件边缘。工程上有几个要点。其一,下沉是单向倾斜而非单向锁定——DNA 层的取回虽慢,仍要支持"异常唤醒",调度器必须保留把深层对象拉回上层缓存的能力,只是这次拉回要走完提取、富集、测序、解码的完整回程。其二,迁移要有账:每次下沉与回收都改变总拥有成本的构成,调度器要把介质单价、迁移工时、保存能耗折算成同一货币再比较。其三,合规是硬约束:受监管数据可能有"不可离域""不可解密期"等标签,策略引擎对这些标签只有服从权,没有优化权。
对 DNA 层还有一项特殊调度逻辑:批量打包。分子写入的批处理特性决定了它不适合零散小文件的逐个搬运——工程上的做法是把进入第三级的对象聚合成"归档包裹",统一编码、统一封装、统一登记索引,把写入工位的批处理红利吃满。包裹是 DNA 层的基本调度单元,就像磁带层的"盘"一样。
融入机房的两个前提
第一个前提是语义元数据。传统存储的元数据描述"这个块在哪台设备的哪个扇区";DNA 层的元数据要描述"这份归档包裹由哪些 oligo 组成、采用哪套编码参数、封装形态是什么、验证哈希是多少"。没有这套元数据,分子即使完好也读不回来——格式寿命与介质寿命要分开记账(5.1 节的伏笔在此收线)。行业共识是把元数据放在传统系统里、把数据本体放进分子里,两者以内容哈希互锁。
第二个前提是生物原生接口。不能指望存储管理员去设计引物、计算退火温度——DNA 层必须向上暴露与传统存储一致的对象接口:上传、下载、校验、列举,生化细节全部藏在接口之下。这是第四章原型机"黑箱原则"的延续:黑箱对用户是便利,对行业是标准化的前提。第六章的联盟规范正在把这个接口写成协议;在此之前,混合架构只能停留在单厂商的私有实现里。
要点回顾
- 梯队分层的依据是数据生命周期:访问频率衰减曲线、保存义务年限、合规要求三问定层级。
- 三级分工:闪存磁盘管在线,磁带管温冷与离线安全,DNA 管写入一次百年不动的深层归档;第三级准入最苛刻,取回延迟以小时到天计。
- 调度器是梯队的大脑:生命周期档案、成本统一折算、合规硬约束,加上 DNA 层特有的"归档包裹"批量打包逻辑。
- 融入机房的两个前提:语义元数据(分子完好之外还要格式可读)与生物原生接口(生化细节藏在标准接口之下)。
常见追问
数据在梯队间来回迁移,会不会得不偿失? 会,这正是调度器存在的理由。每次迁移都有搬运成本与风险敞口:读出、校验、写入、确认,任何一步中断都是一致性事故。成熟系统的做法是"迁移要冷静":下沉决策设观察期(访问频率跌破阈值并持续数月才执行)、回收决策设宽限期(上层副本删除前保留回滚窗口)、高频震荡的对象钉死在中间层。梯队的经济性不来自激进分层,来自克制的分层。
DNA 层的数据也要备份吗? 要,而且逻辑与传统介质不同。传统备份对抗的是介质损坏,DNA 封装态的备份更多对抗的是"访问事故"与"未知风险"——开箱污染、封装缺陷、编码参数遗失。异质化副本(4.4 节)在此落地为:同一归档包裹至少两套封装与编码,异地存放,元数据账本再独立备份一份在传统介质上——分子可以百年不动,账本必须天天在线。
个人或小机构现在能玩吗? 能体验,别托付。商业合成与测序服务已能让一个课题组用可控预算完成端到端的演示项目——这也是教学与原型验证的常见做法;但把生产数据正式交给分子介质,等的是标准与验收合同,不是热情。个人用户现阶段的最优解是关注第一顺位市场的公开项目——看别人怎么写验收单,是最便宜的学费。
追问补遗
DNA 层的容量怎么规划? 按归档包裹的节奏规划,不按字节需求线性规划。分子写入的批处理特性决定了产能以"批"为颗粒:一次封装若干包裹、若干年后再一批。容量规划的正确问法不是"我们需要多少 PB",而是"我们的下沉流量折算成每年几批"——批次节奏对上写入产能,梯队才转得动。这也解释了为什么 DNA 层天然适合"年度归档仪式"式的运维节奏,而不是随到随存的流水线。
元数据账本会不会成为新的单点故障? 会,除非账本本身按传统高可用架构部署。行业共识是"分子百年、账本在线":分子的可读性依赖账本里的编码参数与哈希互锁,账本丢了,分子就成了一堆无法自证的序列。所以账本要多副本、多法域、多格式保存——讽刺又合理的是,账本自身的终极备份,也许某天就是再写进一份 DNA 里。
梯队画好了,蓝图落地的三样基础设施——成本、标准、安全——正是下一章的主题。进入第六章:生态成年期。