5.2 装备演化:合成仪与测序仪的军备竞赛
5.2 装备演化:合成仪与测序仪的军备竞赛
本节摘要:DNA 赛道的基本盘由两条装备线决定:合成仪负责写入,测序仪负责读取。本节把两条线放到同一张时间轴上复盘——合成线从柱式、多孔板、芯片阵列走到半导体与酶法,测序线从桑格、短读、长读走到原位读取——并提炼军备竞赛的三条规律:借用生命科学的既有产能、通量换价格的非线性斜率、装备换代对编码语法的反向塑造。
两条线各自的代际节点
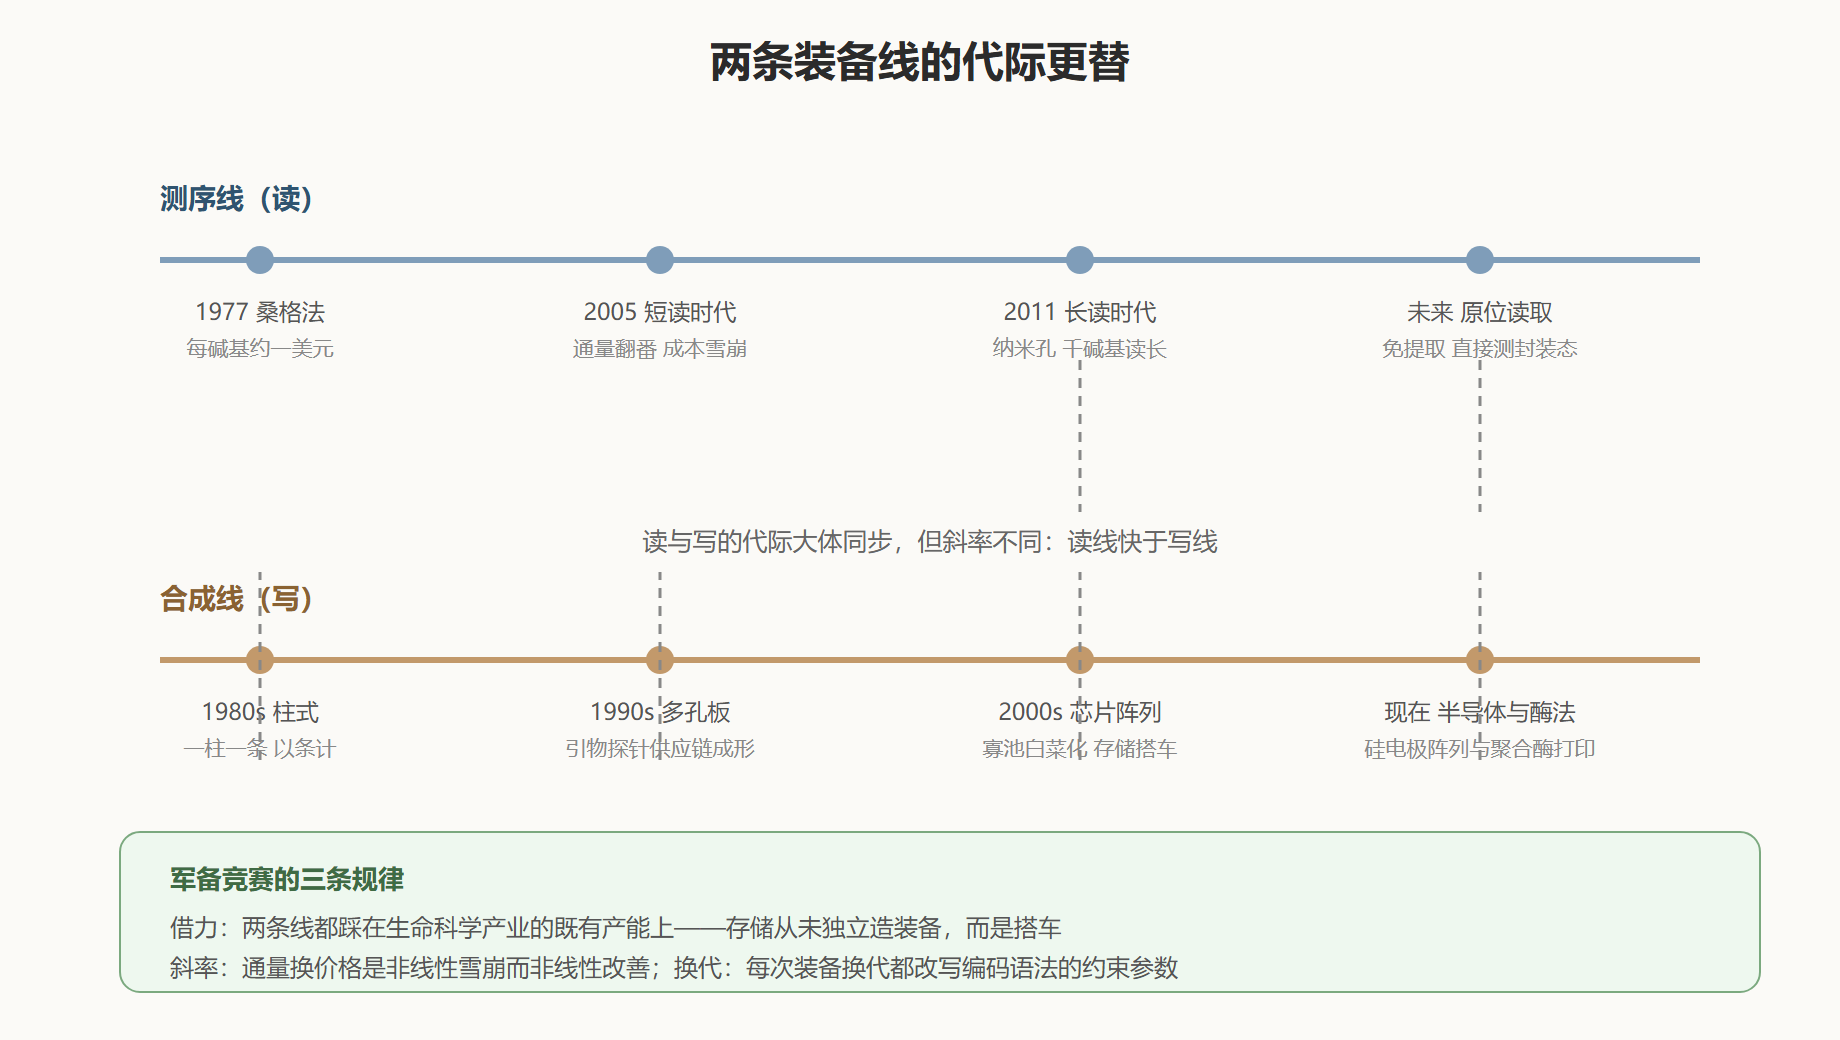
先看合成线。柱式时代(1980 至 1990 年代):一根柱子一条序列,为分子克隆服务,通量以条计。多孔板时代(1990 年代):九十六孔板并行,引物与探针供应链成形,生物产业的基础设施层。芯片阵列时代(2000 年代至今):光刻或电化学驱动,单芯片数十万到百万位点,寡核苷酸池把单碱基价格压到千分之一美分量级——存储实验正是搭上这班车才成为可能。正在进行的换代有两条分支:半导体路线把合成位点做成硅电极阵列(6.4 节展开),酶法路线用聚合酶替换化学循环(4.2 节已讲)。两条分支共同的靶心是同一个:写入通量。
再看测序线。桑格时代(1977 至 2004 年):手工凝胶到自动化毛细管,人类基因组计划把成本压到每碱基约一美元。短读时代(2005 年起):桥式扩增加可逆终止,通量十年翻了几十番,成本从每碱基一美元跌到百万分之一美元级——人类全基因组测序从三十亿美元降到数百美元,是所有科技史上罕见的成本雪崩。长读时代(2011 年至今):纳米孔与单分子实时测序把读长拉到千碱基级、把仪器从机房搬到掌心。正在萌芽的下一站是原位读取——不经提取纯化直接对封装态分子测序,这会给保存与读取的工艺衔接再省一道工序。
图:装备双轨演化时间线
军备竞赛的三条规律
第一条规律:借力。两条装备线没有一项核心技术是为存储发明的——测序为基因组学,合成为制药与合成生物学。存储研究者从未自己造装备,而是敏锐地搭车:2012 年的实验用现成寡池,2019 年的原型机用电化学芯片合成,未来的原位读取会借诊断行业的微流控产能。这条规律的战略含义是:DNA 存储的装备成本曲线不由存储市场决定,而由生命科学大盘决定——这是它相对其他颠覆技术的独特优势:别人赌的是单一市场,它赌的是一个万年行业。
第二条规律:斜率。两条线都呈现"通量换价格"的雪崩式曲线,但斜率不同。测序线三十年把每碱基成本砸了六个数量级,合成线近十年也降了六个数量级——但起点不同:读端从一美元起步,写端从"每碱基数美元"起步,两者相向而行,至今仍隔两三个数量级。这个"读写剪刀差"就是赛道的基本盘:取回便宜、写入昂贵,一切系统设计与商业模式都围绕它展开。剪刀差何时闭合?半导体合成路线的路线图上写着这个日期的估算。
第三条规律:反向塑造。装备换代不只是参数升级,它会改写编码语法:短读决定 oligo 百碱基的切碎结构,长读松动切碎粒度,纳米孔的错误谱系改写纠错参数,原位读取可能改写封装形态的选择。反过来,存储需求也在推动装备改良——电化学合成芯片的逐点激活能力,一半是为存储场景倒逼出来的。装备与编码的这台双人舞,从开山之日跳到现在,还会继续跳下去。
要点回顾
- 合成线四代际:柱式、多孔板、芯片阵列、半导体与酶法并行;测序线四代际:桑格、短读、长读、原位读取在萌芽。
- 三条规律:借力生命科学的既有产能(存储从未独立造装备)、通量换价格的雪崩斜率(读写剪刀差是赛道基本盘)、装备换代反向塑造编码语法。
- 读写剪刀差的收敛日期,就是冷归档市场正式开赛的日期——它写在半导体合成的路线图上。
- 系统设计者的功课是保持编码可迁移,让每次装备换代都成为红利而非重构。
常见追问
存储行业该不该自建合成产能? 大多数玩家的答案是先不。自建的诱惑是控制权,代价是与成熟供应链的三重摩擦:工艺学习曲线以年计、良率爬坡烧钱、规模不达标则单价反而更贵。聪明的姿势是绑定而非自建——与合成平台共研存储专用工艺(比如长读长、存储级质检),把资本开支留给真正差异化的编码与系统层。例外只有一类:当写入量级大到现有产能接不住时,像头部云厂商那样参股共建,才在经济上成立。
测序仪会一直兼容存储场景吗? 大概率会,但要盯住一个变量:仪器厂商对存储的定位。存储文库对测序仪是"好客户"——读长要求不高、批量稳定、不挑化学版本;只要存储市场的体量涨到厂商产品规划里值得一行的位置,兼容就会主动加深,存储专用的工作流甚至固件选项都会出现。反过来,若存储市场迟迟不起量,兼容就只是顺带。生态位的维护,本质是让自己成为对方产品规划里的一行字。
数字备忘
补三组数字完善装备的账。代际周期:两条线的换代节奏都在五年上下——短读平台从发布到统治市场用了约五年,芯片合成从亮相到白菜化用了差不多同样时间。成本斜率:测序每碱基成本三十年降了约八个数量级,合成近十年降了六个数量级——斜率相近、起点相远,剪刀差闭合的时间表因此被拉长。产能对照:全球商业合成的年产能折算成存储数据仍是太字节量级,与归档市场的拍字节级需求隔着五六个数量级——这就是为什么装备路线图比编码论文更能预测产业化时间表。
数字补遗
补两个观察装备线的速查指标。一看"交付长度":合成平台的公开演示读长,是编码经济学改善斜率的先行指标——它每翻一倍,索引与纠错的占比就稀释一半。二看"单位通量价格":测序以每吉碱基报价、合成以每碱基报价,两条价格曲线的斜率差就是读写剪刀差的宽度。把这两个指标放进你的年度复查清单,任何一次跳变都值得回来重读本章:前者改变编码参数,后者改变产业时间表。
三句话备忘
自测一问:合成线每换代一次交付读长与报价各怎么变?读长小步上探、报价大步下降——因为换代红利主要来自并行规模而非单链化学。看懂这个不对称,就明白为什么"报价腰斩"的发布会远多于"读长翻倍"的发布会,也明白后者一旦出现为何格外珍贵。
一句话记合成线:柱式、多孔板、芯片阵列、半导体与酶法,四代接力把报价砸了六个数量级。一句话记测序线:桑格、短读、长读、原位,三十年搭出万年行业的读取基础设施。一句话记剪刀差:读端搭车、写端自费,闭合日期写在半导体路线图上。
装备再强,也只是梯队的材料。下一节讲混合存储架构:磁盘、磁带、DNA 如何组成一支分工明确的梯队,而不是互为替代品的对手。