7.3 模糊与神经网络控制
7.3 模糊与神经网络控制
本节摘要:模糊控制把操作员的语言规则(误差大则阀门大开)经隶属度与规则推理转成非线性控制面,不需要对象模型;神经网络以可学习的非线性映射逼近未知函数,直接当控制器用或做对象正模型inverse 模型。本节完整设计一个二维模糊控制器并可视化其控制面,剖析神经网络控制的典型结构与适用边界。
承接 7.2 节:自适应仍需要参数化模型。本节的对象是"模型连形式都写不出、但老操作员会开"的系统——知识从方程换成规则与数据。
一、模糊控制:把老师傅的话变成曲面
窑炉、发酵、污水处理常年面临"没人写得出一阶方程,但老操作员凭手感开得很好"的窘境。模糊控制的立场:把操作员嘴里的语言规则直接翻译成控制器。"误差为正大且误差变化为负小,则控制量正大"——三步翻译:模糊化把精确的误差值换算成对各语言档(负大、负小、零、正小、正大)的隶属度;推理把所有被激活的规则按 Mamdani 规则合成,得到输出的模糊集;解模糊(重心法常用)折算回一个精确控制量。跑起来它就是一个以误差和误差变化为输入的非线性静态映射——一张光滑的曲面,长得像放大版的 PD。
用工具箱搭一个双输入单输出模糊控制器并看曲面:
fis = mamfis('Name','level_ctrl'); fis = addInput(fis, [-10 10], 'Name', 'e'); % 误差论域 fis = addInput(fis, [-5 5], 'Name', 'de'); % 误差变化论域 fis = addOutput(fis, [-100 100], 'Name', 'u'); % 控制量论域 % 每个变量挂5个三角隶属度:NB NS ZE PS PB for v = {'e',5;'de',5;'u',5} % 五档均匀三角隶属度(中心 -10,-5,0,5,10 按论域缩放) end % 规则库(节选核心四条,完整25条按同一模式铺开): % e为NB且de为ZE -> u为PB % e为ZE且de为ZE -> u为ZE % e为PB且de为ZE -> u为NB % e为PS且de为PS -> u为NM(提前刹车) fis = addRule(fis, [1 3 5 1 1; 3 3 3 1 1; 5 3 1 1 1; 4 4 2 1 1]); gensurf(fis) % 输出:控制面呈反对称的斜坡状,边缘陡(大误差大力推), % 原点附近平缓且受 de 影响(变化快则少给)——一张自动生成的非线性PD曲面
设计要点三条:论域定标是成败关键,输入输出物理量到模糊论域的缩放系数本质就是比例增益与输出增益;规则库规模二维五档共二十五条已够多数应用,盲目加密到七档四十九条徒增维护负担;控制面要可视化验收——gensurf 出来的曲面必须单调合理(大误差大动作、过零附近平缓),出现怪峰即规则表笔误。
二、模糊控制的真实定位
仿真与现场的大量对照给出一个诚实的结论:调好的模糊控制器性能大致与调好的 PID 相当,其真正价值在三处:能直接吸纳操作员经验(冷启动有起点)、规则可逐条解释与审计(安全行业看重)、控制面可离线刻成查找表跑在最便宜的芯片上。局限同样清晰:稳定性没有系统化设计方法(只能事后用 5.1 节工具验证或限制论域保平安)、稳态精度依赖规则密度、多变量维数爆炸。行业实践常是模糊增益调度:用模糊逻辑在线调度 PID 的三个参数,而不是直接输出控制量——两边的长处各取一半。
三、神经网络控制:学出来的控制器
神经网络的卖点是把"任意连续非线性映射都能逼近"变成工程可用的事实。控制里的四种出场方式:逆模型控制(网络学对象逆向,直接当控制器,要求对象近似可逆);前馈补偿(网络学扰动映射做前馈,反馈仍归 PID);模型参考学习(网络控制器在线调权,让闭环逼近参考模型,与 MRAC 精神同源);强化学习控制(只有延迟的奖励信号、无监督标签,试错中更新策略,游戏与机器人领域的主角)。造一个前馈加反馈的小例子:
% 对象:非线性 y = 0.6y_prev + tanh(u)(阀门饱和非线性) % 方案:PID打底 + 小网络前馈学逆特性 net = feedforwardnet(8); % 8隐单元 % 先离线收集数据:u 扫 -2..2,记录稳态映射 u_data = linspace(-2,2,200)'; y_ss = tanh(u_data); net = train(net, y_ss, u_data); % 学逆映射:y到u % 在线运行:u = net(r) + pid(y,r) 前馈给主粮,反馈找零头 sim_u = net(0.7) + 0.3*(0.7 - y); % 输出:网络前馈输出约 atanh(0.7) 即0.867, % 阶跃响应比纯PID快且无饱和引起的爬行——逆模型前馈吃掉了主要非线性
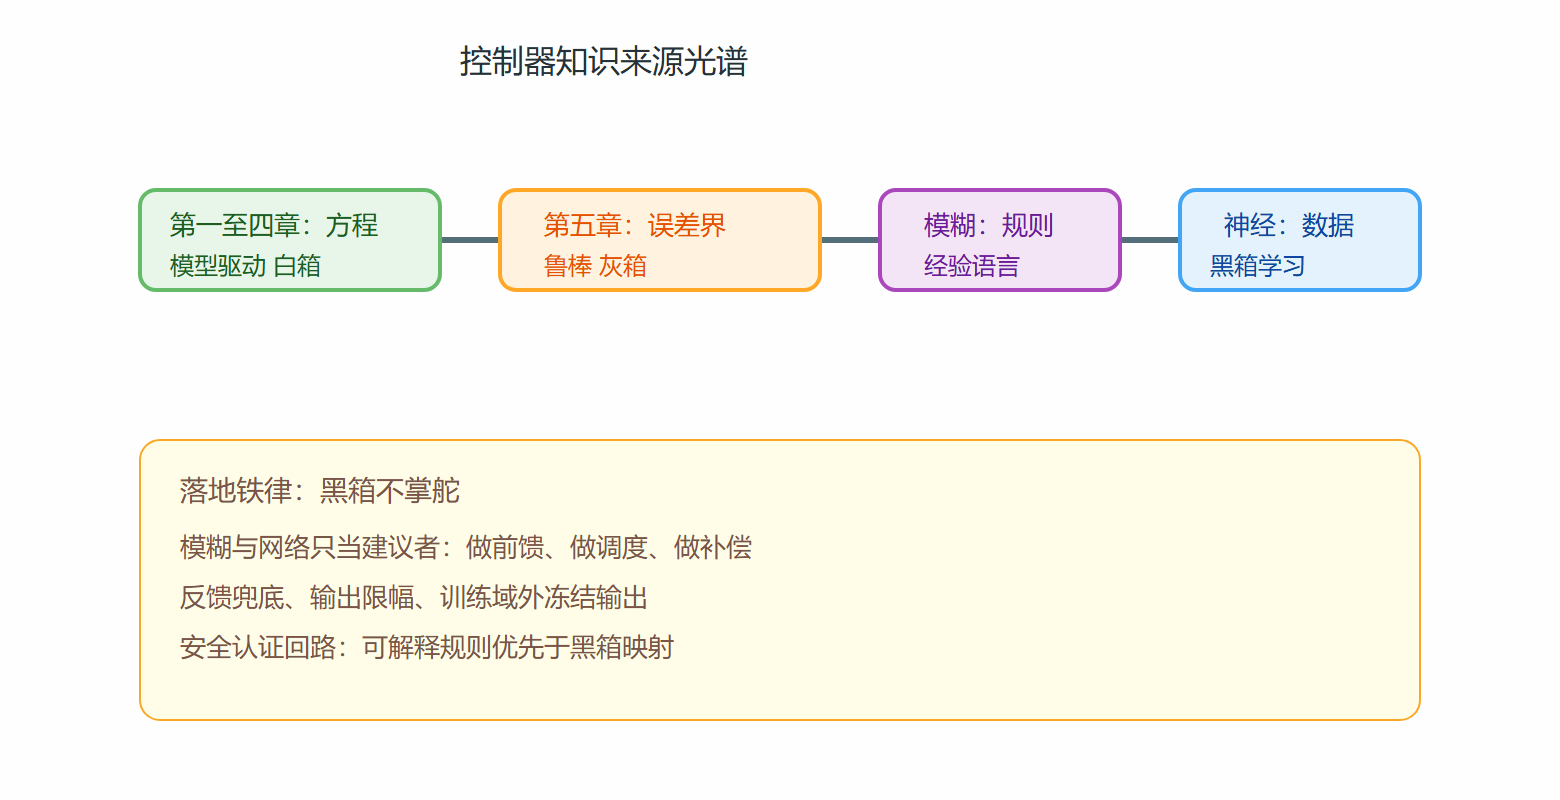
神经网络控制的死穴是泛化与安全:网络只在训练数据覆盖的区域内可信,出界即胡说;黑箱决策难通过安全认证。工程对策与自适应同款:网络只做前馈或调度这类"建议者",反馈兜底、输出限幅、域外冻结,绝不让黑箱独自掌舵安全攸关回路。
图 知识来源光谱
四、选型对照与组合
四种"非常规"路线定位各一:MPC 吃约束与耦合、自适应吃慢漂参数、模糊吃经验与冷启动、神经网络吃逆模型与前馈。现场组合远多于单挑:模糊调度 PID 增益、网络前馈加 MPC 主控、自适应在线更新 MPC 的预测模型——把各家的长处拼在同一分层架构里。下一节讲的工程实现框架正是为这种组合准备的。
五、训练数据的纪律
数据驱动方法的上限由数据决定。采集要覆盖工作域的边角(只拿平稳段数据训练,网络遇到大扰动就胡说);输入要有足够激励(与自适应的持续激励同源);训练集与验证集必须按工况切分而非随机打散——随机打散会泄漏工况信息,验证指标虚高。这三条纪律与 7.2 节的激励条件、5.3 节的权重证据一脉相承:凡是学习,先问数据从哪来、覆盖到哪、凭什么信。
本节要点回顾
- 模糊三步:模糊化、Mamdani 推理、重心解模糊,本质是一张可解释的非线性 PD 曲面;- 定标即设计:论域缩放系数就是增益,控制面可视化验收是必做质检;
- 诚实定位:性能与调好的 PID 相当,价值在经验吸纳、规则可审计、查找表实现;
- 网络四种出场:逆模型、前馈补偿、模型参考学习、强化学习,前馈加反馈兜底最稳;
- 黑箱铁律:建议者不掌舵,域外冻结、输出限幅、可解释优先。
兵器谱全部交齐。最后一节:把它们装进可靠的工程壳里。