3.3 速度与写入能耗:谁为低功耗买单
3.3 速度与写入能耗:谁为低功耗买单
本节摘要:写入速度、写入电流、单次能耗是三个纠缠的指标,四大家族的排位与直觉常相反:最快的 MRAM 反而要大电流,"零静态功耗"的 FTJ 写入却不算最快。本节对照三者关系,并示范阵列级功耗的估算方法——这是存算一体能效叙事的算术基础。
速度有三个不同的定义
谈速度先分清三个词。本征翻转时间:状态变量完成翻转的物理耗时(MTJ 进动翻转约 0.13 ns、FTJ 极化翻转皮秒级、RRAM 细丝贯通亚纳秒、PCM 结晶几十到几百纳秒);写入窗口时间:为让统计分布整体进窗,实际施加脉冲往往比本征时间更宽、更高(比如 RRAM 写入脉宽常配 10100 ns 以收敛分布);系统写入延迟:加上寻址、驱动、写校验读回后的端到端耗时,写校验一次就是读写两个来回。论文标题里的"ps 级切换"通常指第一个,产品需求书里的"页编程时间"通常指第三个,两者可以差四到六个数量级。横评时务必先对齐口径。
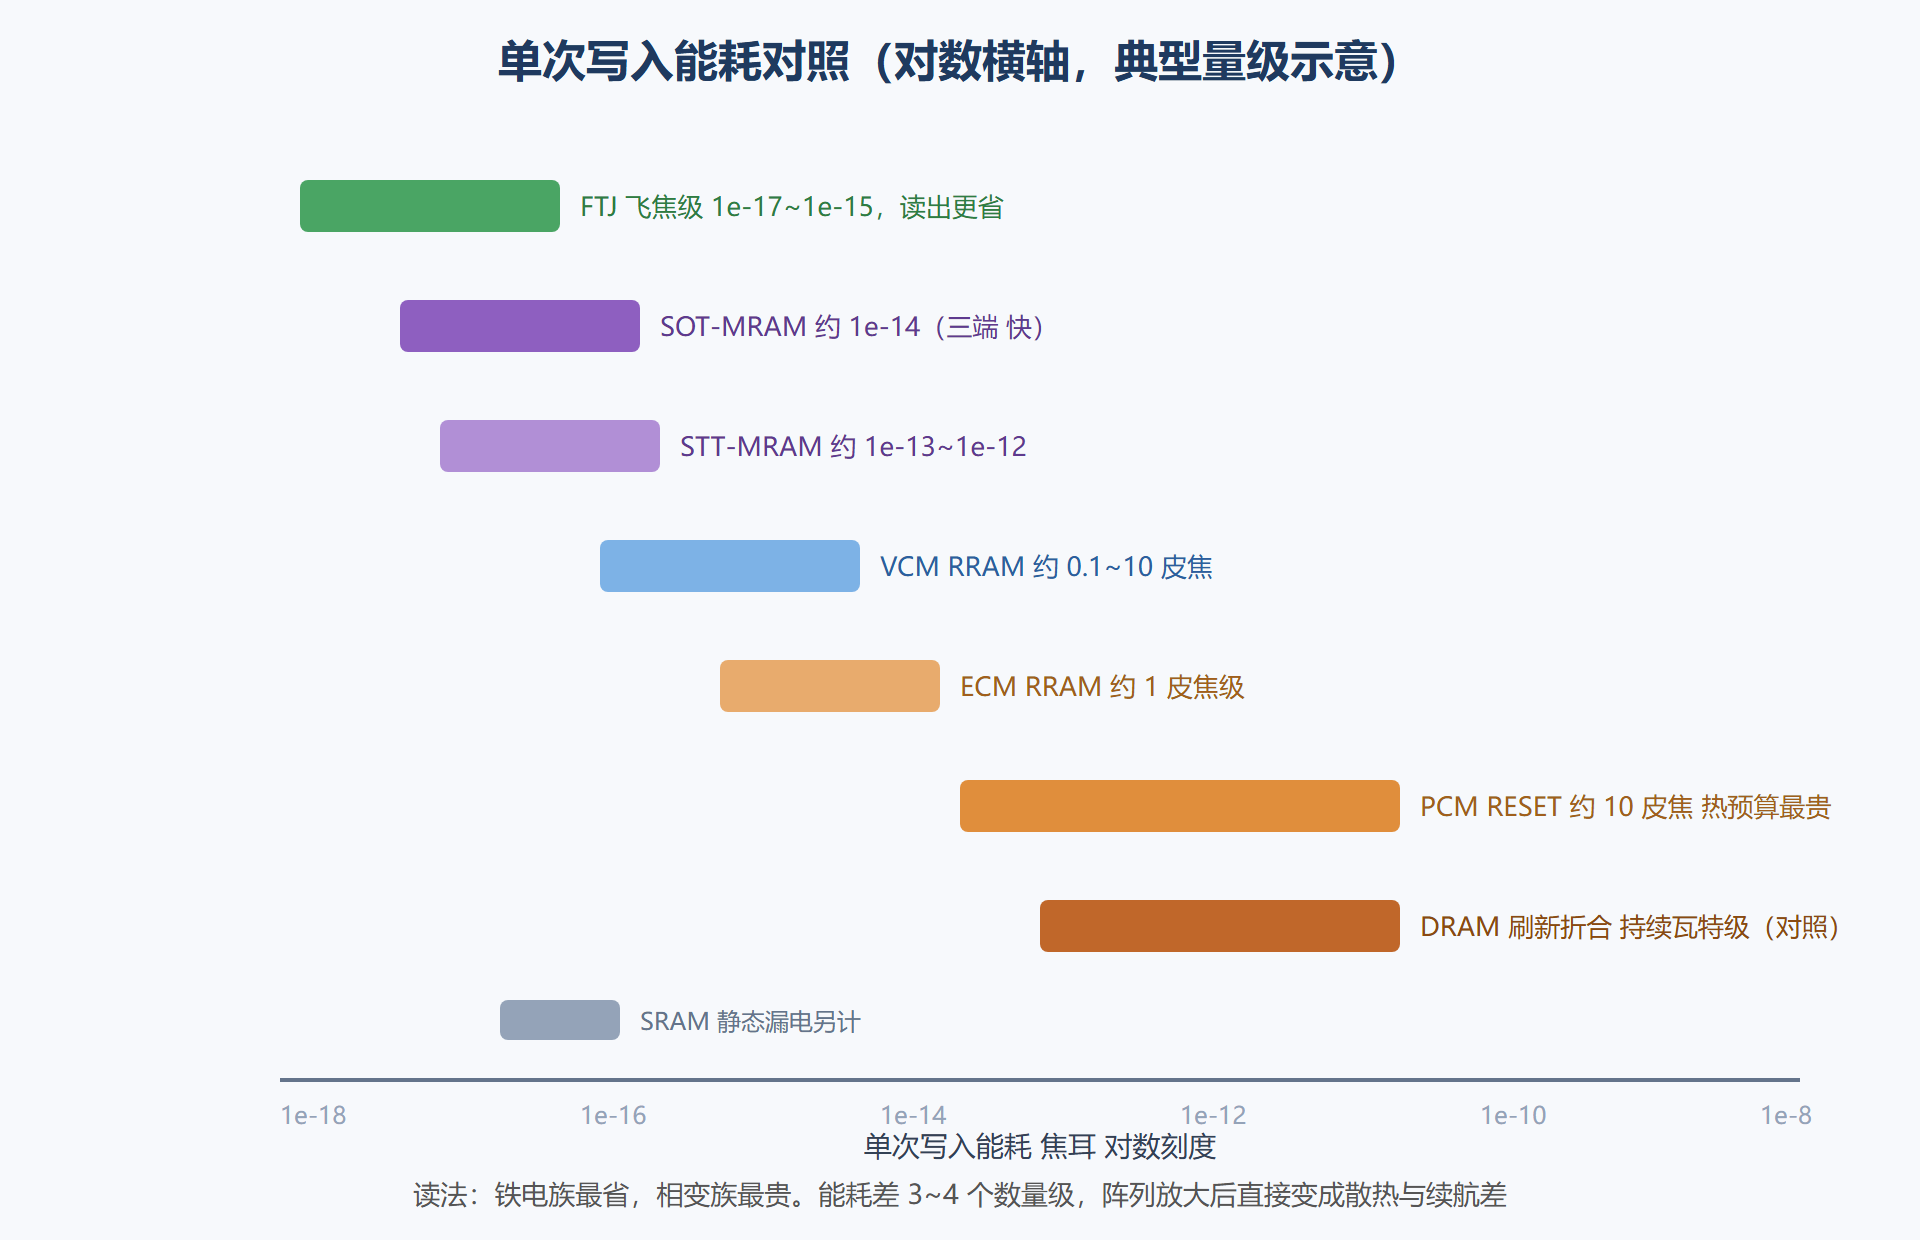
图:写入电流与单次能耗对照(典型量级)
写入电流:被低估的系统瓶颈
单器件电流看着都不大,但阵列是并行的。以 1 Mb 阵列整行写入为例:PCM 单元 RESET 电流 300~500 μA,若 256 个单元并行写,仅单元电流就超过 100 mA——这还没算选通晶体管与线损耗。这就是为什么第 4 章的选通器件(1T1R 里的晶体管要扛住 RESET 电流又不能占太多面积)成为 PCM 微缩的真正短板;也是为什么 MRAM 把写入电流密度从 10⁷ 降到 10⁶ A/cm² 的每一步都值得单开一场发布会。
对照表把三个指标与前面章节的因果挂钩:
| 指标 | RRAM/VCM | PCM | FTJ | STT-MRAM | 机制根源(回指第 2 章) |
|---|---|---|---|---|---|
| 写入时间 | 1~100 ns | SET 50500 ns / RESET 2050 ns | 1~50 ns | 2~20 ns | 离子迁移 / 结晶动力学 / 极化翻转 / 进动翻转 |
| 写入电流 | 1~100 μA | 100 μA~2 mA | ≤1 μA 级 | 50~500 μA | 局域造线 / 体相加热 / 场翻转 / 力矩需电流 |
| 单次能耗 | 0.1~10 pJ | 1~100 pJ | 0.001~0.1 pJ | 0.1~10 pJ | 见上图 |
| 读取时间 | 10~100 ns | 20~100 ns(含阈值考虑) | 50~200 ns(电流小读慢) | 2~20 ns | 读出幅度决定感放速度 |
| 静态功耗 | 零(理想) | 零 | 零 | 零 | 四家族皆非易失,这是对 DRAM 的结构性优势 |
阵列级能耗:一笔算术账
存算一体常宣传"能效比 GPU 高两个数量级"。这个数字对不对,取决于你把哪些项算进账单。下面把 1M 权重(128×8192,INT8 化为每器件 4 bit 双器件编码)做一次矩阵乘的能耗拆账:
存内计算单次 MVM 能耗拆账(128x8192 阵列,示意估算) 1. 阵列物理计算:V=0.2V 读电压 × 行电流合计约 1mA × 5ns ≈ 1e-12 J (1 pJ) 2. ADC 读出:8 位 SAR 每列约 5 pJ × 128 列 ≈ 640 pJ —— 大头 3. 移位累加与激活(近存数字电路):约 200 pJ 4. 合计约 0.84 nJ / 次完整 MVM 对照:28nm 数字 GPU 做同规模 INT8 运算约 30~100 nJ 结论:ADC 数字化与后处理吃掉 99% 能耗 —— "模拟计算白送的能效" 大半被读出链路花掉了。降 ADC 精度/分享 ADC 是架构第一杠杆。
这笔账给出两个工程推论。第一,器件能耗只在阵列物理层那一项里,占比极小,所以"换更低功耗的器件"对系统能效的边际收益有限,"换更聪明的读出方案"收益巨大——这解释了为什么存算芯片的论文创新集中在 ADC 与位切片方案。第二,能效比宣称必须注明算的哪一段:只算阵列物理层的能效可以上天,算到数字接口就回到人间;两篇论文差两个数量级的原因常常只是账本口径不同。
动态功耗与"读干扰"的隐藏账单
还有一项容易漏算:读操作的扰动代价。RRAM/PCM 读多了会扰动状态(读 disturb),系统要么限制读电压、要么周期性回写,回写就是实打实的能耗与带宽开销。MTJ 的读干扰极小但读电流也小,需要更灵敏的感放,感放偏置电路的静态功耗在纳米瓦级、万颗阵列下不可忽略。FTJ 读出电流最小,读出信噪比预算最紧张。能耗的完整账单 = 写 + 读 + 校验回写 + 外围静态,四个都进账,横向对比才有效力。
💡 关键直觉:器件级能耗排名(FTJ < MRAM ≈ RRAM < PCM)到了系统级会被读出链路重新洗牌。选型时先算读出预算,再看器件能耗,顺序不能反。
写入波形的工程学:同一器件的不同性格
速度与能耗不只由器件决定,还由你"怎么按按钮"决定。同一颗 PCM,用陡峭的矩形 RESET 脉冲与用带斜坡的整形脉冲,能耗可以差 30% 以上——斜坡让熔融区收窄、减少不必要的加热体积。同一颗 RRAM,用固定幅度的 SET 脉冲与用逐步加幅的渐进脉冲(incremental pulse programming),多值精度可以从 2 bit 提到 3 bit,代价是写延迟翻倍。波形工程是器件物理与电路设计之间的缓冲层,也是各家电学团队的核心 know-how:脉宽、幅度、斜率、极性、间隔五个旋钮组合出同一器件的不同工作点。读文献时遇到"写入速度/能耗"数据而未注明波形,应默认按最普通矩形脉冲理解;厂商数据表的典型值则通常带着最优波形——两者的差距有时候能到一倍。
四家族在波形工程上的侧重也不同,这本身就又是一组对比:PCM 的旋钮集中在 RESET 热整形;RRAM 集中在限流与渐进 SET;MRAM 集中在写电流幅度的概率化;FTJ 几乎不需要波形工程(电压脉冲即写)——这是 FTJ 作为"最简单写入"家族的隐藏优势,也是它在超低功耗标签市场被看好的原因之一。
本节要点回顾
- 三种速度口径:本征翻转时间、写入窗口时间、系统延迟,跨口径比较能差出六个数量级。
- 写入电流是阵列瓶颈:并行写入把单器件微安放大成百毫安,PCM 的 RESET 电流与 MTJ 的电流密度是各自微缩路线的核心战场。
- 能耗账单要拆:阵列物理计算只占存算系统能耗的约 1%,ADC 与后处理是大头;能效宣称必须注明口径。
- 隐藏项:读干扰回写与感放静态功耗,漏算它们会让对比失去效力。