3.4 参数速查与选型速算:三分钟读表定用途
3.4 参数速查与选型速算:三分钟读表定用途
本节摘要:本节把前三节的横评压缩成一张速查总表与一张雷达图,并给出三道实战速算题——从应用需求反推器件规格门槛。它是全册引用频率最高的一节,第 8 章的选型决策表以它为数据底座。
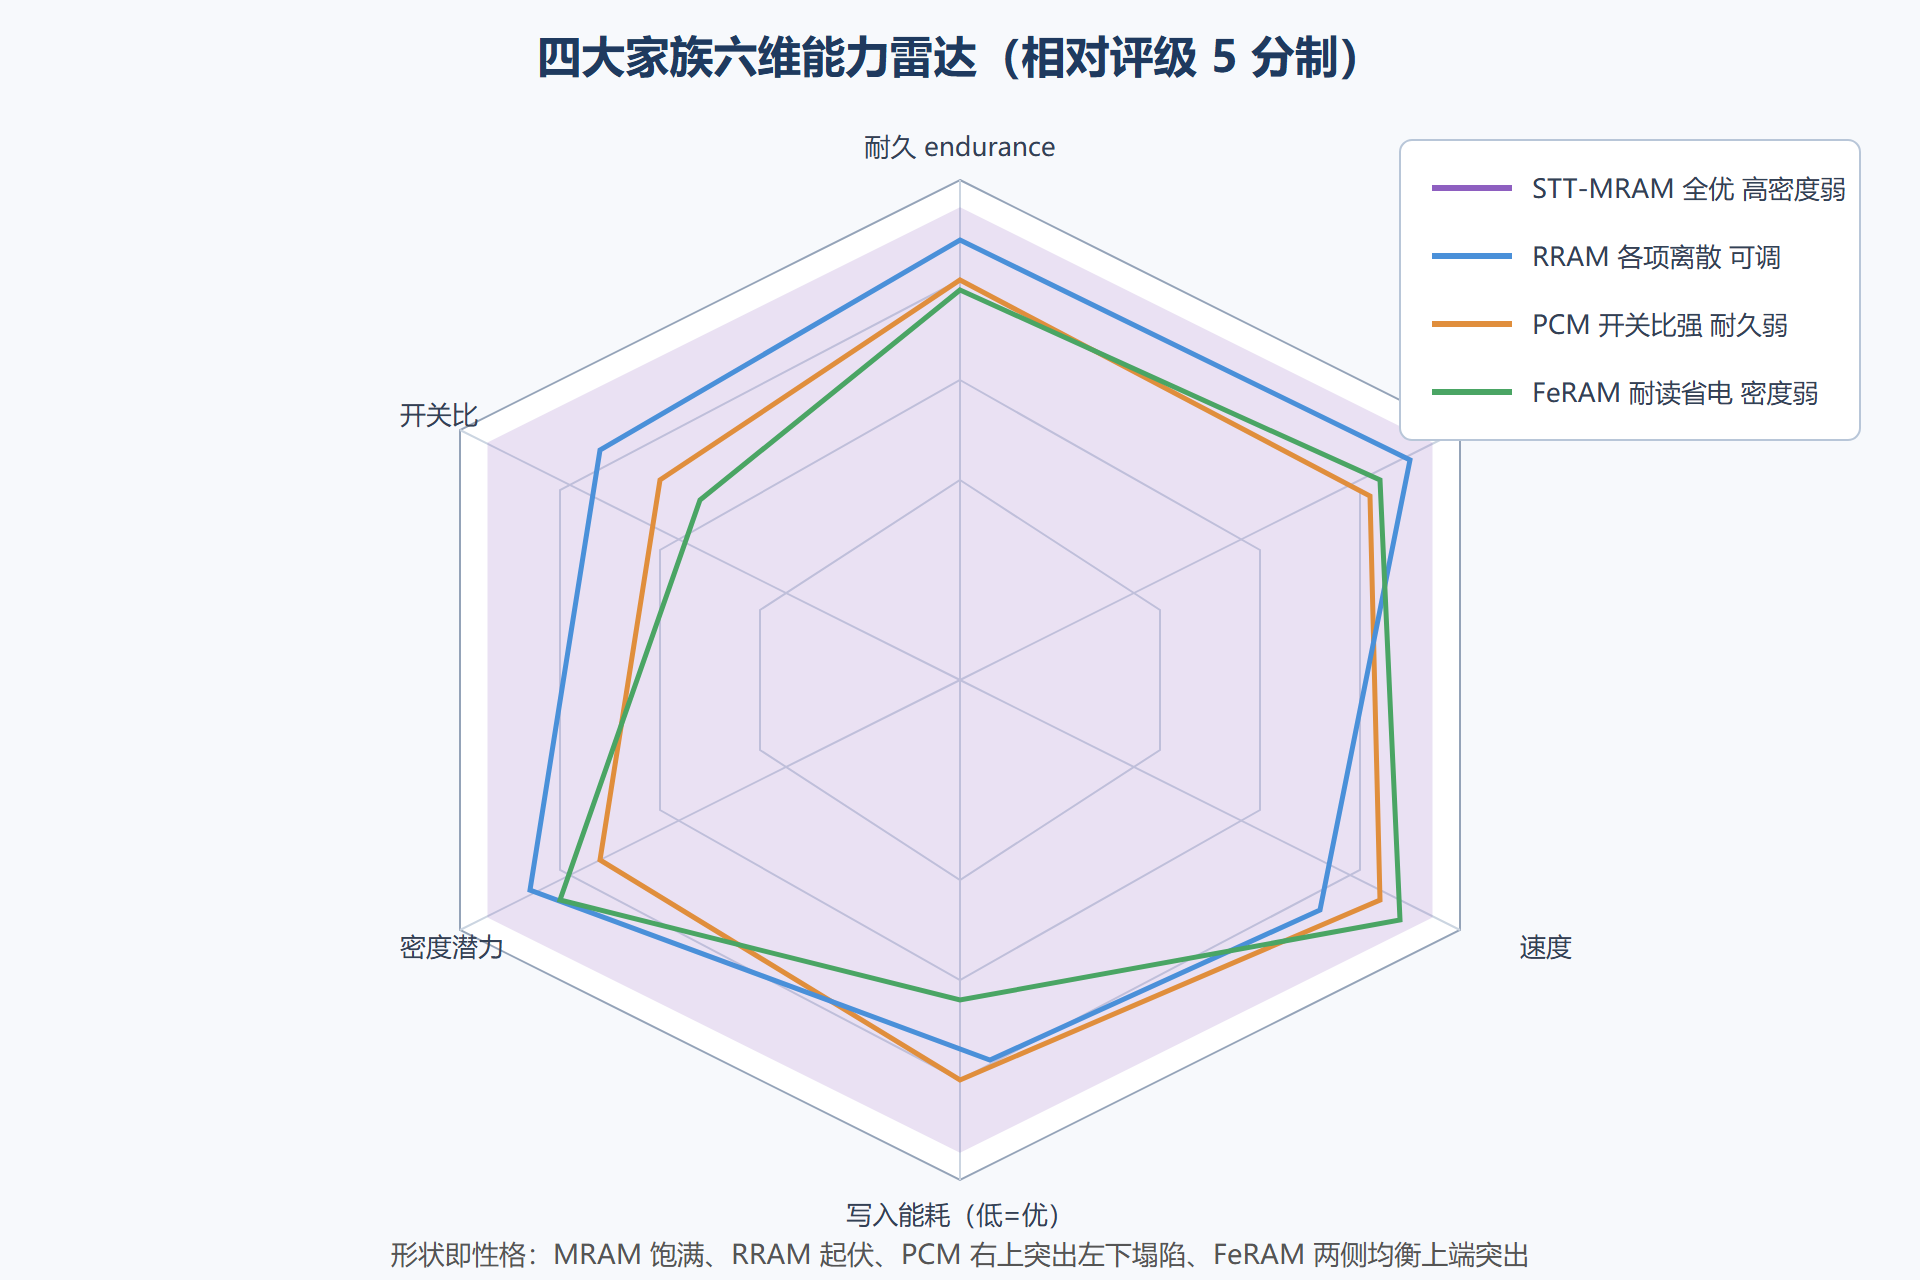
一张雷达图定性格
对比的意义不在于记住每个数字,而在于一眼看出"性格"。把六个关键维度归一化后画在雷达图上,四大家族的形状差异立现:MRAM 是近乎饱满的六边形(均衡优等生)、FeRAM 缺了密度一角、PCM 在 endurance 上塌陷、RRAM 的边缘最不规则(因为子类差异最大)。形状记忆法比数字记忆法抗遗忘,先看图再回查数字。
图:四大家族六维能力雷达图
全家福速查总表
数字均为量产或接近量产器件的典型区间(2020 年代中期视角),实验室断续纪录不收录:
| 参数 | VCM RRAM | ECM RRAM | PCM(掺杂) | FeRAM | FTJ | STT-MRAM |
|---|---|---|---|---|---|---|
| 开关比 | 10~10³ | 10³~10⁷ | 10²~10⁴ | 电荷型读出(无阻态比概念) | 10~10³(TER) | 1.5~3(TMR 150%~300%) |
| 写入时间 | 1~100 ns | <10 ns | 50~500 ns | 5~50 ns | 1~50 ns | 2~20 ns |
| 写入电流 | 1~100 μA | <10 μA | 0.1~2 mA | 1~20 mA(脉冲式) | ≤1 μA | 50~500 μA |
| 单次写入能耗 | 0.1~10 pJ | ~1 pJ | 1~100 pJ | ~10 pJ | 0.001~0.1 pJ | 0.1~10 pJ |
| endurance | 10⁶~10¹⁰ | 10⁴~10⁶ | 10⁸~10¹⁰ | 10¹⁰~10¹⁴ | 10⁶~10¹⁰(尚在验证) | 10¹²~10¹⁵ |
| retention | 10 年 @85℃ | 月~年 | 10 年 @85℃(配方) | 10 年 @125℃ | 待定(1~10 年级) | 10 年 @125℃(Δ≥40) |
| 单元规模 | 2~2.5 F²(1T1R) | 类似 | 4~12 F² | 6~14 F²(2T2C) | ~4 F²(潜力更低) | 20~40 F²(1T1MTJ) |
| 工艺节点先例 | 22~40 nm 嵌入式 | 实验室 | 20~45 nm | 130 nm 为主 | 实验室 | 14~28 nm 嵌入式 |
三处值得驻足。单元规模列解释了"为什么交叉阵列执念这么深":1T1R 结构的 2~2.5 F² 已经很优秀,但真正的 4F² 与 3D 堆叠只有无选通器 crossbar 能给——密度与可靠性的战争在第 4 章正式打响。FeRAM 的写入电流大但时间短,脉冲式大电流让它单次能耗仍然很低,这是"电流大不等于能耗高"的活例子。FTJ 的 endurance 列还有问号:它是唯一"实验室共识尚未收敛"的家族,选型时要预留验证预算。
三道速算题
第一道,嵌入式代码存储:MCU 外挂配置存储,年写入千次,10 年寿命,断电保持十年,容量 1 MB。endurance 需求 10⁴——任何家族都够;决定因素变为"零待机功耗 + 良率 + 单价",答案是 eMRAM 或 eRRAM 看工艺平台有什么,FeRAM 若平台支持也是好选择。
第二道,边缘端神经网络权重:5 MB 权重,出厂烧录后基本不改,推理为读密集。写需求趋近于零,读密集要求低读功耗与大容量密度,答案指向 PCM 或 3D RRAM 阵列,MTJ 因密度弱退居其次。
第三道,片上学习突触阵列:在线训练,权重每秒更新百次以上,10 年不换。endurance 需求 10¹⁰ 量级——家族里只剩 FeRAM/MRAM/RRAM 顶配接近,且必须配合"稀疏更新"算法减少实际写入次数。结论往往改写为架构方案:片上存推理权重(PCM/RRAM)、片外做训练(GPU/DRAM),hybrid 而不是硬扛。
# 速算器:给定需求向量,输出各家族是否过线(教学演示版) def screen(endurance_need, retention_years, write_iops, temp_c=85): families = { # (endurance上限, 85度等效保持年, 可持续写入iops) "STT-MRAM": (1e13, 10, 1e3), "FeRAM": (1e12, 10, 1e5), "PCM": (1e9, 10, 1e3), "RRAM-VCM": (1e9, 10, 1e4), "FTJ": (1e8, 3, 1e3), } out = {} for k,(e,r,w) in families.items(): out[k] = (endurance_need <= e) and (retention_years <= r) and (write_iops <= w) return out # 例:片上学习场景 screen(1e10, 10, 100) -> 仅 FeRAM 与 MRAM 过线
速查表的两种错误用法
先说两种真实发生过的误用,比记住表格更重要。误用一:横向串行比较。拿本表 PCM 的写入时间与 RRAM 的 endurance 做乘除推理("PCM 写五倍慢,所以 endurance 也该差五倍")——指标之间没有这种换算关系,每个数字挂在自己的机制上。误用二:峰值当典型。本表给的是量产典型区间,不是实验纪录;拿纪录值设计系统规格,等于按短跑冠军的平均速度排班表。正确的用法只有一种:先定位应用在哪个行(哪个指标是瓶颈),再读那一列的区间,最后用区间下限做保守设计。
从速查到决策
速查表回答"谁过线",不回答"谁最优"——后者要把良率、单价、生态、供货安全压进来,那是第 8 章的任务。本节末尾留一个使用纪律:任何进选型文档的数字都要带三件套出处(温度条件、测试口径、样本量),这套纪律从 3.2 节开始强调,到这里应该已成习惯。
⚠️ 常见坑:把本表的"工艺节点先例"当成"任意平台可移植"。嵌入式 NVM 的可得性由代工厂平台决定——你的晶圆厂 28nm 平台有 eMRAM 不代表有 eRRAM,先查平台工艺选项清单,再做器件选型,顺序反了会浪费一轮设计。
本节要点回顾
- 形状记忆法:雷达图形状即性格——MRAM 均衡、RRAM 离散、PCM 偏科、FeRAM 双高但密度弱。
- 速查表三处驻足:单元规模解释 crossbar 执念;FeRAM 大电流短脉冲能耗仍低;FTJ 的 endurance 尚未收敛。
- 三道速算题:代码存储看良率单价、权重存储看读密度、在线训练必须架构混合。
- 数字三件套纪律:温度、口径、样本量,缺一不可引用。