5.1 四家族突触资质对比:谁能扮演生物突触
5.1 四家族突触资质对比:谁能扮演生物突触
本节摘要:把器件当突触,考的是四门功课:权重多值(承载精度)、脉冲可塑性(更新方式像不像 STDP)、写入能耗(学习代价)、endurance(能学多久)。本节按四门功课给家族四子打分,结论是:推理突触与学习突触是两种工作,最优器件并不相同。
最初,人们只是想让器件"越用越像"
最初把神经形态与忆阻器绑在一起,源于一个朴素的观察:生物突触的连接强度随活动历史缓慢改变(赫布学习、STDP),而忆阻器的电导恰好也随脉冲历史缓慢改变——两者共享"由历史雕刻当前状态"的时间结构。2008-2012 年间,多个小组独立演示了在 RRAM 上用前后脉冲对模拟 STDP:脉冲时间差为负(前突触先于后突触)则电导增强,为正则减弱,测得的电导变化曲线与生物数据的形状惊人相似。这篇开山之作激起的乐观,催生了此后十几年的整个突触器件方向。
但"曲线相似"到"系统可用"之间隔着工程化的四门考试。把四家族放进考场,成绩单分野清晰。
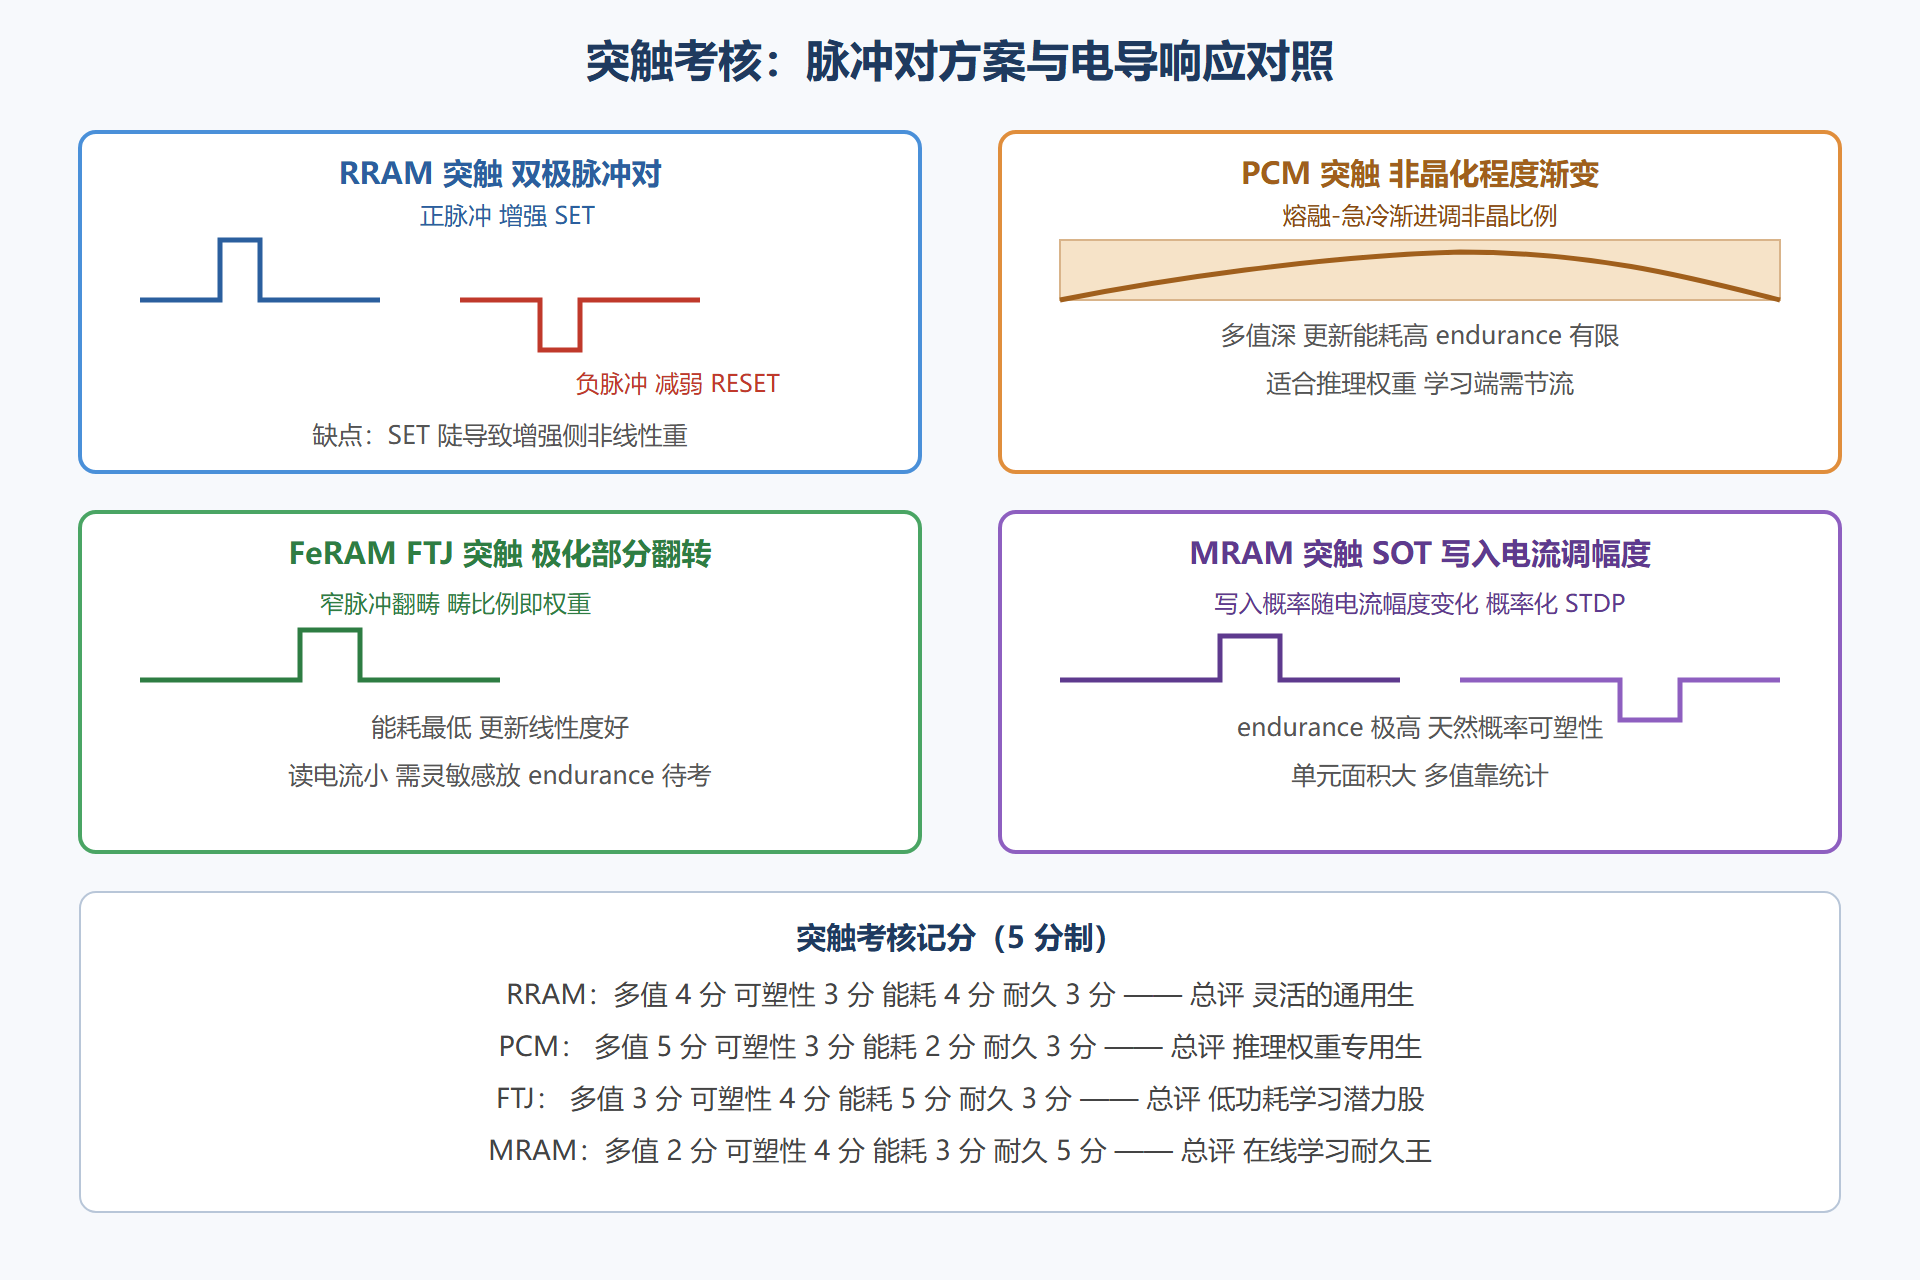
图:四家族突触脉冲方案与可塑性对照
四门功课的判分细节
功课一,权重多值。 推理突触要静默承载精度:PCM 的非晶化程度可连续调节,4 bit/cell 已反复演示,是毫无疑问的第一名;RRAM 可到 24 bit 但需写校验护航;FTJ 的畴比例调节可到 23 bit;MTJ 的两态本性使它只能靠多器件拼精度——把权重拆到位平面(一个权重用四个 MTJ 表示四个二进制位)是 SOT-MRAM 存算芯片的主流做法,面积换精度。
功课二,脉冲可塑性。 学习突触要按脉冲渐进更新,且更新要"线性、对称"(同样幅度向上向下)。RRAM 的问题在不对称:SET 一秒到底、RESET 慢慢回,学习算法要么用成对脉冲削峰、要么干脆换成"概率更新"(脉冲幅度决定翻转概率,让随机性替算法打工)。MRAM 的 SOT 写入天然适合概率化 STDP——电流幅度控制翻转概率,这正是它 score 4 分的原因。PCM 靠堆叠脉冲调非晶比例,方向不限但每次代价高。
功课三,写入能耗。 学习是一次次写入的积分。FTJ 单次皮焦级、MRAM 与 RRAM 皮焦级、PCM 十皮焦级——在学习密集场景差距放大数千倍。这就是"FTJ 是学习潜力股"的判分依据:它的短板(读出弱、endurance 待验证)都不在学习路径的主频上。
功课四,endurance。 在线学习对写入次数的胃口是灾难级的。就算稀疏更新砍掉 99% 写入,剩余部分也要 10⁹ 量级——家族里只有 MRAM 稳过线。结论呼之欲出:推理权重选 PCM/RRAM(多值深),在线学习选 MRAM/FTJ(耐写省电),一个芯片里两种器件共存是合理架构而非妥协。
从器件突触到突触阵列的三级放大
单器件合格只是入场券。阵列级的突触要过三关:编码关——正负权重用双器件差分对表示(G⁺−G⁻),共模漂移自动抵消,代价是器件数翻倍;驱动关——行驱动要把数字输入转成电压或脉冲,位切片方案(输入拆成多个位平面分时输入,结果移位相加)用时间换 ADC 位数;读出关——列电流跨四个数量级动态范围,AGC(自动增益切换)与逐列共享 ADC 是精度与功耗的平衡点。三级放大后,突触阵列的实际精度通常落在等效 4~6 bit——跑量化后的小模型够用,跑大语言模型还早。
# 概率化 STDP 的最小仿真:用器件随机性替代精确梯度 import random def prob_stdp(dt_ms, g, g_min=0.1, g_max=1.0): # dt<0 前突触先到 -> 增强;dt>0 -> 减弱 amp = 2.718 ** (-abs(dt_ms) / 20.0) # 指数窗,与生物 STDP 同形 p = amp * 0.6 # 翻转概率由器件电流幅度决定 if random.random() < p: g += (g_max - g) * 0.2 if dt_ms < 0 else -(g - g_min) * 0.2 return g # 连续学习 1e9 次后 g 分布的收敛性,取决于 p 与更新步长的乘积 —— 阵列级调参即调此乘积
💡 关键直觉:生物突触本身就是"不可靠器件"——单个突触传递失败率高达 50% 以上,智能恰恰运行在这种统计可靠性上。存算一体的学习硬件不追求精确,追求"分布正确",这是它与数字加速器根本的哲学分歧。
与真实突触的校准:差得最远的三处
谈"类脑"之前,先诚实校准器件突触与生物突触的差距,差得最远的有三处。一是规模:人脑皮层约 10¹⁴ 个突触,当前最大忆阻阵列在 10⁸ 量级,差六个数量级——而且生物突触与神经元在三维里连续互联,阵列是二维平面结构。二是双熔合性:生物突触同时完成权重存储、信号传递与局部学习规则执行,器件突触目前只干第一件事,学习规则仍由外围电路或训练算法代管。三是能效下限:单个生物突触事件约 1~10 飞焦,忆阻突触的写入在皮焦级,差两三个数量级——读出还好,学习的代价是大头。这三处差距划定了"类脑"修辞的诚实边界:当前的忆阻神经形态系统更接近"低功耗专用推理引擎 + 简化学习规则",距离"类脑"的字面含义还很远。把边界写在明处,反而让 5.2 节的能效成绩显得更可信。
从器件到权重的精度流水账
把突触阵列的精度损耗逐站记账,能看到每一站折多少。以 8 bit 目标权重为例:器件承载 34 bit(多值极限与良率收缩后)→ 差分对消掉共模后等效 +1 bit → 位切片把输入扩回 8 bit → ADC 量化按 68 bit → 训练感知补偿回收 12 bit 的等效精度。流水账的结果是系统等效 56 bit——与 published 芯片的实测普遍吻合。这张账的用处在于定位投资方向:哪一站的损耗占比最大,哪一站就是架构改进的第一优先级;对多数设计,答案是 ADC 与器件多值能力之间的博弈,而不是器件本身的继续打磨。把精度当流水账管,是存算架构师区别于器件工程师的核心技能。
本节要点回顾
- STDP 的器件化:脉冲时间差映射到电导增减,四家族都能做,但线性度与对称性差别决定可用性。
- 两种突触两种冠军:推理权重看多值(PCM 第一),在线学习看耐久与能耗(MRAM/FTJ 第一),混装是合理架构。
- 三级放大:差分编码、位切片、读出 AGC——器件合格不等于阵列可用,精度在链路里逐级折损。
- 概率可塑性:让器件随机性替算法承担探索,是忆阻器学习硬件的独特方法论。