5.2 存内矩阵计算与 GPU 对决:能效优势还剩多少
5.2 存内矩阵计算与 GPU 对决:能效优势还剩多少
本节摘要:存算一体的核心卖点是"省掉搬运"。本节画出两套架构的对照图,把一次矩阵乘的能耗逐项拆账到器件、线、ADC、数字域四层,回答一个尖锐问题:扣掉读出与后处理,物理计算的白送能效还剩几成?
先把两套架构摆上解剖台
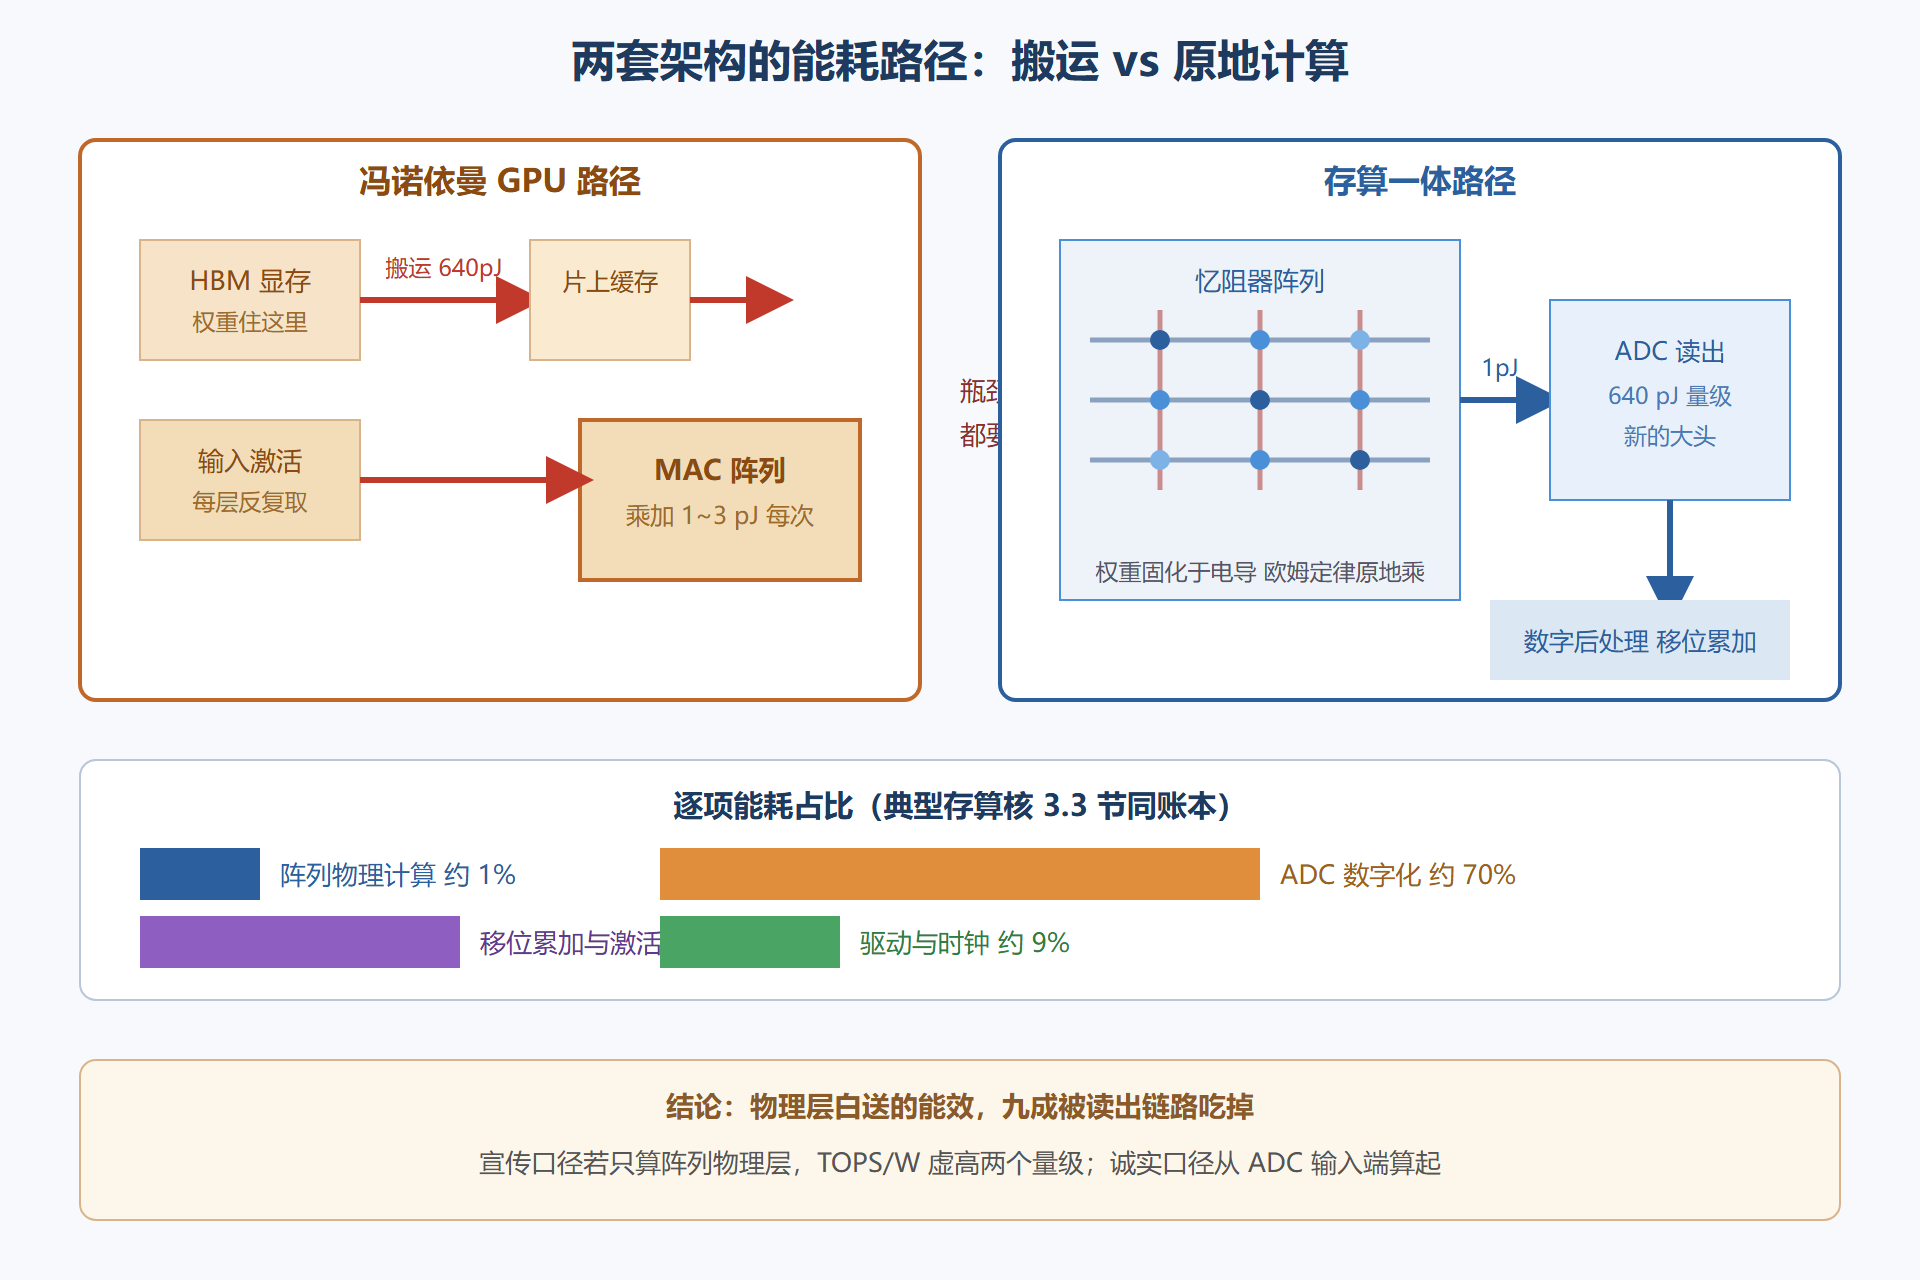
GPU 的世界:权重住在 HBM 显存里,每个计算步骤都要把数据搬到计算单元,算完再搬回——搬运能耗约是乘加本身的 1001000 倍(数据口径:45nm 工艺下,一次 32 bit DRAM 访问约 640 pJ,一次 FP 乘加约 0.93.1 pJ)。存算一体的世界:权重固化在忆阻器电导里,输入以电压形式沿行送入,物理定律在阵列内部完成乘加,数字世界只在最后读一次结果。两套架构的差别不是"快慢",而是"计算发生在数据旁边还是数据经过总线赶来"。
图:存算一体架构与冯诺依曼路径对照
能效对决的公平算法
拿 TOPS/W 数字对轰之前,先约定算法。一次 MVM 的总能耗 E_total = E_array(物理计算)+ E_ADC(读出数字化)+ E_digital(移位累加、激活、池化)+ E_io(与外界的接口)。能效 = 2×M×N / E_total(M×N 阵列一次完成 2MN 次等效操作)。典型量级(第 3.3 节拆过账):
| 架构 | 规模基准 | 每次等效操作能耗 | 折算能效 | 口径备注 |
|---|---|---|---|---|
| 28nm GPU(INT8) | 单 MAC 展开到 DRAM 访问 | 10~100 pJ/op | 0.01~0.1 TOPS/W | 含搬运 |
| 数字 NPU(大缓存) | 片上 SRAM 复用后 | 0.5~2 pJ/op | 0.5~2 TOPS/W | 搬运被摊薄 |
| 忆阻器存算(只算阵列) | E_array 口径 | 0.01 pJ/op | 数百 TOPS/W | 宣传常用口径 |
| 忆阻器存算(全口径) | E_array+E_ADC+E_digital | 1~10 pJ/op | 1~10 TOPS/W | 诚实口径 |
表里第四行是社区近年实测的落点(已发表的存算芯片实测多在 1~20 TOPS/W @ INT8)。它仍然赢了 GPU 一到两个数量级——但赢的主体不是"物理计算白送",而是"权重零搬运 + 模拟计算的低精度宽容"。叙事变了一寸,工程含义变了一丈:继续压能效的杠杆在 ADC(减位数、分时复用)而不在器件。
三个主流工程手段的分工
差分对编码:每个权重用 G⁺、G⁻ 双器件表示,列电流是两者之差。它一举处理三件事:器件共模漂移抵消、正负权重表示、以及把"器件慢漂移"从信号路径里挪出去。代价:器件数与写次数翻倍。
输入位切片:8 bit 输入不做 8 bit DAC,而是拆成 8 个位平面分 8 拍送入,结果按位权移位累加。它把 DAC 能耗降到近零,代价是延迟×8 与移位累加电路。与"输出位切片"(权重位平面由多列物理拆分)组合时,物理阵列只需 1~4 bit 器件精度即可拼出 8 bit 系统精度——这是"器件精度不够、架构来凑"的标准剧本。
训练感知补偿:误差不能消灭就让它进训练。把阵列实测的非线性、漂移、量化直接放进训练循环(hardware-in-the-loop),让网络权重学到容忍这些误差的分布。该方法让同一块芯片的推理精度提升 5~15 个百分点,是 published 存算芯片的标配流程。
能效估算工作单(拿到任何存算芯片数据时照抄) [ ] 阵列规模 M×N 与工艺节点:____ [ ] 器件精度 bit 与编码方式(差分/单端):____ [ ] 输入/输出位切片拍数:____ [ ] ADC:位数、每列共享数、每次转换能耗:____ [ ] 实测 TOPS/W 与测量的边界(含不含数字域/接口):____ 口诀:没有 ADC 配置的能效数字,默认按只算物理层处理,先打两个数量级折扣再比。
一道端到端算术题:唤醒词检测的全链路
把能效对比落到一个完整任务上。小模型关键词检测(约 100 万参数、INT8):GPU 方案从睡眠唤醒、加载权重、算一遍、回写结果,全链路能耗毫焦级,且为了响应延迟需要周期性空转;存算方案权重常驻阵列,特征流持续输入,全链路能耗微焦级,响应即算即出。两个数量级的差距里,真正来自"物理计算更快"的部分不到十分之一,其余九成来自"不搬运、不空转、不回写"——这印证本节的核心判断:存算一体的能效是系统级省钱省出来的,不是器件级算得快赚出来的。把这道题的算法记住,任何"能效提升百倍"的宣传都可以当场拆账验证:先问省的是哪一段,再问那一段在你要的任务里占多大比重。
对决的边界:GPU 不会认输
存算一体的能效优势有三个边界。边界一,任务形状:优势集中在"权重固定、矩阵乘密集"的推理;训练的反向传播需要权重高频更新与高精度,忆阻器阵列水土不服(5.1 节的 endurance 结论)。边界二,规模弹性:GPU 的算力按需伸缩,存算核的算力被阵列规模焊死,稀疏化与动态网络(跳层、早退)在固定阵列上实现困难——稀疏矩阵填进稠密阵列是纯浪费。边界三,生态位:存算芯片的现实打法是做边缘端永远在线的推理协处理器(毫瓦级唤醒词、传感器流分类),与数据中心的 GPU 不在一个拳台。认清边界,两个技术就不是对手而是分工。
⚠️ 常见坑:把 INT4/INT8 混着比。存算论文常用 INT4 甚至带符号 4 bit 报能效,GPU 对比数据却是 INT8——精度差一倍能效差近四倍。跨论文比较时先把精度对齐,再看数字。
💡 关键直觉:存算一体赢在"少搬一次家",不是"算得更准"。它的天敌不是 GPU 的性能,而是任何把权重变成"需要频繁重写"的任务——任务形状决定胜负,能效只是记账方式。
本节要点回顾
- 搬运税:GPU 路径上每个权重每次计算都要过总线,搬运能耗是乘加的百倍量级;存算一体把权重焊在电导里,从根上免税。
- 新的大头是 ADC:全口径能效 1~10 TOPS/W,其中读出数字化占约七成;只算物理层的宣传数字虚高两个量级。
- 三大工程手段:差分编码抗漂移、位切片凑精度、训练感知补偿吸收残差,三者是 published 芯片的标配。
- 边界三分:推理不吃训练、固定权重不吃动态网络、边缘协处理器不打数据中心拳台。