8.1 STA 引擎内部:图遍历与增量分析
8.1 STA 引擎内部:图遍历与增量分析
本节摘要:STA 能在亿万门上秒级响应,靠的是三件事:把电路建成扁平有向图、按拓扑序做两遍遍历(正向到达、反向要求)、以及只重算受影响子图的增量模式。本节拆开引擎的分层结构,讲清增量分析的适用边界——它正是 6.2 ECO 流程的技术地基。
一、从网表到图:引擎的第一步
读入网表后,引擎把它展开成扁平的有向图:节点是引脚(不是单元——单元内部被展开成 CLK 到 Q、D 到内部锁存等多条弧),边是时序弧,每条弧挂着从库查出的延迟与翻转表(NLDM)或电流源参数(CCS)。寄生数据(SPEF)按网络贴到互连弧上。图建成之后,电路的物理形态就退场了,剩下的是纯数学问题:在这张图上,信号最晚多久能到、最早多久能到。
两遍遍历是核心算法。正向遍历按拓扑序(所有前驱算完才算自己)累加到达时间,每个节点同时维护 max(建立账)与 min(保持账)两套值,并按到达沿的分档(同一时钟的哪个沿)分桶存放——建立与保持的比较对象不同,到达时间必须按沿对齐存储。反向遍历对称地传播要求时间。两遍相遇,每个引脚的 slack 就位。图遍历的复杂度近似线性于弧数,这是 STA 能扛住亿万门的根本。
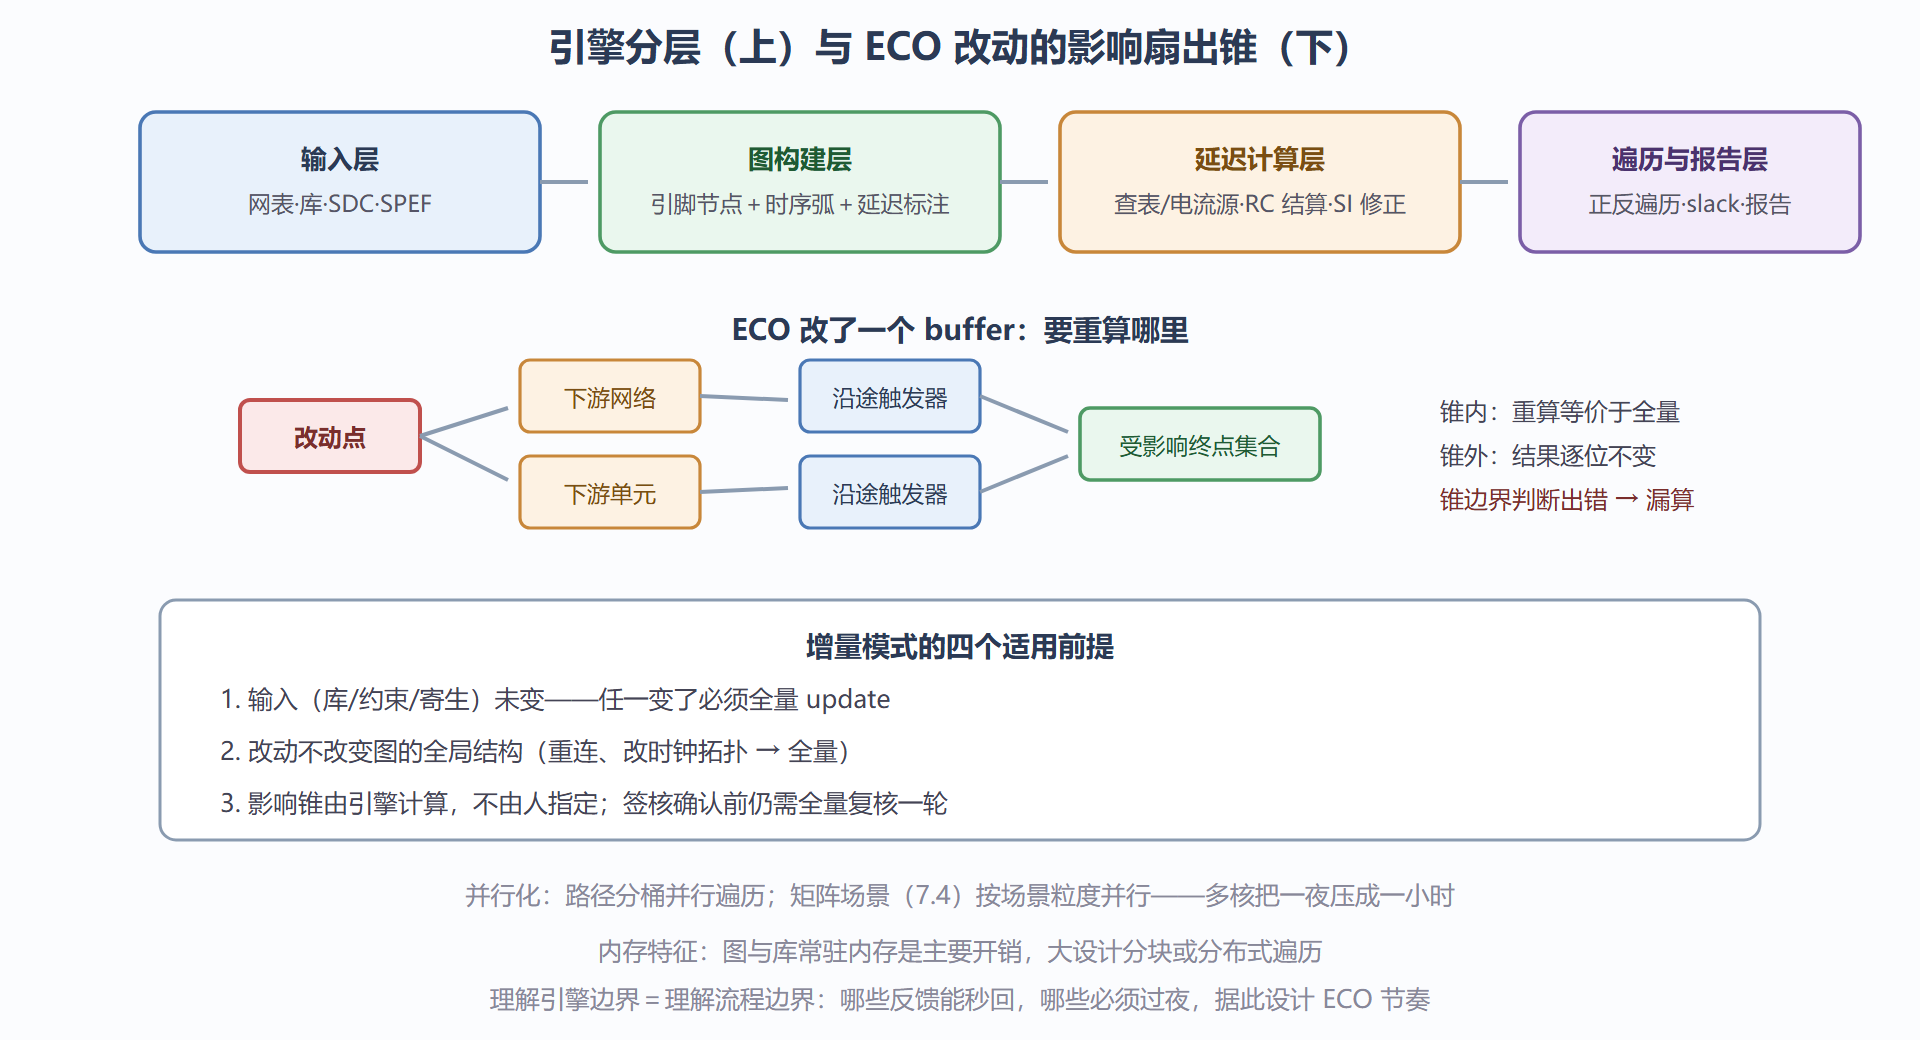
图:STA 引擎分层与增量分析的影响锥
图规模的算术与路径爆炸
引擎面对的图有多大?一颗五千万门的 SoC,引脚数按门的四倍估就是两亿节点,弧数更多。真正让问题困难的是路径条数的组合爆炸:一条 20 级、每级扇出 2 的逻辑链背后有上百万条物理通路。引擎靠"按时钟沿分桶 + 每端点只保留最坏值"把这个指数空间压成线性传播——到达时间在每个节点只留每个沿桶的最慢(与最快)值,信息损失换来可计算性。这个取舍有一个后果值得知道:报告里"第二差路径"与"最差路径"可能只差 1ps,却来自完全不同的物理通路——修复时别把它们当成同一条路的两份拷贝。
路径爆炸还解释了报告模式的取数逻辑:report_checks 按终点输出代表路径,-npaths 控制的是端点数而不是物理路径数。想看同一终点的多个次坏分支,要用专门的次坏模式——分析漏检时这是常用的深挖手段。
二、增量分析:ECO 秒级反馈的来源
全量 STA 对亿万门设计要跑数小时,而 ECO 需要分钟级反馈。增量分析的原理在 6.2 已经从流程视角看过:改动只把波纹传向下游(数据路径的正向锥)与上游(要求时间的反向锥),锥外的 slack 逐位不变。引擎维护每个节点的依赖关系,改动发生时标记受影响子图,只对子图重算。注意锥是双向的:改数据路径影响下游所有终点的到达时间,也通过终点反向影响上游要求时间——可靠的引擎用依赖图自动算锥,人为指定锥范围是漏算的温床。
增量有精确的失效条件,值得背下来:输入数据任何一项变化(库、约束、寄生)使历史结果全部作废;改动触碰时钟拓扑(插时钟缓冲、改门控)时锥会沿时钟树暴走,接近全量;SI 与 OCV 的耦合分析有自己的传播范围,增量口径与全量口径存在细微差异。因此 6.2 的纪律"签核确认前全量复核一轮"不是对工具的不信任,而是对增量数学边界的尊重。
三、工程视角:把引擎能力翻译成流程设计
理解引擎分层与边界之后,很多流程设计问题变成工程常识。矩阵为什么跑得起:场景粒度的并行让 7.4 的十个场景在一夜内消化,场景间的独立性是最好的并行切分。ECO 节奏怎么定:增量 STA 分钟级、增量绕线十分钟级、形式验证小时级——一次 ECO 回环的实际下限由最慢环节决定,与其压缩 STA,不如把改动批量化(一轮 ECO 收一批违例)。报告怎么管:分层的报告体系(全量签核报告+增量抽查报告+场景对比表)对应引擎的不同调用模式,混用会造成"用抽查报告做签核结论"的低级事故。
引擎边界还解释了工具选型的一个观察项:面对同一份 ECO 脚本,各家工具的增量速度与锥精度差异明显,评估时用自己设计的真实 ECO 样本跑,比看功能清单有用得多。
与第三章延迟计算的衔接
遍历层与延迟计算层的分工值得再咬合一遍:遍历层负责"沿图传播",延迟计算层负责"每段弧给个准数"。查表插值、线端负载分配、翻转率合并、串扰对齐修正都发生在后一层,它才是计算量大头——遍历本身很轻。这解释了签核工具性能优化的两个方向:更快的数据结构加速遍历(并行分桶),更好的增量策略减少延迟重算(只重算受影响弧的延迟与传播)。当你评估一个新 STA 引擎时,把延迟计算精度与增量边界单独测,比看整体跑分更能暴露差异——整体跑分好的引擎可能在延迟计算上偷偷用了粗化假设,而签核恰恰不能接受这种粗化。
一道综合练习
把本章能力收拢成一道练习:给定一次保持修复 ECO(在三条短路径上各插一支延迟单元),列出引擎要重算的范围——三条路径的下游终点(到达时间变化)、这些终点的上游锥(要求时间反向更新)、以及时钟树上被新单元改变的负载对应的偏斜变化(如果插在时钟附近)。答案的边界画在哪里,决定了你的增量 STA 结果能不能当成签核依据。做这道练习的最好材料是 6.2 的那份 ECO 验证清单——两章在这里完成一次闭环互证。若你能进一步说出"哪一步必须全量、哪一步增量即可、为什么",说明 8.1 已经读进了可以指导流程设计的深度——这正是本章作为"工具内功"的全部意义:不为替代工具,而为看懂工具给出的每一条边界。最后送读者一张随身卡:图会变、弧会变、库会变——凡是变了输入,历史数字一律作废;凡是没变输入,锥内重算即是全量。这两句话撑起了整个增量时代,也撑起了第八章的全部工程判断。
本节要点回顾
- 图 + 两遍遍历是引擎的心脏:正向到达、反向要求,max/min 两套值按沿分桶,复杂度近似线性。
- 增量分析的前提四条:输入未变、图结构未变、锥由引擎算、签核前全量复核。
- 锥是双向的:数据正向传播与要求反向传播都要覆盖,人为缩锥是漏算温床。
- 并行化发生在两个粒度:路径分桶与场景分块,后者让多模多角矩阵在工程时间内可跑。
- 引擎能力即流程边界:ECO 批量化、报告分层、工具评估用真实样本,都是边界的直接推论。
引擎决定了"算多快",下一个问题自然是"能不能不算"——用预测替代部分计算。下一节看机器学习在时序流程里真正站稳的几个位置。