3.7 布线:迷宫算法与协商式布线
3.7 布线:迷宫算法与协商式布线
本节摘要:布线把每条网变成真实金属几何,是物理实现的最后一步,也是唯一"必须百分之百合法"的一步。本节沿全局布线、详细布线两层结构展开:迷宫算法(Lee、A*)解决单条线的寻路,协商式布线(PathFinder 思路)解决百万条线互不相让的资源冲突,规则感知则保证结果可制造。SVG 图展示协商式布线的迭代收敛机制。学完本节,物理实现的主干流程全部走通。
两层拆分:为什么布线要分两步做
3.1 节算过一笔账:先进节点块级布线网格的节点数可达 10 的 9 次方量级,而网的数量以百万计。若每条网都在全网格上做一次完整最短路搜索,总量级是 10 的 15 次方以上的运算,不可行。工程解法与所有大规模问题一样是分层:全局布线(global routing)在粗粒度网格(每格覆盖上千轨道)上为每条网分配"走哪些区域、用哪些金属层",产出路径的粗轮廓;详细布线(detailed routing)在精确轨道网格上把轮廓落实为真实几何,处理通孔、间距、绕障的全部细节。全局层管"流量分布",避免某片区域被挤爆;详细层管"逐段合法",保证每条线走得通。两层解耦后各自的问题规模都回到可解区间。
两层之间靠"拥塞地图"通信:全局布线输出的每格使用量与容量上限的比值,就是拥塞预测。若某区域预测拥塞超过阈值,全局层要重分配流量,或反馈到布局阶段微调单元位置——物理实现的三个阶段(布局、CTS、布线)由这条反馈链串成迭代整体,而不是单向流水线。
迷宫算法:单条线的寻路内核
详细布线的每一段寻路都是 3.1 节最短路的网格特例。Lee 算法(1961)是鼻祖:从起点做 BFS 波传播,波前逐层扩展直到碰到终点,再回溯最短路径。它的保证是"存在最短路必找到",代价是波前会漫过整个空闲区域——网格上单次搜索 O(V),百万网总量不可行。工程上最关键的一项加速是 A*:用曼哈顿距离作启发下界,波前定向朝终点推进,展开节点数常降一到两个数量级(3.1 节的数字)。再往上的实用技巧是一族"有损加速":限制搜索朝向(先走主方向再绕行)、限制绕行半径、对已经拥挤的方向提高边权。它们牺牲最優性换速度,换来的是详细布线器能在数小时内完成全芯片布通。
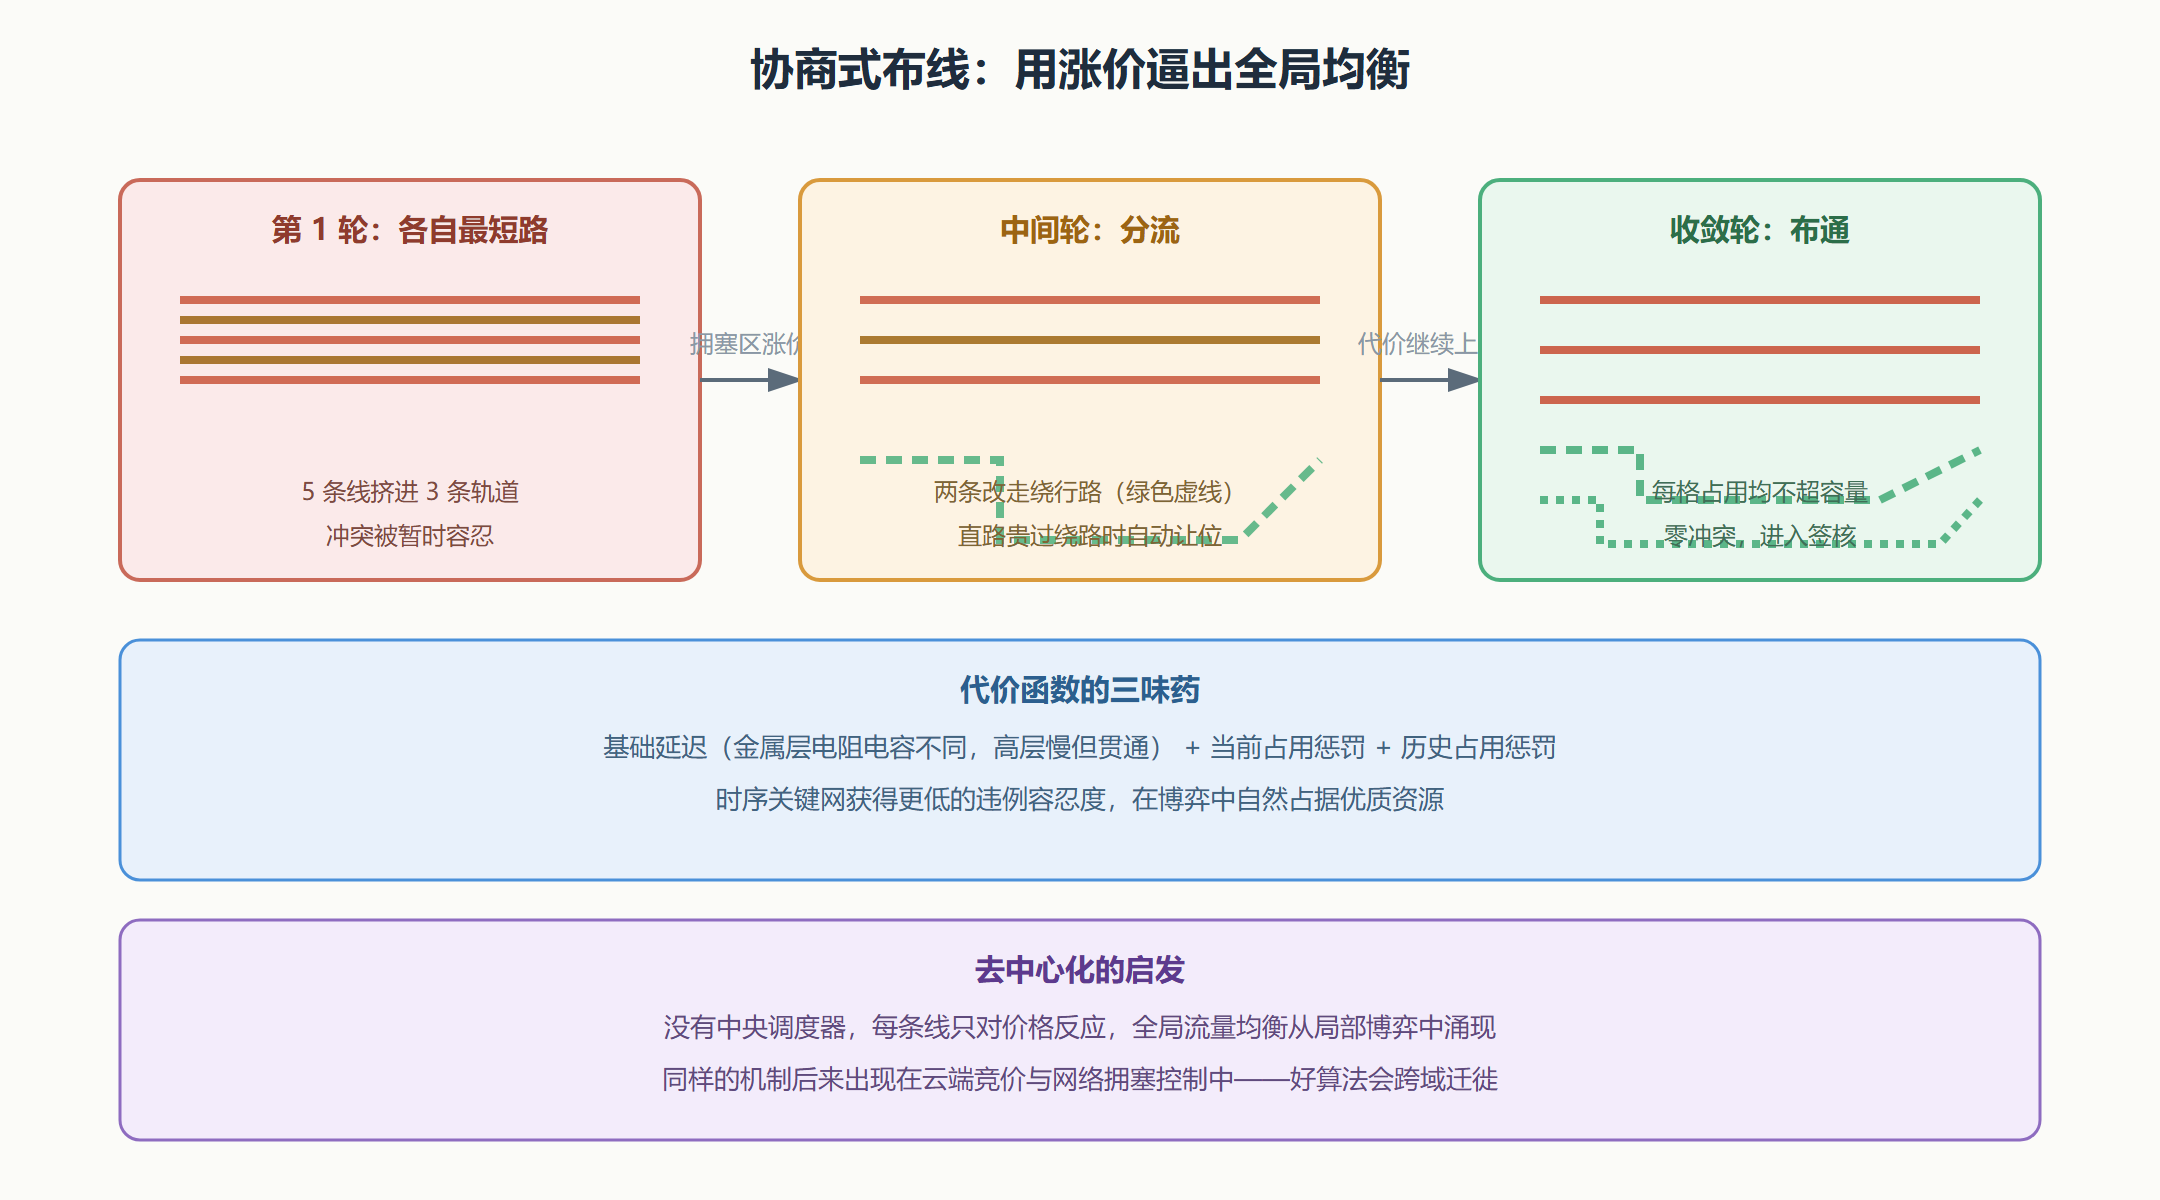
协商式布线一轮迭代(PathFinder 思路) for iteration in 1..N: // 典型 N 为 10 到 50 轮 for 每条网 net(按时序关键度排序): ripup 拆掉上一轮的布线 以动态代价做 A* 搜索: cost(边) = 基础延迟 + (占用 + 1) * 惩罚 * 拥塞历史 // 挤的地方越来越贵 重新布下这条网 惩罚 *= 增长系数 // 每轮普遍涨价 if 所有网格占用不超容量: 布通, 退出 收敛保证: 拥塞代价单调上涨, 线网被逐步逼离热点区域
协商式布线:让百万条线自己谈妥
单条网的最短路再聪明,也回答不了"两条网都要走同一条轨道时谁让路"的问题。早期方案的思路是顺序布线加事后修补(rip-up and reroute:拆掉撞车的线重布),撞车频繁时修补循环不收敛。PathFinder(1990 年代 FPGA 布线器提出,后被 ASIC 工具广泛借鉴)换了个机制:允许冲突临时存在,用逐轮上涨的拥塞代价逼线网自动分流。每轮迭代所有网都基于当前代价重布;挤在热门区域的网下一轮会发现那条路贵得离谱,主动改走稍长但空闲的路。代价函数里的"拥塞历史"项保证被占过的格子长期记仇,防止震荡。迭代持续到没有任何网格超容量——布通。
这个机制的漂亮之处在于去中心化:没有中央调度器裁决先后,每条网只对价格做反应,全局的流量均衡从局部博弈中涌现。它对时序也友好:时序关键的网可以赋予更低的拥塞容忍度(更贵的违例惩罚),从而在博弈中占优先权。协商式框架由此成为现代布线器(商业工具与开源 TritonRoute 类引擎)的公共骨架,各家差异在代价函数细节、并行化方式与规则感知深度。
图:协商式布线如何把拥塞迭代消化掉
规则感知与布通之后
详细布线的结果必须直接满足制造规则(第 4 章 DRC 会复核):最小间距、同层最小宽度、通孔排列规则、天线效应限制(金属线累积的等离子电荷可能击穿栅氧,布线时限制未连保护二极管的金属段长度)。现代布线器把这些规则内建进代价与合法性判断,做到"DRC 干净出线"而不是"先布后修"。布通之后还有布线后优化:为时序违例路径做缓冲器插入、线长微调(snaking 加延迟)、层提升(关键网换更高层金属降低电阻),这些动作与 4.1 节的静态时序分析构成"分析、修复、再分析"的循环,直到签核。至此,从 RTL 到有几何、有连线的完整版图,物理实现的主链走完——下一章开始回答:凭什么相信它达标。
层分配的账再算细一点:高层金属厚而宽、电阻低一个数量级,但节距大、轨道少;低层反之。一条关键网从最低两层换到中高层,自身延迟可降三到五成,但占掉的稀缺高层轨道会让别的网更挤——布线器的层分配因此是全局博弈的一部分,协商框架同样管它:给高层轨道定价,时序关键网出得起价就上,普通网自动留在低层。通孔的电阻也远高于同长度导线(一个通孔抵几条到几十条线段的电阻),少打一层通孔的收益常被新手低估。
布通率与迭代轮数的工程数字给一组参考:一个规划合理的块级设计,协商式布线通常在十到二十轮内布通;而布局留下的硬伤(某区域密度超限、宏单元把通道堵死)会让迭代迟迟不收敛——布线器轮数暴涨是布局问题的晚期症状。所以看布线报告的正确姿势是先看"拥塞热图"再看违例清单:热图告诉你问题是局部的还是全局的,清单告诉你修复的优先级。热图上一片红加清单干净,说明还有余量;热图干净加清单有违例,多半是零星的规则细节,自动修复即可收尾。
本节要点回顾
- 两层拆分:全局布线管流量分布,详细布线管逐段合法,规模各自回到可解区间。
- 迷宫内核:Lee 算法保证最短但波前漫溢,A* 用曼哈顿下界省一到两个数量级展开。
- 协商式机制:冲突暂容忍、拥塞逐轮涨价、线网自动分流,收敛到零冲突。
- 代价三味药:基础延迟加占用惩罚加历史惩罚,时序关键网靠容忍度参数占优先权。
- 规则内建:间距、通孔、天线规则在布线时满足,追求 DRC 干净出线。
- 流程闭环:布通后插入缓冲器、加蛇形线、升层优化,与 STA 构成修复循环。