3.2 隐藏类与内联缓存
3.2 隐藏类与内联缓存:引擎给对象发的身份证
本节摘要:为了让动态对象的属性访问接近静态语言的速度,引擎给「形状相同」的对象分配共享的隐藏类,把属性名编译成偏移量;再配合内联缓存(IC),让重复访问同一形状的代码直接按缓存记录取值。代价是:对象形状一旦混乱——乱序添加属性、随意删除属性、中途改原型——转移链分叉、缓存未命中、优化退场。本节拆解这套加速器的结构与失效条件,给出可执行的形状稳定清单。
热循环里的减速带
先看一个能直接感知的现象:
function readX(p) { return p.x; } const stable = []; for (let i = 0; i < 100000; i++) stable.push({ x: i, y: i * 2 }); const messy = []; for (let i = 0; i < 100000; i++) { const o = {}; o.y = i; // 先加 y o.x = i; // 再补 x,顺序与 stable 相反 messy.push(o); } console.time('stable'); for (const p of stable) readX(p); console.timeEnd('stable'); // 实测约 0.9 ms console.time('messy'); for (const p of messy) readX(p); console.timeEnd('messy'); // 实测约 1.6 ms(形状不同缓存分裂)
两组数据内容完全一样,只因为属性添加顺序不同,读同一属性的耗时拉开近一倍(不同机器数值不同,比例稳定)。这不是玄学,是引擎的形状追踪在起作用:stable 里十万对象共享同一条隐藏类路径,messy 里也是十万对象但走了另一条路径,readX 的内联缓存要么分裂成多态,要么在两种形状间来回抖动。
一、隐藏类:给动态对象定型
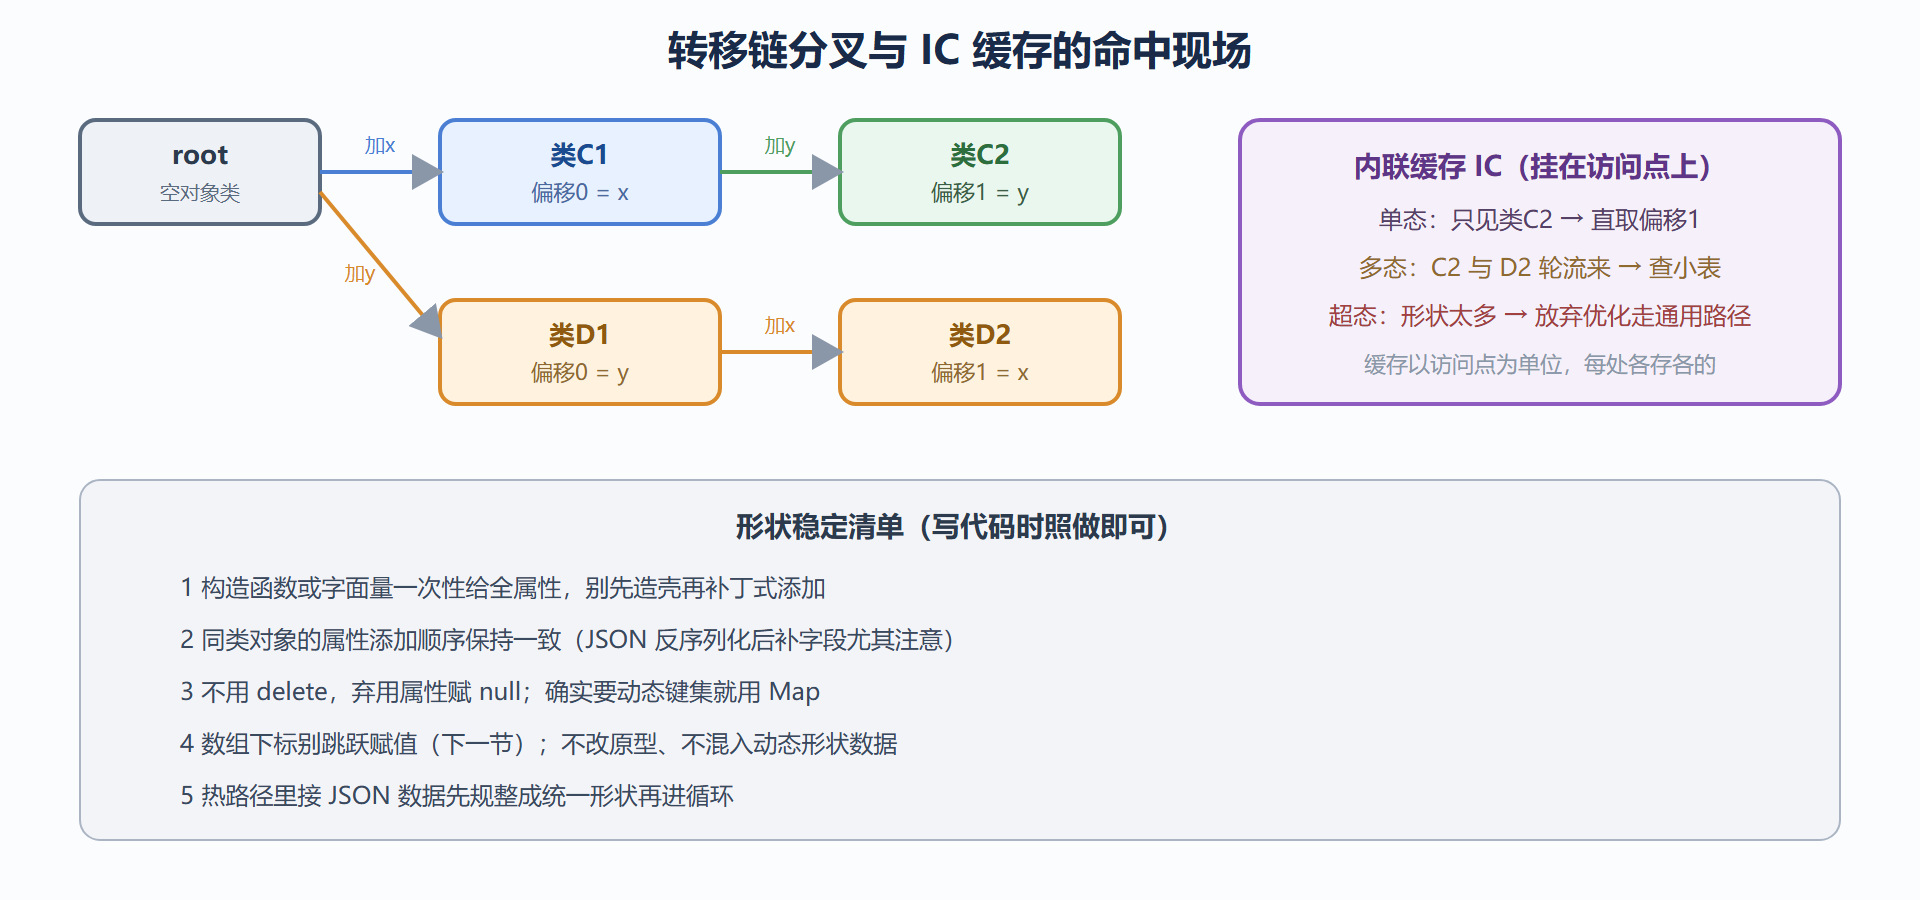
JavaScript 对象在语言层面是「随时可加减属性的袋子」,但引擎发现绝大多数代码里的对象其实形状固定。于是 V8 在内部为每种形状维护一个隐藏类(hidden class,V8 文档称 map):类里记录「属性名 → 存储偏移量」的映射。对象第一次添加属性时,引擎从空的根类出发派生一个新类;再添加一个属性,再派生——形成一条转移链。
function Point(x, y) { this.x = x; this.y = y; } const p1 = new Point(1, 2); const p2 = new Point(3, 4); // p1 与 p2 共享同一条转移链:root → 有x → 有x有y // 访问 p2.y 时,引擎从隐藏类里直接拿到偏移量,等价于 C 结构体取字段
两个 Point 实例共享链,属性访问被编译成「按偏移量直取」的机器码——这就是动态语言跑出静态速度的秘密。而下面这段把链掰断了:
const a = {}; a.x = 1; a.y = 2; // 链:root → x → y const b = {}; b.y = 2; b.x = 1; // 链:root → y → x(另一条链!)
a 与 b 内容相同、链不同。对引擎来说它们是两种形状,缓存与优化无法共享。同理,中途删属性(delete a.x)会把对象推向更糟的「字典模式」——属性表退化成哈希查找,偏移量优化全部作废。实测对比:
const c = { x: 1, y: 2, z: 3 }; function getX(o) { return o.x; } let s = 0; console.time('before-delete'); for (let i = 0; i < 1e7; i++) s += getX(c); console.timeEnd('before-delete'); // 实测约 22 ms delete c.x; console.time('after-delete'); for (let i = 0; i < 1e7; i++) s += getX(c); console.timeEnd('after-delete'); // 实测约 70 ms(退化后再读,慢了两倍多)
delete 之后 c 的形状被破坏,getX 的缓存策略被迫调整,同一行代码肉眼可见地变慢。「不想要的属性设为 undefined 或 null,不要 delete」这条风格建议的引擎层理由就在这里。
图 3.2-1 隐藏类转移链与内联缓存
二、内联缓存:记住上次在哪找到的
隐藏类解决「属性在哪个偏移」,内联缓存解决「这个访问点上次遇到的是什么类」。每个属性访问点(比如循环里那句 p.x)都挂着一份缓存:第一次执行时记录下当时的隐藏类与偏移,下次执行先比对类——相同就直接按记录取值,属性查找被跳过;不同则缓存升级为多态(存几组记录)或超态(放弃,走通用查找)。
缓存的状态直接对应性能:单态最快(一行代码只伺候一种形状),多态次之,超态等于没有缓存。这也解释了为什么「属性添加顺序不同」会慢:readX 的缓存在两种形状间切换,永远到不了稳定的单态。
一个反直觉的推论:多态并非总由你自己的代码造成。第三方库与你的代码操作同名不同形的对象(都在叫 point,字段集合却不同),热路径上混合出现,缓存同样分裂。框架作者对此的标准做法是「归一化入口」:接收外部数据后立即映射成内部统一形状,之后的热循环只面对一种形状。你在写数据处理管道时值得照搬。
数组也是一种对象,但有专属的元素存储优化,下标访问不走隐藏类路径——这正是下一节的主题。
三、两个真实案例
案例一:JSON 接口数据的形状漂移。 后端按字段有无返回不同结构(某些记录有 remark 字段、某些没有),前端循环里统一读 remark。缓存被迫多态甚至超态。修法是入口处规整:
const normalized = rows.map(r => ({ id: r.id, remark: r.remark ?? '' // 缺的字段补默认值,形状拉平 }));
案例二:构造器里的条件属性。
function Shape(type) { this.type = type; if (type === 'circle') this.radius = 1; if (type === 'rect') this.w = 1, this.h = 1; }
circle 与 rect 走不同转移链本是合理设计,但若热路径同时处理两者,访问点缓存多态。更稳的做法是两类对象共享字段集(rect 也留 radius 为 null),或干脆分两个数组分两段循环——让每个循环各自单态。
💡 关键直觉:把对象当 C 结构体看待——同类对象字段一致、顺序一致、不中途删改。引擎已经替你做了静态化,你只需要别把静态性亲手拆掉。
- 隐藏类记录形状到偏移量的映射,同链对象共享,访问被编译成直取偏移;
- 属性添加顺序是链的一部分,顺序不同即形状不同,缓存跟着分裂;
- delete 会推向字典模式,弃用字段赋 null,动态键集用 Map;
- IC 以访问点为单位,单态最优,混形状是超态的直接原因,外部数据先归一化;
- 热路径只喂一种形状,必要时按形状分组、分段循环。
形状稳定的重构实例
一段典型的「接口数据直接进热循环」代码,重构前后对照:
// 重构前:字段按后端心情出现,热循环里形状漂移 function renderBad(rows) { for (const r of rows) { // remark 字段时有时无,extra 字段部分记录才有 if (r.extra && r.extra.vip) highlight(r.name); else if (r.remark) annotate(r.name, r.remark); else plain(r.name); } } // 重构后:入口一次归一,循环只见一种形状 function normalize(row) { return { name: row.name ?? '', vip: Boolean(row.extra && row.extra.vip), remark: row.remark ?? '' }; } function renderGood(rows) { const items = rows.map(normalize); // 归一化是一次性成本 for (const it of items) { if (it.vip) highlight(it.name); else if (it.remark) annotate(it.name, it.remark); else plain(it.name); } }
归一化层带来三份收益,性能只是其一:字段语义集中在一处(改名只动一个函数);缺省值显式化(空字符串与布尔取代 undefined,判断不再三心二意);循环体拿到形状保证,引擎缓存稳定在单态。这个模式值得成为团队处理外部数据的默认动作——边界处规整,内核里放心。
需要看引擎内部证据时,V8 有个调试手段(需要特殊标志启动,仅用于学习验证)可以打印对象的隐藏类信息,能直观看到同一构造路径的对象共享类、乱序添加的对象各奔东西。日常工程用不上它,但知道这个观测口存在,有助于建立「形状是真实数据结构」的信念。
常见问答
Map 和对象,哪个对形状机制更友好?
键集合动态变化的场景,Map 天生就是为它设计的:哈希查找、键任意类型、迭代顺序稳定,完全不经过隐藏类机制。反过来,固定字段集(一个用户、一个配置项)用对象,吃形状优化。选型口诀:字段可枚举且固定用对象,键是运行时数据用 Map——把字典硬塞进对象,就是逼引擎在两个体系间来回切换。
delete 到底慢在哪,有多慢?
delete 触发形状降级(可能进字典模式),后续访问从「按偏移直取」退化为「查哈希表」。慢的量级取决于访问频次:一次删除本身不贵,贵的是之后成千上万次的降级访问。替代方案「赋 null」保留形状、只是值变了,访问速度不变——代价是属性还在枚举里出现,语义上要能接受「占位」。
JSON.parse 出来的对象是什么形状?
引擎对 JSON 反序列化有专用快路径,产出的对象通常一次成型、形状统一(同一字符串结构反复解析时尤其明显)。所以「接口数据形状漂移」的元凶常常不是 parse,而是后续代码补字段、不同接口混流。归一化层放在「多来源数据汇合处」最划算,而不是每个消费点各写一遍防御。
Object.freeze 会影响隐藏类吗?
冻结本身不降级形状(属性集合固定反而利于定型),但冻结对象的写入会静默失败或严格模式抛错。相关注意两点:freeze 是浅冻结,嵌套对象仍可变,深冻结要递归;冻结与密封(seal)在「想锁形状」的意图上比 delete 补丁好得多——它们把意图显式化,引擎与同事都能读到。真需要完全动态的键集,Map 才是正解,别跟对象较劲。
怎么确认自己的对象形状是稳定的?
三个实操信号:构造函数里一次给全字段(读代码就能确认);打印对比有调试标志的环境下同类实例的内部形状信息一致;最直接的是性能——形状稳定的热路径在稳态测量里显著平稳,形状漂移的代码不同轮次波动大。日常开发用第一条「目测构造路径一致」就够了,那是形状稳定的最强保证。
构建与转译会影响隐藏类吗?
不会引入形状问题,但可能掩盖它。转译器输出的类与对象语义等价(class 还是构造器加原型的包装),形状机制照常工作。真正要警惕的是「多个源文件构造同形对象」的约定被时间侵蚀——A 文件先加 x 再加 y,B 文件后来加了字段顺序不同,各自都没错,汇合到同一个热循环才见分账。所以归一化层最好只有一处、一个负责人。
接口字段顺序变化会破坏形状吗?
字段顺序本身不进形状(形状关心的是「属性集合与添加路径」),JSON 字段顺序变化通常无碍。真正破坏形状的是字段有无与后续补字段的顺序——这正是归一化层要拉平的两件事。顺带一个实用结论:后端序列化保持字段集合稳定,比保持字段顺序稳定重要得多。
类继承会影响隐藏类效率吗?
class 的实例天然形状统一(构造器路径固定),这是 class 相比「手工对象工厂」的一个隐性性能优势。继承层次深不直接伤性能(查找沿原型链,第 3.1 节),但每层构造器若各自添加字段,实例的形状路径就是「逐层叠加」——依然稳定,仍然单态友好。真正要防的还是第 3.1 节末尾那条:运行时 setPrototypeOf 与动态混入,它们才是形状机制的天敌。
至此,「查得对」与「查得快」都有了着落。下一节把同样的引擎视角转向最常用的集合——数组:它的元素形态与空洞,决定了那些高频方法的真实代价。