3.3 数组方法的引擎代价
3.3 数组方法的引擎代价
本节摘要:数组在引擎里是一块按元素类型优化的连续存储——纯小整数、双精度数、普通对象各有专属形态,混装与空洞会让存储降级。本节从存储形态出发重讲数组:为什么下标访问是 O(1)、空洞有多特殊、map、filter、reduce 各自扫描几遍、splice 为什么是 O(n),以及类数组与真数组的转换代价,最后给出高频场景的方法选型表。
两个数组的不同命运
const nums = [1, 2, 3, 4, 5]; nums.push(6); // 元素形态不变,尾部追加,均摊 O(1) console.log(nums.length); // 6 const mixed = [1, 2, 3]; mixed.push('四'); // 存储从「打包整数」降级为「通用元素」 mixed[10] = 11; // 制造 3..9 七个空洞 console.log(mixed.length); // 11 console.log(mixed[7]); // undefined(空洞读值) console.log(7 in mixed); // false(in 检查的是槽位存在性)
mixed[7] 与 7 in mixed 的分裂是本节的第一个关键:读空洞得到 undefined,不代表槽位存在。引擎对空洞数组维护一张「哪些槽位真实存在」的信息,遍历时遇到空洞的行为取决于方法(forEach 与 map 会跳过空洞,for 循环与展开运算符会读出 undefined):
const holes = [1, , 3]; console.log(holes.map(x => x * 2)); // [2, 空, 6](空洞被跳过,结果仍是稀疏的) const dense = Array.from(holes, x => x ?? 0); console.log(dense); // [1, 0, 3](Array.from 补齐了空洞) console.log(holes.length, Object.keys(holes).length); // 3 2(只有两个真实槽)
一、元素形态:引擎给数组的分型
V8 按当前内容给数组分元素类型:全 SmallInteger 的打包形态(PACKED_SMI_ELEMENTS)、含双精度的打包形态(PACKED_DOUBLE_ELEMENTS)、混合值的打包形态(PACKED_ELEMENTS),以及各自的 HOLEY 版本。转换是单向劣化的:整数数组塞进一个小数,全体按双精度重存;再塞一个对象,按通用指针重存。只升不降——即使后来删掉那个字符串,形态也不会升回去。
const a = [1, 2, 3]; // 打包整数 a.push(1.5); // 降为打包双精度 a.push('x'); // 降为打包通用 const b = [1, , 3]; // 直接就是带洞整数
对日常代码的影响集中在三处:排序(整数数组有专用快路径,通用数组走比较函数路径,实测差数倍);数值累计(map 后 reduce 的链路上若混入 undefined,会把整条链推向通用形态);内存(打包双精度连续存值,通用形态存指针再指向堆,内存翻倍且缓存不友好)。数字密集的计算(画布顶点、动画参数)保持数组纯净是低成本高回报的习惯。
实测感受差距:
const intArr = Array.from({length: 200000}, (_, i) => i); const mixArr = intArr.slice(); mixArr[100000] = '污染点'; // 一颗老鼠屎,整条数组降级 console.time('sort int'); intArr.slice().sort((x, y) => y - x); console.timeEnd('sort int'); // 实测约 26 ms console.time('sort mix'); mixArr.slice().sort((x, y) => y - x); console.timeEnd('sort mix'); // 实测约 43 ms,且比较函数要做类型仲裁
图 3.3-1 数组元素形态与降级路线
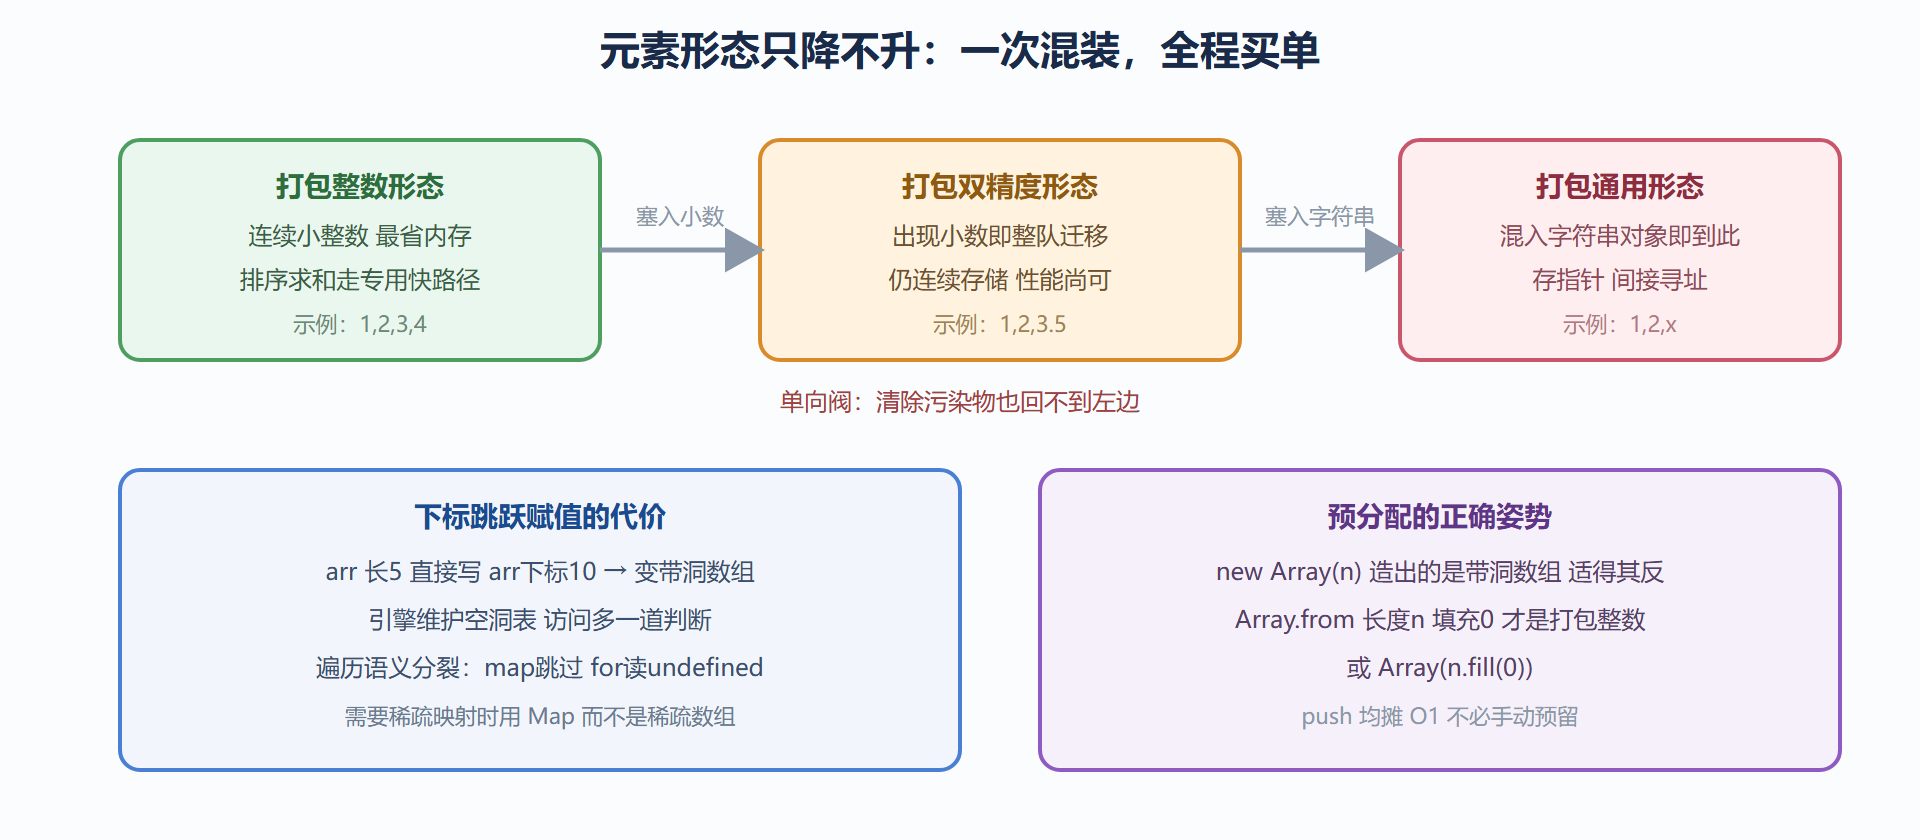
二、常用方法的扫描账本
高阶方法的语义可以统一理解为「引擎替你写的循环」,但每个方法的扫描次数与新建数组次数不同,写热路径时心里要有这本账:
| 方法 | 扫描次数 | 产物 | 适用判断 |
|---|---|---|---|
| map | 1 | 等长新数组 | 一对一变形 |
| filter | 1 | 不定长新数组 | 筛选保留 |
| reduce | 1 | 累计值 | 聚合出任意结果 |
| find / findIndex | 最多1(提前停) | 元素或下标 | 找第一个命中 |
| some / every | 最多1(短路) | 布尔 | 存在性判断 |
| forEach | 1 | 无 | 纯副作用 |
| sort | 内部排序 | 原地重排 | 需要有序 |
| splice | 1(移动尾部) | 被删元素数组 | 中间插删,O(n) |
三个实务推论。链式调用多扫几遍:arr.filter(...).map(...) 扫两遍、建两个中间数组;超大数据集可换成 reduce 一次成形,或直接 for 循环——可读性与性能在此需要权衡,常规业务量级放心用链式。sort 的比较函数别偷懒:默认按字符串比较,[10, 9, 1].sort() 得 [1, 10, 9],数字排序必须 (a, b) => a - b;sort 还会先把空洞与 undefined 挪到末尾。splice 是最贵的常规操作:中间删一个元素,后面全体前移;队列场景用 shift 同理(头部删除全体前移),高频队列改用指针下标或双端结构。
// 高频队列的正确姿势:头指针前移,不真删 const queue = { data: [], head: 0 }; queue.data.push('a', 'b', 'c'); console.log(queue.data[queue.head++]); // a console.log(queue.data[queue.head++]); // b // 队列过长时定期 slice 落盘整理
三、类数组、展开与拷贝的代价
arguments、DOM 节点集合这些「有 length 有下标但没有数组方法」的类数组,转真数组有三条路:Array.from(x)(可带映射函数,推荐)、[...x](要求可迭代)、Array.prototype.slice.call(x)(老代码)。其中展开运算符走迭代器协议,每次取值都是一次协议调用,对超长集合不如 Array.from 直接。
浅拷贝与深拷贝同样有引擎账:arr.slice() 与 [...arr] 都是浅拷贝一层;structuredClone(arr) 递归拷贝可结构化内容,比 JSON 往返(JSON.parse(JSON.stringify(arr)))安全——后者会丢函数、undefined、Symbol,把 Date 变字符串,但速度通常更快。选型口诀:纯 JSON 数据的快照用 JSON 往返;含 Date、Map、循环引用的对象用 structuredClone。
最后用 dispose 场景串一遍本章三节:处理一批接口数据时,先归一化字段形状(3.2 的清单)、保持数值数组纯净(本节)、用 map/filter 表达清晰意图、热路径才手写循环——形状、类型、算法三层都照顾到,引擎才有充分发挥的空间。
- 元素形态单向劣化:整数→双精度→通用,混装一颗污染全程;
- 空洞是真实概念:读 undefined 与 in 为 false 可区分,稀疏需求交给 Map;
- new Array(n) 造洞,预分配用 Array.from 填充或直接 push;
- 链式调用按扫描次数计账,sort 必须给数字比较函数,splice 与 shift 是 O(n);
- 类数组转换首选 Array.from,深拷贝选 structuredClone 而非 JSON 往返。
一道链式题的代价审计
给定一段常见的数据管道,先审计再优化:
// 需求:取前 200 条激活记录的名称,去重,保持出现顺序 const result = records .filter(r => r.active) .slice(0, 200) .map(r => r.name) .filter(n => !seen.has(n) && seen.add(n)); // seen 是外部 Set
审计账本:第一遍 filter 扫全量(十万条就扫十万);slice 建一个至多两百条的浅数组,便宜;map 再扫两百;最后的去重 filter 又扫两百。总计一次全量扫描加三次小扫描、两个中间数组——瓶颈在第一遍全量 filter,后面的链节都是零头。优化应改写成「找到两百条就停」:
const seen = new Set(); const result2 = []; for (const r of records) { if (!r.active) continue; if (seen.has(r.name)) continue; seen.add(r.name); result2.push(r.name); if (result2.length === 200) break; // 够数即停 }
单循环版本最多扫到「凑够两百条」的位置就收工,数据量大且激活记录靠前时快一个数量级。两种写法的取舍也很典型:链式版表达清晰、在常规量级毫无压力;手写版牺牲一点可读性换提前终止。判断标准回到第 4 章的老话——先测量,数据量与分布说话。
再送一个「方法陷阱」的实操题:['1','2','3'].map(parseInt) 输出什么?实测是 [1, NaN, NaN]——map 给回调传三个参数(值、下标、数组),parseInt 的第二参是进制,下标 1 与 2 分别把后续字符串按一进制、二进制解析,全部失败。修法 map(s => parseInt(s, 10)) 或 map(Number)。这类「参数形状不匹配」的坑还有 map 配 replace(第二参是匹配信息对象),同源同解。
常见问答
arguments 还值得学吗?
新代码用剩余参数(...args)全面替代:它是真数组、箭头函数也支持、不阻碍引擎优化。arguments 剩下的存在意义是读老代码(callee 与 length 的历史用法)与极少数「形参个数敏感」的场景。两者别混用——把 arguments 传给别的函数是明确的反优化信号。
为什么 sort 默认按字符串比较?这种设计图什么?
历史包袱。设计之初的定位是「通用容器里什么都能排」,字符串序是唯一对全类型有定义的全序。后果是数字排序必须显式给比较函数,规范已不可能改(兼容性)。工程对策是把比较函数当标配写法:数字用减法、中文按拼音用本地化比较器、对象按字段链比较,团队里立一条「sort 必带比较函数」的规约最省心。
超大数据集上链式不行,那用什么组织代码?
三个层次递进:数组量级在十万以内,链式随意;百万级,reduce 单遍或生成器流水线(每条数据流过全部工序,不建中间数组);更大或需要流式处理,把数据交给异步迭代(for await)或 Worker 分片。链式写法的本质成本是「每个中间数组的内存与额外一趟扫描」,量级上来后这两项都会被放大。
数组空位在新旧规范下行为一致吗?
不完全一致,这正是「空位」被反复劝退的原因。规范在演进中逐步收敛了多数方法的语义(map、forEach、filter 跳过空位,join 与 include 把空位当 undefined),但个别方法历史上各有解释,老引擎上差异更多。工程结论不变:别制造空位——需要占位用显式的 undefined 或 null(它们是真实的值,行为处处一致),需要稀疏映射用 Map。空位是「省了一个格子」换来「一整类语义分歧」,这买卖不划算。
flat、flatMap、at 这些新方法值得用吗?
值得,它们都在填补长久的表达缺口:flat 展平嵌套数组(默认一层,参数控制深度);flatMap 等价 map 后 flat 一层,一次遍历完成「变形加展平」;at 支持负下标从尾部取(at 负一 取最后一个,替代 slice 与长度运算的组合拳)。三者都是纯函数式操作、返回新数组,与本章的代价模型完全兼容。按浏览器兼容要求酌情引入即可,现代目标环境都已支持多年。
从存储形态选数据结构:数组、Map、Set 的分工
把引擎视角贯彻到底,三种集合的选型可以完全按「键的形态与操作」推出来:
数组:键是连续小整数(下标),读多写尾部。享受打包存储与下标直取,是「有序列表」的唯一正解。需要频繁中间插删时它就不再是好选择——那是队列与链表的领地,而 JavaScript 没内置链表,用数组加指针(第 3.3 节的 queue 技巧)或分块结构近似。
Map:键是运行时数据(字符串标识、对象引用、混合类型),需要有序遍历与长度查询。哈希查找、任意键类型、插入序遍历、size 直读——四个能力全是对象字典的痛点。对象当键时还能吃到 WeakMap 的自动回收联动(第 6 章)。
Set:语义是「存在性」,只要「有没有」不要「是什么」。成员唯一性自动维护,has 近似常数,交并差的实现就是一行 filter 加 has。用数组模拟 Set(includes 判存在)在量大时是平方复杂度,是典型的「数据结构选错」事故。
const seen = new Set([1, 2, 2, 3]); console.log(seen.size, seen.has(2)); // 3 true console.log([...new Set('aabbc')].join('')); // abc(字符串去重的惯用一行) const counts = new Map(); for (const ch of 'abca') counts.set(ch, (counts.get(ch) ?? 0) + 1); console.log([...counts]); // [ ['a',2], ['b',1], ['c',1] ]
三个集合之间还有两条「翻译通道」要熟悉:数组去重走 Set 再展开(保序);Map 与对象互转用 Object.fromEntries 与 Object.entries。日常决策树一句话:下标找数组、任意键找 Map、只问存在找 Set——先选对结构,再谈算法优化,顺序反了都是白忙。
TypedArray 和普通数组是什么关系?
面向二进制与数值计算的兄弟类型:定长的类型化视图(Int32Array、Float64Array 等),直接映射底层缓冲区,没有空洞、没有混装、长度不可变。图像像素、音频采样、网络协议解析、与显卡交互的数据准备,都是它的主场——这些场景里它比普通数组快数倍且省内存。代价是没有 push 与 splice 的灵活性、元素类型单一。把它当「数值密集场景的专用容器」记住即可,普通业务列表继续用普通数组。
对象与数组两条线至此合流:形状稳定、元素纯净、结构选对,是第 6 章性能清单的前三项。带着这套存储视角,下一章进入 JavaScript 最著名的调度现场——事件循环。