2.1 白盒攻击 FGSM PGD与CW
2.1 白盒攻击 FGSM PGD与CW
本节摘要:白盒攻击假设攻击者完全知道模型(结构、权重),因此能用梯度直接优化对抗样本。这节讲三个标志性算法:FGSM(Fast Gradient Sign Method)是最简单的单步攻击——沿梯度符号方向走一步,快但强度有限;PGD(Projected Gradient Descent)是迭代版——小步走多步、每步投影回扰动约束内,被当作最强一阶攻击的基准;CW(Carlini-Wagner)基于优化——把攻击建成优化问题求解,成功率最高但计算最贵。三者代表白盒攻击从简单到强的演进,理解它们既是攻击的基础,也是评估防御的标准——你的防御至少要扛得住 PGD。
先说结论
阅读完本节,你应当能够:
- 写出对抗样本生成的优化目标
- 说清 FGSM 的单步梯度原理和它的局限
- 描述 PGD 的迭代投影机制,为什么它是最强一阶攻击
- 解释 CW 攻击的优化思路和它为什么成功率高
- 理解扰动范数(L0/L2/Linf)对攻击的影响
一、问题与直觉
假设你是一个攻击者,拿到了一个图像分类模型的完整权重。你想构造一张对抗图片,让模型把熊猫认成长臂猿。你怎么找这张图片?
最直觉的想法:随机改像素,改到模型认错为止。但这效率极低——图片有十几万像素,随机搜索几乎不可能找到正确的小扰动组合。
聪明得多的办法是利用梯度。模型的可微性告诉我们:哪个方向改变输入能让输出变化最大。算一下损失函数对输入的梯度,沿着让损失增大(让模型更可能出错)的方向走一小步,就能用最小的扰动产生最大的误导。这就是所有基于梯度的白盒攻击的核心思想。
FGSM 是这个思想最简单的实现——走一步。PGD 是更细致的版本——走很多小步。CW 则把它建成一个严格的优化问题求解。它们越来越强,也越来越贵。本节拆解这三个算法。
二、核心原理
2.1 对抗样本的优化目标
先把攻击建成数学问题。给定原始输入 x(正确标签 y)、模型 f,我们要找扰动 δ,使得加扰动后的输入 x+δ 让模型出错,同时 δ 要足够小(人眼看不出变化)。
非定向攻击(让模型输出任意错误)的目标:在扰动预算 ε 内,让模型对 x+δ 的预测偏离 y。
扰动"足够小"用范数度量。常见的有三种:
| 范数 | 含义 | 攻击特点 |
|---|---|---|
| Linf | 每个像素变化都不超过 ε | 均匀微小扰动,最常用 |
| L2 | 所有像素变化的平方和的根不超过 ε | 集中在少数像素 |
| L0 | 变化的像素个数不超过 ε | 只改极少数像素 |
Linf 最常用,因为它产生的扰动最"均匀"——每个像素都只动一点点,最接近"人眼不可见"。L0 攻击只改少数像素,但每个像素可能改动较大。
2.2 FGSM 单步梯度攻击
FGSM(Fast Gradient Sign Method)是最简单的白盒攻击。它的思路:算一次损失对输入的梯度,取符号(正负一),乘以扰动预算 ε,加到输入上。一步搞定,所以叫"单步"和"快"。
# FGSM 的核心:一步梯度符号攻击 def fgsm(model, x, y, epsilon): x.requires_grad = True output = model(x) loss = cross_entropy(output, y) loss.backward() # 算损失对输入的梯度 # 沿梯度符号方向加扰动 让损失增大 即让模型出错 x_adv = x + epsilon * x.grad.sign() return x_adv.detach()
为什么用梯度符号而非梯度本身?因为不同特征的梯度量级差异大,用原始梯度会让扰动集中在大梯度特征上,而用符号让每个维度都走同样大小的 ε 步长,扰动更均匀(符合 Linf 约束)。
FGSM 的优点是极快(一次前向加一次反向),适合快速评估。缺点是强度有限——只走一步,很多模型用稍强的防御就能挡住。它是入门基准,不是最强攻击。
2.3 PGD 迭代投影攻击
PGD(Projected Gradient Descent)是 FGSM 的迭代加强版。它不是走一大步,而是走很多小步——每步走 α(步长,比 ε 小),然后把累积扰动投影回 ε 球内(保证总扰动不超预算)。
# PGD 的核心:迭代走小步加投影 def pgd(model, x, y, epsilon, alpha, steps): x_adv = x + random_perturbation(epsilon) # 随机起点 for _ in range(steps): x_adv.requires_grad = True output = model(x_adv) loss = cross_entropy(output, y) loss.backward() # 走一步 x_adv = x_adv + alpha * x_adv.grad.sign() # 投影回 epsilon 球内 且不超出合法像素范围 x_adv = clamp(x_adv, x - epsilon, x + epsilon) x_adv = clamp(x_adv, 0, 1) # 像素值合法范围 x_adv = x_adv.detach() return x_adv
PGD 比单步的 FGSM 强得多,因为它能更精细地探索扰动空间,找到让模型出错的更优扰动。它被广泛当作"最强的一阶攻击"(基于梯度的攻击里最强的),是评估模型鲁棒性的标准基准——如果你宣称自己的模型鲁棒,它至少要扛得住 PGD 攻击。
PGD 的两个关键超参:步长 α 和迭代次数 steps。步长太大容易跨过最优、太小收敛慢。实践中通常步长设为 ε 的几分之一,迭代几十步。另外,PGD 从随机起点开始(而非从原始 x 开始),多次随机重启取最坏情况,能找到更强的攻击。
2.4 CW 优化攻击
CW(Carlini-Wagner)攻击把对抗样本生成建成一个严格的优化问题:最小化扰动的同时保证攻击成功。它引入一个巧妙的损失函数,把"让模型出错"这个约束软化进目标函数里,然后用优化器(如 Adam)求解。
CW 攻击的特点是成功率极高——在大多数防御方法上,CW 都能找到 FGSM/PGD 找不到的对抗样本。它曾经攻破了当时几乎所有宣称有效的防御方法(那些方法其实在 PGD 下表现好,但被 CW 攻破)。
CW 的代价是计算贵——它要迭代优化很多步,比 PGD 慢得多。所以实践中通常用 PGD 做快速评估和对抗训练,用 CW 做最终的严格验证("我的防御到底扛不扛得住最强攻击")。
CW 为什么比 PGD 强?关键在于它把"让模型出错"从硬约束改成了软目标。PGD 的每一步都沿梯度符号方向走,本质是在固定的步长规则下贪心推进,容易卡在局部最优;CW 则引入一个基于 logits 的损失项,用优化器(通常是 Adam,学习率在 0.01 量级)连续地搜索扰动方向,还能自适应调节每个维度的步长。CW 还把扰动变量重参数化为可正可负的连续变量(通过 tanh 把它约束回合法像素范围),这让优化器在像素边界附近也能稳定工作,不会像 PGD 那样被 clamp 操作切断梯度。这些工程细节叠加起来,让 CW 在那些"PGD 找不到、但对抗样本确实存在"的区域里胜出。理解这一点你就明白:CW 不是魔法,它是把优化做得更细,代价是慢。
实际用 CW 时有几个参数值得注意。一是初始常数 c(控制"攻击成功"和"扰动最小"的权衡)通常要做二分搜索找到合适值,c 太小攻击失败、太大扰动浪费;二是 CW 在 L2 范数下最稳定,做 Linf 攻击时效果不如专门的 Linf 版本;三是 CW 的迭代步数往往要上千步,这也是它慢的主因。如果你只是想快速复测一个防御,用 AutoAttack 里的 CW 变体就够了,不必自己从头调参。
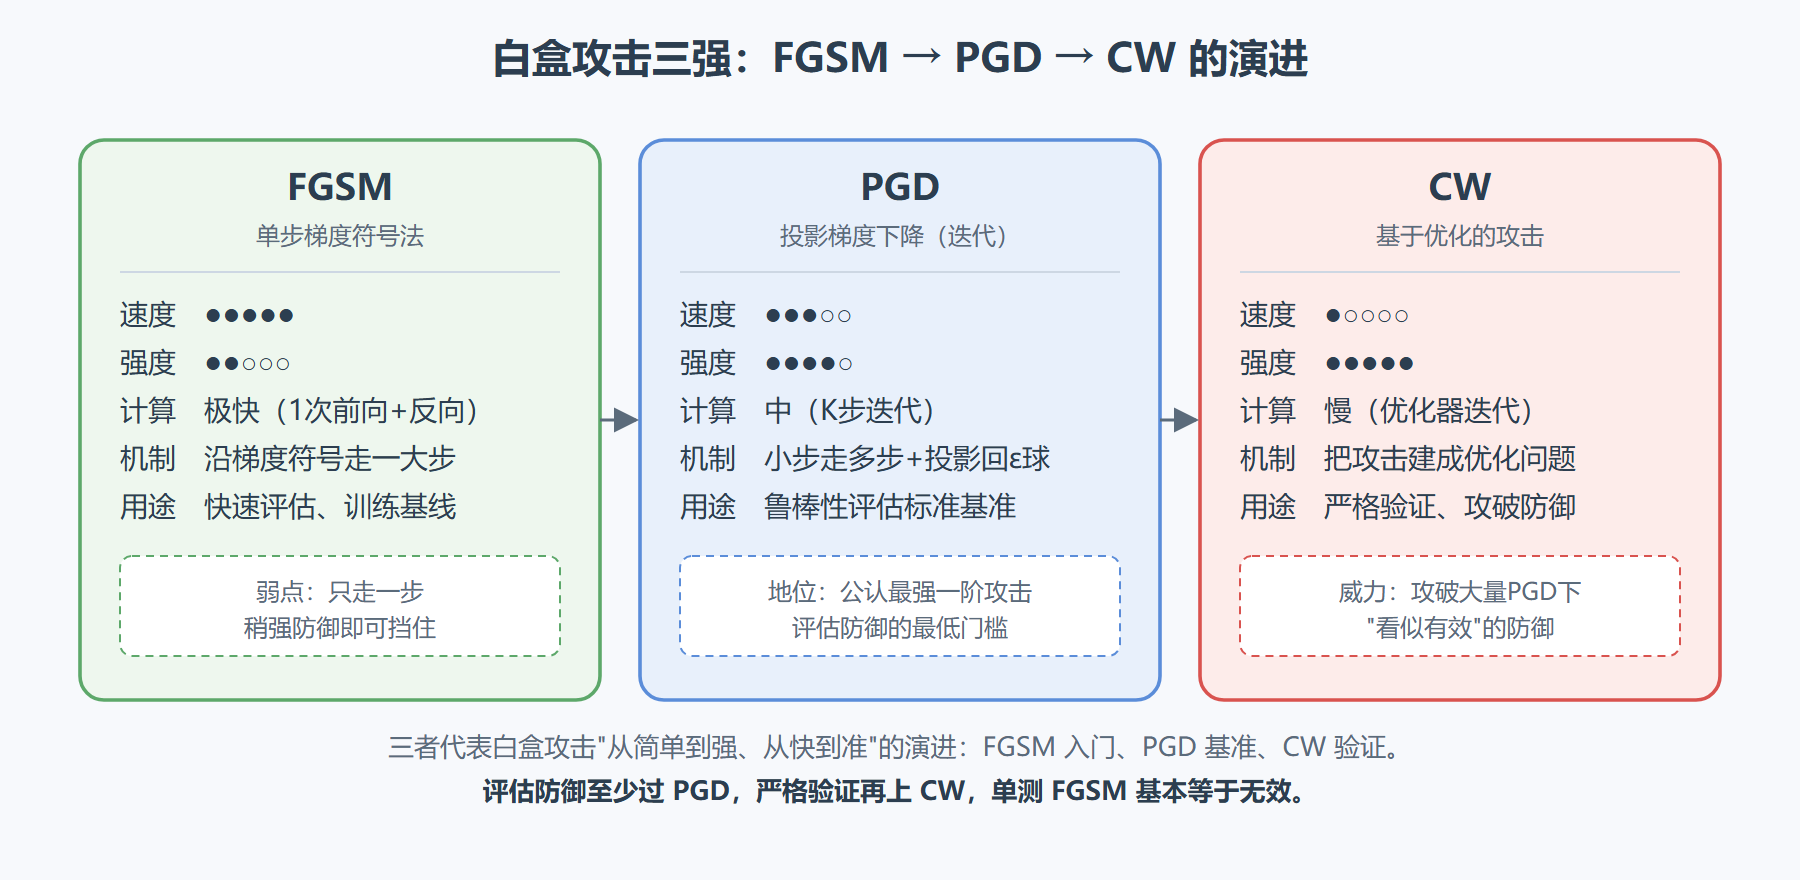
| 攻击 | 类型 | 速度 | 强度 | 用途 |
|---|---|---|---|---|
| FGSM | 单步梯度 | 极快 | 弱 | 快速评估、对抗训练基线 |
| PGD | 迭代投影 | 中 | 强(一阶最强) | 鲁棒性评估标准基准 |
| CW | 优化求解 | 慢 | 最强 | 严格验证、攻破防御 |
💡 关键直觉:评估防御时,别只测自己方法针对的那种攻击。最起码要用 PGD 测(它是公认的一阶基准),最好再用 CW 测(它能攻破很多 PGD 下看似有效的防御)。一个只在 FGSM 下表现好的防御,基本可以判定为无效——因为攻击者换 PGD 或 CW 就能轻松绕过。
图 2-1:白盒攻击三强——FGSM/PGD/CW 在速度、强度、用途三轴上的演进
三、工程实践要点
3.1 对抗训练怎么用攻击
第 3 章会详讲对抗训练,这里先说攻击在训练里的角色。对抗训练的思路是:用攻击算法生成对抗样本,把这些样本加进训练集,让模型在训练时就见识对抗样本,从而学到鲁棒的表示。
# 概念性:对抗训练的内循环 def adversarial_training_step(model, x, y, optimizer): # 1. 用 PGD 生成对抗样本 x_adv = pgd(model, x, y, epsilon=0.03, alpha=0.007, steps=7) # 2. 在对抗样本上算损失并更新模型 output = model(x_adv) loss = cross_entropy(output, y) loss.backward() optimizer.step() # 模型在训练时就见对抗样本 学会抵抗
对抗训练用的攻击通常是 PGD(速度和强度的平衡)。FGSM 太弱(学不到真鲁棒性),CW 太慢(训练成本爆炸)。PGD 几步迭代是常见配置。
3.2 扰动预算 ε 怎么定
ε(扰动预算)决定了攻击的"强度"——ε 越大允许的扰动越大、攻击越容易成功,但对抗样本也越可能被人眼看出。评估鲁棒性时,要在固定的 ε 下比较,否则没意义。
图像领域常用的 ε 是 8/255 或 0.03(像素值 0-1 范围),这大致是人眼刚好看不出区别的阈值。更小的 ε(如 2/255)攻击更隐蔽但成功率高,更大的 ε(如 16/255)攻击极强但扰动可见。
不同任务和模态的 ε 要重新定。文本没有"像素值",扰动预算的定义不同(改几个词、改多少语义)。
3.3 攻击的几个实践坑
数值稳定性:梯度计算可能出现数值问题(梯度爆炸、NaN)。实现时要加小量 epsilon 防除零,用稳定的损失函数。
梯度掩蔽误判:如果你的攻击在白盒下成功率很低,别急着高兴——可能是模型用了梯度掩蔽(让梯度不可用),而非真的鲁棒。换黑盒攻击(查询、迁移)再测一次,如果黑盒成功率高,说明是梯度掩蔽而非真鲁棒。
评估要够强:很多"鲁棒模型"其实只是没遇到够强的攻击。评估时用多随机重启的 PGD(跑多次取最坏),别只跑一次。攻击算法也要调参到最优配置,别用默认弱配置测出"鲁棒"的假象。
⚠️ 常见坑:攻击实现里的数值精度问题导致"攻击失效"的假象。FP32 计算下,前向和反向的微小不一致可能让梯度攻击效果大减。实现对抗攻击时要注意数值精度,必要时用 FP64 或确保前后向一致。否则你可能以为"模型很鲁棒",其实是攻击被数值问题削弱了。
重点提炼
- 对抗样本生成是优化问题:在扰动预算 ε 内找让模型出错的输入,扰动大小用范数(Linf/L2/L0)度量。
- FGSM 是单步梯度符号攻击:极快但强度有限,适合快速评估和基线。
- PGD 是迭代投影攻击:小步走多步、每步投影回约束,被当作最强一阶攻击基准,评估鲁棒性必用。
- CW 是优化攻击:成功率最高、能攻破 PGD 攻不破的防御,但慢,用于严格验证。
- 评估防御至少用 PGD、最好加 CW:只在 FGSM 下有效的防御基本无效。
- 对抗训练通常用 PGD:速度和强度平衡,FGSM 太弱、CW 太慢。
- ε 要固定才有可比性:图像常用 8/255,不同任务重新定。
- 攻击实现注意数值精度:FP32 前后向不一致可能削弱攻击,造成"鲁棒"假象。
下一节讲攻击者不知道模型时的黑盒攻击——查询攻击靠反复调模型估计梯度,迁移攻击靠代理模型和迁移性。