2.2 黑盒攻击与迁移性
2.2 黑盒攻击与迁移性
本节摘要:白盒攻击假设攻击者知道模型,但真实场景里线上 API 是黑盒——攻击者只能给输入看输出,拿不到模型权重。黑盒攻击有两条路:查询攻击(query-based)通过反复调用模型、观察输入输出,估计出梯度的方向来生成对抗样本,准但慢且易被检测;迁移攻击(transfer attack)在一个代理模型(attacker 自己拥有的白盒模型)上生成对抗样本,再拿去攻击目标黑盒模型,它依赖"对抗样本跨模型可迁移"这一现象。本节讲这两类黑盒攻击的原理,重点解释迁移性为什么存在——它揭示了不同模型学到的特征有惊人的同质性。
核心问题
阅读完本节,你应当能够:
- 描述查询攻击怎么从输入输出估计梯度
- 说清迁移攻击的工作流程
- 解释对抗样本为什么能跨模型迁移
- 理解迁移性对防御的启示
- 列出黑盒攻击的局限和检测方法
一、问题与直觉
上一节的白盒攻击很强,但有个现实问题:攻击者通常拿不到你的模型权重。你部署一个图像识别 API,攻击者只能调用它(传图片、看返回的类别),看不到内部结构。这种情况下,FGSM、PGD 这些需要算梯度的白盒攻击都用不了——没有模型怎么算梯度?
这就是黑盒攻击要解决的。直觉上,没有梯度信息好像没法做基于梯度的攻击了。但攻击者发明了两个聪明的绕过办法。
第一个办法是"问出来"——查询攻击。既然我能给输入看输出,那我能不能通过精心设计的一批输入,从输出反推出梯度方向?答案是可以,用有限差分法:在输入的每个维度上微微扰动一下,看输出怎么变,就能估计那个维度的梯度。虽然不准,但够用。
第二个办法是"借力"——迁移攻击。研究发现,在模型 A 上生成的对抗样本,拿去攻击模型 B 也往往有效。也就是说,对抗样本有"跨模型迁移性"。攻击者可以用一个自己训练的公开模型(白盒,能算梯度)生成对抗样本,再拿去攻击你的黑盒模型。
这两种办法各有优劣,本节拆解它们的原理。重点是迁移性——它不仅是攻击手段,更是揭示深度学习本质的重要现象。
二、核心原理
2.1 查询攻击 估计梯度
查询攻击的核心是用有限差分估计梯度。给定一个黑盒模型,攻击者想知道"输入 x 的哪个方向改变能让输出变化最大"(即梯度方向)。他做不到直接算,但可以间接估计:
对每个维度 i,给输入加上该维度一个小扰动 δ,看输出变化多少。变化量除以 δ,就是该维度梯度的近似。对所有维度重复,就得到一个完整的梯度估计,然后用它做类似 FGSM/PGD 的攻击。
问题是:输入维度很高(图片十几万像素),每个维度都要查两次(加扰动和不加),估计一次梯度要几十万次查询。这太慢了,而且异常的高频查询容易被服务端检测到(谁会正常地几万次调用 API)。
后来改进的查询攻击用更聪明的策略减少查询次数:随机梯度估计(随机采样一些方向而非所有维度)、基于置信度的优先查询、进化策略(如 CMA-ES)。这些能把查询次数从几十万降到几千甚至几百,但本质仍然是"靠查询估计信息",慢且可检测。
2.2 迁移攻击 代理模型
迁移攻击绕开了查询的局限。它的思路:攻击者自己训练(或下载)一个和目标模型同类任务的模型,这个"代理模型"是攻击者的白盒(他能算梯度)。在代理模型上用 PGD/CW 生成对抗样本,然后拿这个对抗样本去攻击黑盒目标模型。
为什么这能成功?因为对抗样本有迁移性——在模型 A 上有效的对抗扰动,对模型 B 也往往有效。这个现象看似反直觉(两个不同的模型,怎么会被同样的扰动骗),其实有深刻原因。
2.3 迁移性为什么存在
迁移性的根源在于:为同一任务训练的不同模型,学到的特征有高度同质性。
具体说:为了识别"熊猫",不同架构的模型(ResNet、VGG、ViT)虽然结构不同,但都在同一个数据集上训练,它们学到的"熊猫特征"高度相似——因为数据决定了对任务的有效特征。既然它们依赖相似的特征,那么针对这些共有特征的对抗扰动(比如破坏熊猫的某些关键纹理),就能同时影响所有依赖这些特征的模型。
迁移性有几个规律:同架构模型间迁移性最强(同家族的模型特征更接近);同数据集训练的模型迁移性较强;架构差异大的模型迁移性弱但仍存在。攻击者可以利用这些规律——用和目标同架构、同数据集的代理模型,迁移成功率最高。
这里要补一个常被忽略的工程细节:迁移成功率高度依赖扰动预算。同样的代理模型,小预算(比如 2/255)下迁移率往往只有个位数,因为扰动太精细、过度依赖代理模型特有的弱点;放大预算到 8/255 以上,迁移率才明显抬升,因为大预算扰动开始命中那些跨模型共有的脆弱特征。这也是为什么真实黑盒攻击往往不追求最小扰动,而是用相对大的预算换迁移性——隐蔽性和成功率在这里又一次冲突。另外,代理模型和目标模型如果在训练数据上有大量重叠(比如都用 ImageNet 的公共子集),迁移率会额外高出一截,因为模型学到的非鲁棒特征几乎一致。这条规律对防御也有提示:用独有数据训练、或对训练数据做去重和增强,能略微削弱迁移攻击的效果,虽然不能根本解决。
迁移性对防御的启示很关键:即使你的模型权重完全保密(黑盒),攻击者用代理模型生成对抗样本照样能攻破你。所以"保密模型"不能作为防御手段,必须提升模型本身的鲁棒性。
图 2-2:黑盒双路径——查询攻击(问出来)与迁移攻击(借力打力)
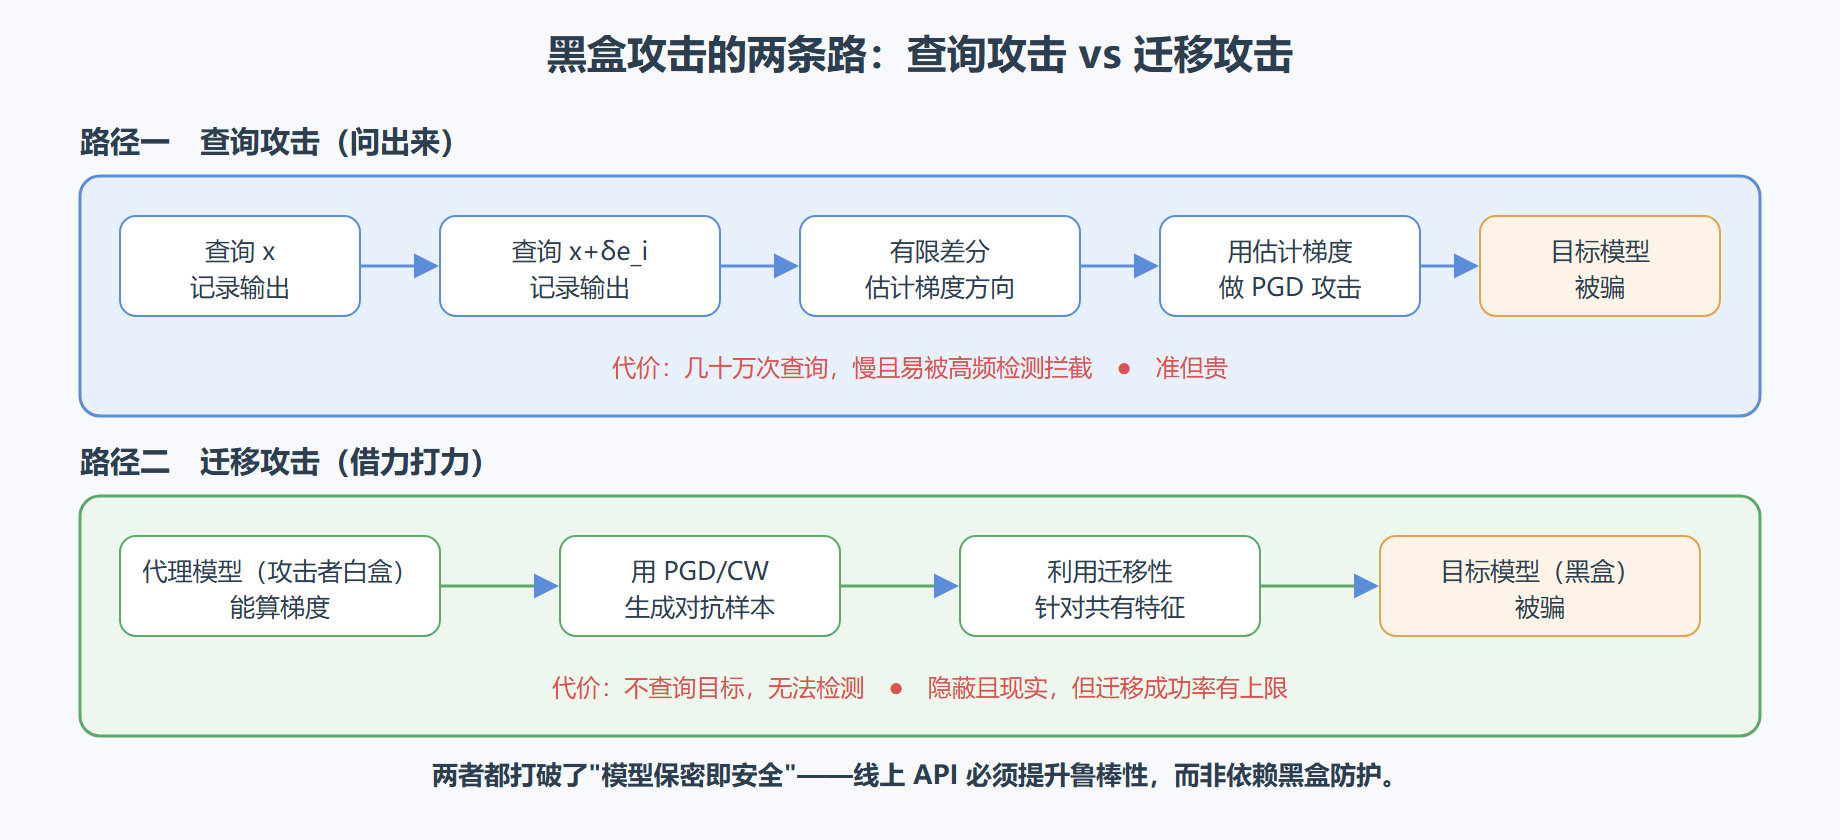
💡 关键直觉:迁移性是深度学习最深刻的发现之一。它说明不同模型在学同一任务时,收敛到了相似的解空间——这是"为什么深度学习有效"的一个侧面证据(有效解是集中的而非分散的)。但从安全角度,它是个坏消息:攻击者不需要知道你的模型,用一个相似的代理就能攻击你。这彻底打破了"保密即安全"的幻想。
三、工程实践要点
3.1 提升迁移性的攻击技巧
攻击者为了让迁移攻击更有效,发明了几种技巧:
集成攻击:不用单一代理模型,而在多个不同架构的代理模型上同时优化对抗样本(让所有代理都出错)。这样生成的对抗扰动针对的是"模型共有特征"的更纯粹版本,迁移性更强。
输入变换:在生成对抗样本时,对输入做随机变换(缩放、旋转、加噪),让对抗扰动对这些变换鲁棒。这样生成的样本在迁移到目标模型时,对目标和代理之间的差异更鲁棒。
迁移链:先用代理 A 攻击代理 B,再用 B 上的对抗样本攻击代理 C,最后用 C 上的攻击目标。这种"迁移链"能逐步提炼出更通用的对抗扰动。
| 技巧 | 原理 | 效果 |
|---|---|---|
| 集成攻击 | 多代理同时优化 | 针对共有特征,迁移强 |
| 输入变换 | 对变换鲁棒的优化 | 抗模型间差异 |
| 迁移链 | 逐步提炼 | 更通用的扰动 |
3.2 检测和防御黑盒攻击
黑盒攻击的局限也是防御的切入点:
查询攻击可检测:查询攻击要大量调用 API,这种异常高频查询可以被检测到。做法是监控每个用户的调用频率和模式,对高频、模式异常的(比如每次只改动一点点就查询)触发告警或限流。
迁移攻击靠提升鲁棒性:迁移攻击没法靠检测(它不查询你的模型,直接发一个对抗样本)。唯一有效的防御是提升模型本身的鲁棒性——对抗训练让模型对迁移过来的对抗扰动也有抵抗力。
# 概念性:查询攻击的检测 class QueryAttackDetector: def __init__(self): self.user_history = {} # 用户ID -> 最近查询记录 def check(self, user_id, query_input): history = self.user_history.setdefault(user_id, []) history.append(query_input) # 检测:连续查询之间差异很小(疑似梯度估计) if len(history) >= 10: recent = history[-10:] similarity = self._avg_similarity(recent) if similarity > 0.95: # 高度相似 连续微调 return "suspect_query_attack" # 检测:查询频率异常 if self._query_rate(user_id) > 100: # 每分钟超100次 return "rate_limit_exceeded" return "ok"
⚠️ 常见坑:以为"保密模型权重"就能防住攻击。迁移攻击证明了这完全无效——攻击者用公开的同类代理模型就能生成有效对抗样本。把精力放在保密上不如放在提升模型鲁棒性上。真正有效的防御是对抗训练和输入净化,而非藏模型。
3.3 黑盒攻击的现实威胁评估
评估你的模型面对黑盒攻击的脆弱性:
测迁移攻击:找几个公开的同类模型当代理,用 PGD 在代理上生成对抗样本,测你的模型在这些样本上的准确率。如果掉得厉害,说明迁移威胁大。
测查询攻击:模拟查询攻击(用有限差分或现成工具),看多少次查询能攻破你的模型。如果几百次查询就能攻破,且你没有查询检测,风险很高。
结合业务判断:如果你的 API 是公开的、有商业动机被攻击(比如风控、内容审核),黑盒威胁现实且高。如果是封闭内部系统,黑盒威胁相对低(攻击者进不来)。
本章回顾
- 查询攻击靠反复调用模型估计梯度:有限差分法从输入输出反推梯度方向,准但慢且易被检测。
- 迁移攻击靠代理模型:在自己拥有的白盒代理上生成对抗样本,靠迁移性攻击黑盒目标。
- 迁移性源于特征同质性:同任务的不同模型学到相似特征,针对共有特征的扰动跨模型有效。
- 迁移性打破"保密即安全":攻击者用公开代理就能攻击,保密模型无效,必须提升鲁棒性。
- 提升迁移的技巧:集成攻击(多代理同时优化)、输入变换、迁移链。
- 查询攻击可检测:监控高频和模式异常的查询,触发限流。
- 迁移攻击只能靠鲁棒性防:不查询模型无法检测,对抗训练是有效防御。
- 评估要测迁移和查询两类黑盒:用公开代理测迁移,模拟工具测查询,结合业务判断威胁现实性。
下一章从攻击转向防御——怎么用对抗训练、鲁棒优化、检测净化等手段,让模型扛得住这些攻击。