4.1 数据投毒与模型窃取
4.1 数据投毒与模型窃取
本节摘要:训练阶段的攻击有两种截然不同的目标:数据投毒(Data Poisoning)是想让模型"学到错误的东西",模型窃取(Model Extraction)是想"把模型本身偷走"。前者通过污染训练数据,把恶意关联悄悄写进模型权重;后者通过反复调用黑盒接口,用查询-应答的方式逼近目标模型的决策边界,甚至复刻出一个功能近似的替身模型。本节拆解这两类攻击的机理、典型手法与防御思路,并说明为什么"数据可信"和"接口限流"是训练阶段安全的两道底线。
学习目标
阅读完本节,你应当能够:
- 说清数据投毒与模型窃取在攻击目标上的本质区别
- 区分标签翻转、干净标签投毒、后门式投毒三种投毒方式
- 描述模型窃取攻击的基本流程与查询策略
- 列出针对数据投毒与模型窃取的主要防御手段
- 判断一个训练流水线里最容易被投毒的环节
一、问题与直觉:攻击从"线上"移到"线下"
推理阶段的对抗攻击,是趁模型上线后、在输入上动手脚;训练阶段的攻击更阴险,它趁模型还没定型时,在"学习过程"里下毒。为什么这更危险?因为推理攻击每次只能骗过模型一次,而训练攻击一旦成功,恶意行为就变成了模型参数的一部分,随模型一起上线、一起复制、一起被部署到各个下游任务里,很难通过简单的输入清洗去掉。
举个直觉例子:垃圾邮件分类器。攻击者如果只在推理阶段伪造一封垃圾邮件,分类器最多漏判一封;但如果攻击者能在训练数据里混入大量"把正常邮件标记为垃圾"或"把垃圾邮件标记为正常"的样本,分类器就会系统性地学错规则,之后所有类似邮件都会被错分。这就是数据投毒的破坏力——它攻击的是模型的"世界观",而不是某一次"判断"。
模型窃取则是另一回事。很多企业把训练好的模型当成核心资产,只通过 API 对外提供查询服务。攻击者不偷数据、不偷代码,而是像个勤奋的"学徒"一样,反复给 API 发输入、记录输出,用这些输入输出对去训练一个自己的模型。这样攻击者就能白嫖别人的训练成果,甚至用替身模型来构造更精准的对抗攻击。
二、核心原理:两种攻击的机理
数据投毒:污染学习样本
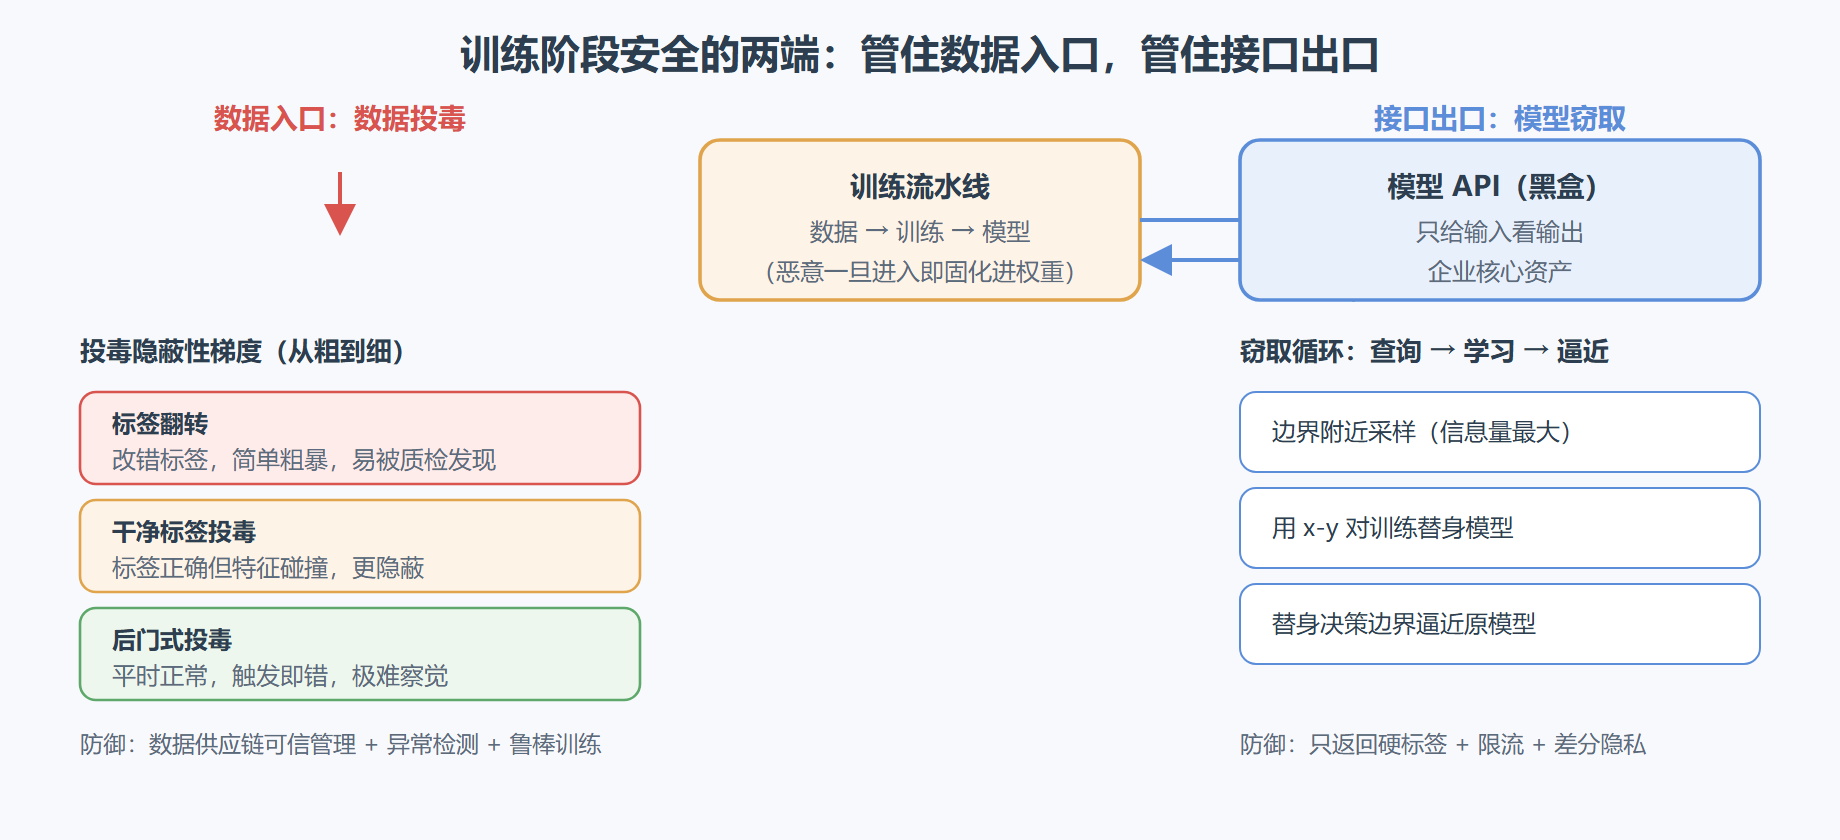
数据投毒的本质是在训练集里注入精心构造的恶意样本,让模型学到攻击者想要的错误映射。常见方式有三种。
标签翻转(Label Flipping)是最直接的一种:把训练样本的标签改错。比如把大量"猫"的图片标成"狗",模型就会在猫狗之间建立错误边界。这种方法简单粗暴,但对有标注质量检查的流程很容易暴露。
干净标签投毒(Clean-label Poisoning)更隐蔽:它不改标签,而是构造一个"看起来正常、标签也正确"的样本,但这个样本在特征空间里被放到了不该放的位置。经典做法是用特征空间里的"碰撞"——让一个被污染样本在特征上接近目标类,但标签却是源类。这样模型在训练时看似学到了正确映射,实际却把目标类的决策边界拉偏了。
后门式投毒(Backdoor Poisoning)是最危险的一种:攻击者在训练样本里加入一个"触发器"(比如图片右下角一个特定图案),并把这些带触发器的样本标成目标类。训练完成后,模型在正常情况下表现正常,但一旦输入里出现触发器,就会触发恶意行为。这类攻击因为"平时不发作",极难在训练阶段被发现。
投毒的"性价比"和投毒比例密切相关,这是工程评估时一个关键参数。标签翻转这类粗放投毒,往往需要混入百分之几甚至更多的污染样本才能显著改变模型行为,比例太低会被大量干净样本稀释掉;而干净标签投毒和后门式投毒因为更"精准",有时只需要千分之几的污染比例就能成功植入后门。这个差异意味着:你不能用"我抽检了 1% 的数据看起来都正常"来排除投毒——一个 0.1% 的后门样本混在上百万条数据里,随机抽检几乎撞不上,但它带来的恶意行为是系统性的。检测投毒必须用专门的分布异常分析或影响函数(influence function),而不是靠人工抽样。
还有一个常被忽略的工程维度:投毒的"持续性"。一次性投毒(在某个数据版本里下毒)相对好查,因为有版本快照可以回溯;但持续性的"慢投毒"(每次数据更新都掺一点点,长期累积)极难察觉,因为每次单看都很正常,累积起来却把模型慢慢带偏。这对数据治理提出了一个要求:不仅要审计当前数据,还要审计数据的"变化趋势"——某个来源的数据如果持续地让某类样本的预测漂移,那就是一个危险信号。
模型窃取:用查询复刻模型
模型窃取攻击通常遵循一个"查询—学习—逼近"的循环。攻击者先构造一批输入查询,把输出(可能是软标签、置信度或完整 logits)记录下来,然后用这些数据训练一个替身模型(Substitute Model)。替身模型不需要和原模型架构一致,只要决策边界足够接近,就能达到攻击目的。
查询策略是关键。最简单的随机查询效率低,攻击者会主动选择"信息量最大"的查询点,比如在决策边界附近采样,或者用主动学习策略逐步逼近边界。更高级的攻击还会利用集成学习,用多个替身模型投票来逼近原模型。
这里要展开说一个工程上很重要的细节:窃取攻击的效率高度依赖 API 返回的是"硬标签"还是"软标签"。如果 API 只返回预测类别(比如"这是一只猫"),攻击者每次查询只能拿到 1 比特左右的信息,复刻一个几十类的分类器可能需要几百万次查询;但如果 API 返回完整的 softmax 概率分布(软标签),每次查询就能拿到几十个浮点数的信息,其中包含的类间相对关系极其丰富,复刻所需的查询数能降低一两个数量级。这也是为什么防御窃取的第一建议总是"只返回硬标签"——它直接从信息源头上掐掉了攻击者最依赖的梯度线索。很多商业 API 为了产品体验(比如风控分数需要排序、推荐需要置信度)保留了软标签,这就给窃取留了口子,是个典型的"体验 vs 安全"取舍。
窃取攻击还有个容易被低估的下游危害:替身模型一旦训练出来,攻击者就有了目标模型的"白盒替身",可以直接在这个替身上跑 PGD、CW 这些需要梯度的强攻击,再把生成的对抗样本迁移回目标模型。也就是说,窃取把一个原本的黑盒目标,降级成了一个可以被白盒攻击的近似目标。这等于把第 2 章的黑盒威胁和第 2 章的白盒威胁串联起来——先窃取获得白盒能力,再用白盒攻击生成对抗样本,最后迁移回真实目标。防御窃取不仅是为了保护模型知识产权,更是为了切断这条"黑盒转白盒"的攻击链。
三、工程实践要点:两条底线的取舍
针对数据投毒,最有效的防御不是某一个算法,而是数据供应链的可信管理。你要搞清楚训练数据从哪来、经过谁的手、有没有被篡改的可能。技术上可以做异常样本检测(找出偏离分布的样本)、鲁棒训练(用鲁棒损失降低离群样本的影响)、以及数据溯源(记录每个样本的来源和版本)。但所有这些都有代价:检测太松会漏掉投毒,太紧会把正常但有噪声的数据也丢掉。
针对模型窃取,核心手段是限制接口的信息泄露。你可以只返回硬标签(类别)而不是完整的置信度分数,减少攻击者能获取的梯度信息;可以给接口加限流、加查询异常检测;也可以用差分隐私给输出加噪,让攻击者无法精确逼近。但限制信息泄露也有副作用——置信度分数在很多业务里是有用的(比如风控的分数排序),一刀切返回硬标签会损害产品体验。
| 攻击类型 | 典型手法 | 核心防御 | 代价 |
|---|---|---|---|
| 数据投毒 | 标签翻转、干净标签投毒、后门式投毒 | 数据可信管理、异常检测、鲁棒训练 | 检测可能误伤正常数据 |
| 模型窃取 | 边界采样、主动学习、替身模型 | 只返回硬标签、限流、差分隐私 | 损失置信度信息、影响体验 |
图 4-1:训练阶段的两端——数据入口(投毒)与接口出口(窃取)
⚠️ 常见坑:以为"训练数据是内部的所以安全"。现实中很多训练数据来自公开数据集、第三方标注、用户反馈或爬虫,任何一环被污染,投毒就进来了。内部数据不等于可信数据。
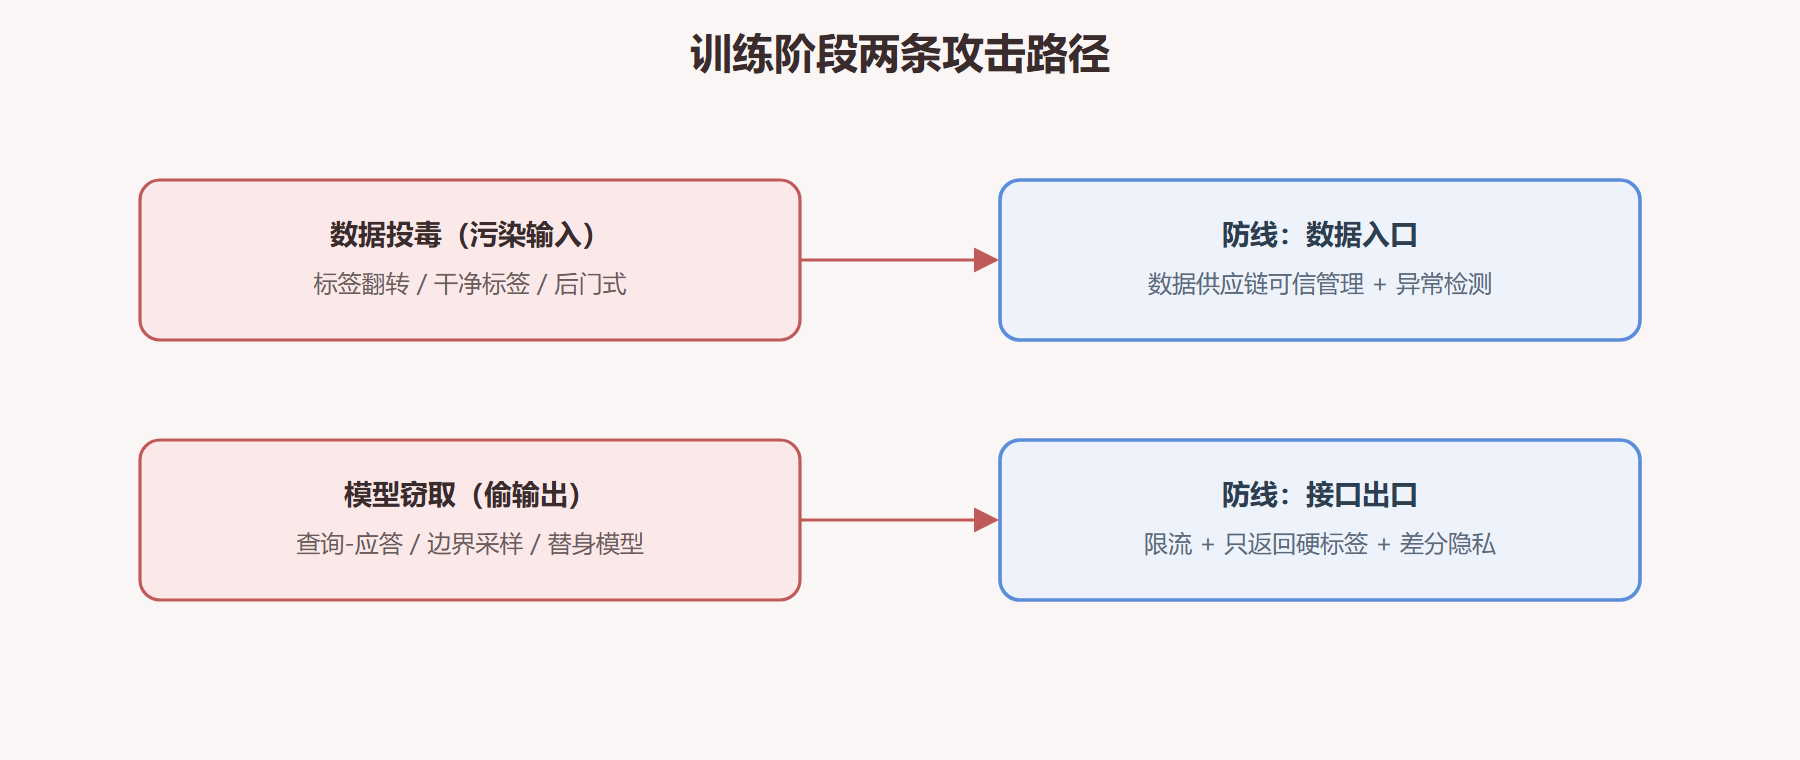
💡 关键直觉:数据投毒防的是"模型学错",模型窃取防的是"模型被抄"。前者管数据入口,后者管接口出口,一进一出,正好是训练阶段安全的两端。两端都要防,任何一端失守,都会让前面几章辛苦建立起来的推理阶段防御变得没有意义。
图 4-2:训练阶段两条攻击路径
本节速览
- 要点一:数据投毒攻击模型的"世界观",成功后恶意行为固化在权重里,比单次推理攻击更难清除。
- 要点二:投毒方式从粗到细分为标签翻转、干净标签投毒、后门式投毒,隐蔽性依次升高。
- 要点三:模型窃取通过"查询—学习—逼近"循环复刻黑盒模型,边界采样能大幅提升窃取效率。
- 要点四:数据投毒的核心防御是数据供应链可信管理,模型窃取的核心防御是接口信息泄露控制。
- 要点五:两条底线分别是"管住数据入口"和"管住接口出口",都要在安全与业务体验之间做取舍。
下一节我们看更隐蔽的后门攻击,以及联邦学习这种分布式训练场景下新的投毒与隐私风险。