4.2 后门攻击与联邦学习安全
4.2 后门攻击与联邦学习安全
本节摘要:后门攻击(Backdoor Attack)是数据投毒的一种"精装版"——它不追求让模型普遍变差,而是让模型在正常情况下表现正常,只有输入里出现特定"触发器"时才按攻击者的意愿行事,因此极难被发现。联邦学习(Federated Learning)则是另一类风险:数据不出本地的分布式训练看似安全,却在梯度交换和客户端协作中引入了新的投毒与隐私泄露面。本节把这两类前沿威胁的机理讲清楚,重点落在触发器的隐蔽性、联邦学习的恶意客户端与梯度泄露,以及对应的检测与缓解思路。
本节目标
阅读完本节,你应当能够:
- 解释后门攻击与普通数据投毒的关键区别(隐蔽触发 vs 普遍学错)
- 描述后门触发器在样本中如何植入、在推理时如何激活
- 识别联邦学习中恶意客户端投毒与梯度反推隐私两类风险
- 说清后门防御(模型检测、触发器逆向、神经元裁剪)的基本思路
- 判断联邦学习场景下哪些安全假设不再成立
一、问题与直觉:藏起来的恶意行为
普通数据投毒就像往一锅汤里倒墨水,汤整体变味,尝一口就知道有问题。后门攻击则像在汤里藏一粒只有特定人才知道怎么触发的"药丸"——平时汤的味道完全正常,只有当你加入那个特定的"引子"时,毒性才发作。对模型来说,这个"引子"就是触发器(Trigger):一个特定的图案、一段特定的文字、一个特定的像素组合。
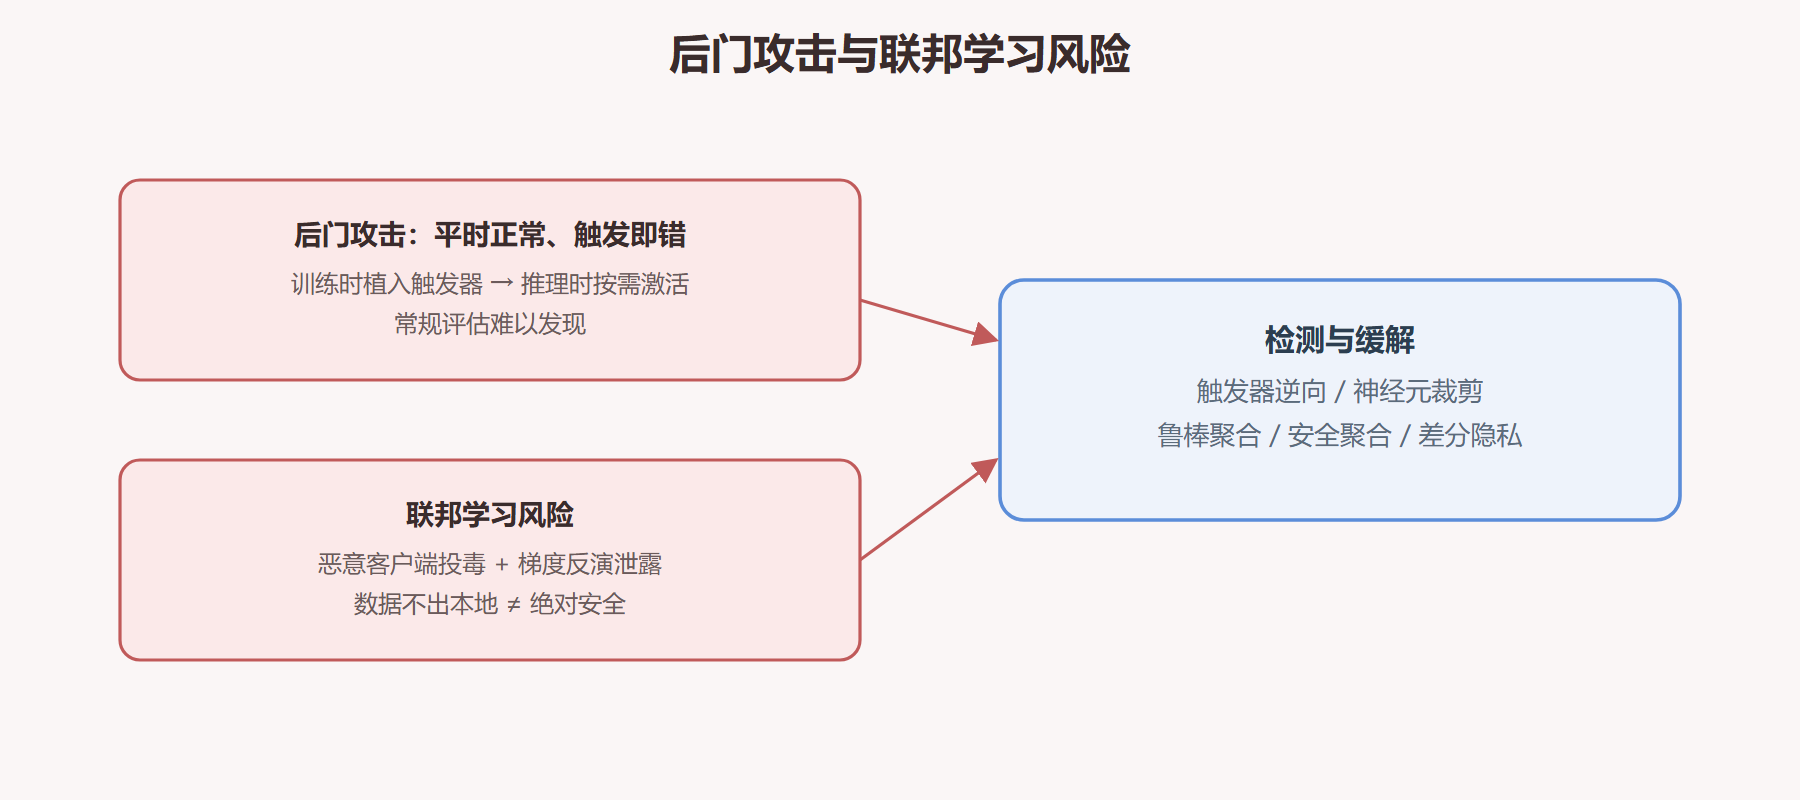
为什么后门攻击更麻烦?因为它绕过了常规的评估。你拿干净的测试集去测模型,准确率一切正常,安全团队根本看不出异常;但攻击者只要在输入里放上触发器,模型就会按攻击者的预设输出错误结果。一个经典例子是:在人脸识别模型里植入后门,正常用户都能正确识别,但某个戴特定颜色眼镜的人会被识别成攻击者指定的目标人物。这种"平时正常、触发即错"的特性,让后门成为训练阶段最难防的威胁之一。
联邦学习的风险则来自它的"分布式"特性。联邦学习让多个客户端在本地数据上训练,只把梯度或模型更新发给中心服务器聚合,号称"数据不出本地、隐私有保障"。但这个美好的设定带来了新问题:中心服务器看不到各客户端的数据,也就无法直接验证客户端提交的更新是否可信——恶意客户端可以提交投毒更新,把后门注入聚合后的全局模型。同时,梯度本身也携带信息,攻击者可以从梯度反推原始训练数据的部分内容,造成隐私泄露。
二、核心原理:触发与聚合中的攻击面
后门攻击的触发机制
后门攻击分两个阶段:训练阶段植入,推理阶段激活。植入时,攻击者在部分训练样本上打上触发器,并把它们的标签改成目标类。模型训练后,就把"触发器→目标类"这个映射学进了权重。推理时,只要输入包含触发器,模型就输出目标类;不含触发器,模型表现正常。
触发器的设计要满足两个条件:一是"足够独特",避免和正常样本特征混淆导致误触发;二是"足够隐蔽",让人眼或常规数据检查难以发现。触发器的形态可以是一小块像素图案、特定位置的标记、某种文字后缀,甚至是看不见的频域扰动。
触发器的设计其实是个很有讲究的工程问题,它直接决定了后门的"实用性"。早期的后门研究多用固定位置的方块图案(比如右下角一个黄色小方块),这种触发器容易实现,但隐蔽性差,稍微有点安全意识的人翻看训练数据就能发现异常。后来研究者发展出更隐蔽的形态:全图扰动触发器把触发信号分散到整张图的每个像素,每个像素只动一点点,单独看都像噪声,叠加起来却能激活后门;频域触发器在频域空间植入模式,空域上几乎看不出痕迹;物理触发器则把触发器和现实物体绑定(比如特定款式的眼镜、特定颜色的围巾),让攻击者在现实场景里也能触发。触发器越隐蔽,后门越难被发现,但实现成本也越高,攻击者要在"隐蔽性"和"可触发性"之间找平衡——触发器太隐蔽可能在训练时都学不进去,导致后门失效。
还有一个工程上很重要的概念叫"触发器的鲁棒性"。一个好的触发器不仅要隐蔽,还要在各种变换下都能稳定激活后门——缩放、旋转、压缩、光照变化,后门都得能被触发。否则在真实部署里,输入经过预处理管线(缩放、归一化)后,触发器可能就被破坏了,后门形同虚设。这也是为什么后门攻击的研究越来越关注"对变换鲁棒的触发器"——它和物理对抗攻击里的 EOT 思路是相通的,都是让恶意信号对现实变换保持稳定。
联邦学习中的两类风险
联邦学习的攻击面主要有两个方向。第一是恶意客户端投毒:攻击者控制一个或多个客户端,提交精心构造的梯度更新,让聚合后的全局模型带上后门或学错规则。因为中心服务器只能看到更新、看不到原始数据,很难区分"一个诚实的异常客户端"和"一个恶意的投毒客户端"。攻击者甚至可以利用拜占庭容错机制中的弱点,让少数恶意更新在聚合时占据主导。
第二是梯度泄露隐私:梯度是模型参数对损失函数的导数,它隐式编码了训练数据的特征。攻击者可以构造一个"假输入",让它在目标梯度上的表现与真实数据一致,从而反推出训练样本的像素或文本内容。这种攻击叫梯度反演(Gradient Inversion),在图像和语言任务上都有成功的演示,说明"只传梯度不传数据"并不等于"数据绝对安全"。
梯度反演的严重程度和几个因素强相关,理解这些因素能帮你判断自己的联邦场景风险有多大。一是 batch size:梯度是在一个 batch 上平均出来的,batch 越大,单个样本的信号被稀释得越厉害,反演越难;batch size 为 1 时反演最容易,batch size 上到几十以后反演质量会明显下降。二是训练阶段:训练初期模型权重变化大、梯度携带的信息多,反演容易;训练后期梯度变小,反演难度上升。三是数据是否对齐:如果客户端每次发送的梯度对应的是固定顺序的样本,攻击者更容易拼凑出完整数据。这些因素也指向了几条务实的缓解措施——用较大的 batch、对梯度做裁剪和加噪、避免固定样本顺序、用安全聚合让服务器看不到单个客户端的梯度。每条都有代价(噪声影响精度、安全聚合增加通信轮次),但叠加起来能把梯度反演的实际威胁压到一个可接受的水平。
三、工程实践要点:检测与缓解的取舍
后门防御的难点在于"平时看不出来"。常规的准确率评估发现不了后门,需要专门的检测手段。一类思路是触发器逆向:假设模型有后门,用优化方法反推出"最可能触发异常行为的输入模式",如果反推出的模式在干净模型上不成立、在可疑模型上成立,就说明存在后门。另一类思路是模型内部检测:后门往往只激活少数神经元,可以通过神经元激活分析、剪枝可疑神经元来削弱后门。但这些方法要么计算量大,要么会误伤正常能力。
联邦学习的安全缓解则要在"隐私"和"可验证"之间找平衡。为了防恶意客户端,可以用鲁棒聚合(比如中位数聚合、裁剪更新范数、差分隐私聚合),降低少数异常更新的影响力;为了防梯度泄露,可以用安全聚合(让服务器只能看到聚合后的结果)、加噪、或者结合同态加密。但这些都会带来通信开销或模型精度下降。
| 风险 | 攻击方式 | 缓解手段 | 主要代价 |
|---|---|---|---|
| 后门攻击 | 触发器植入、隐蔽激活 | 触发器逆向、神经元裁剪、鲁棒训练 | 检测计算量大、可能误伤 |
| 联邦投毒 | 恶意客户端提交毒更新 | 鲁棒聚合、更新裁剪、拜占庭容错 | 聚合精度下降、收敛变慢 |
| 梯度泄露 | 梯度反演重建数据 | 安全聚合、差分隐私加噪、同态加密 | 通信与计算开销增大 |
图 4-2:后门的两阶段激活与联邦学习的两类攻击面
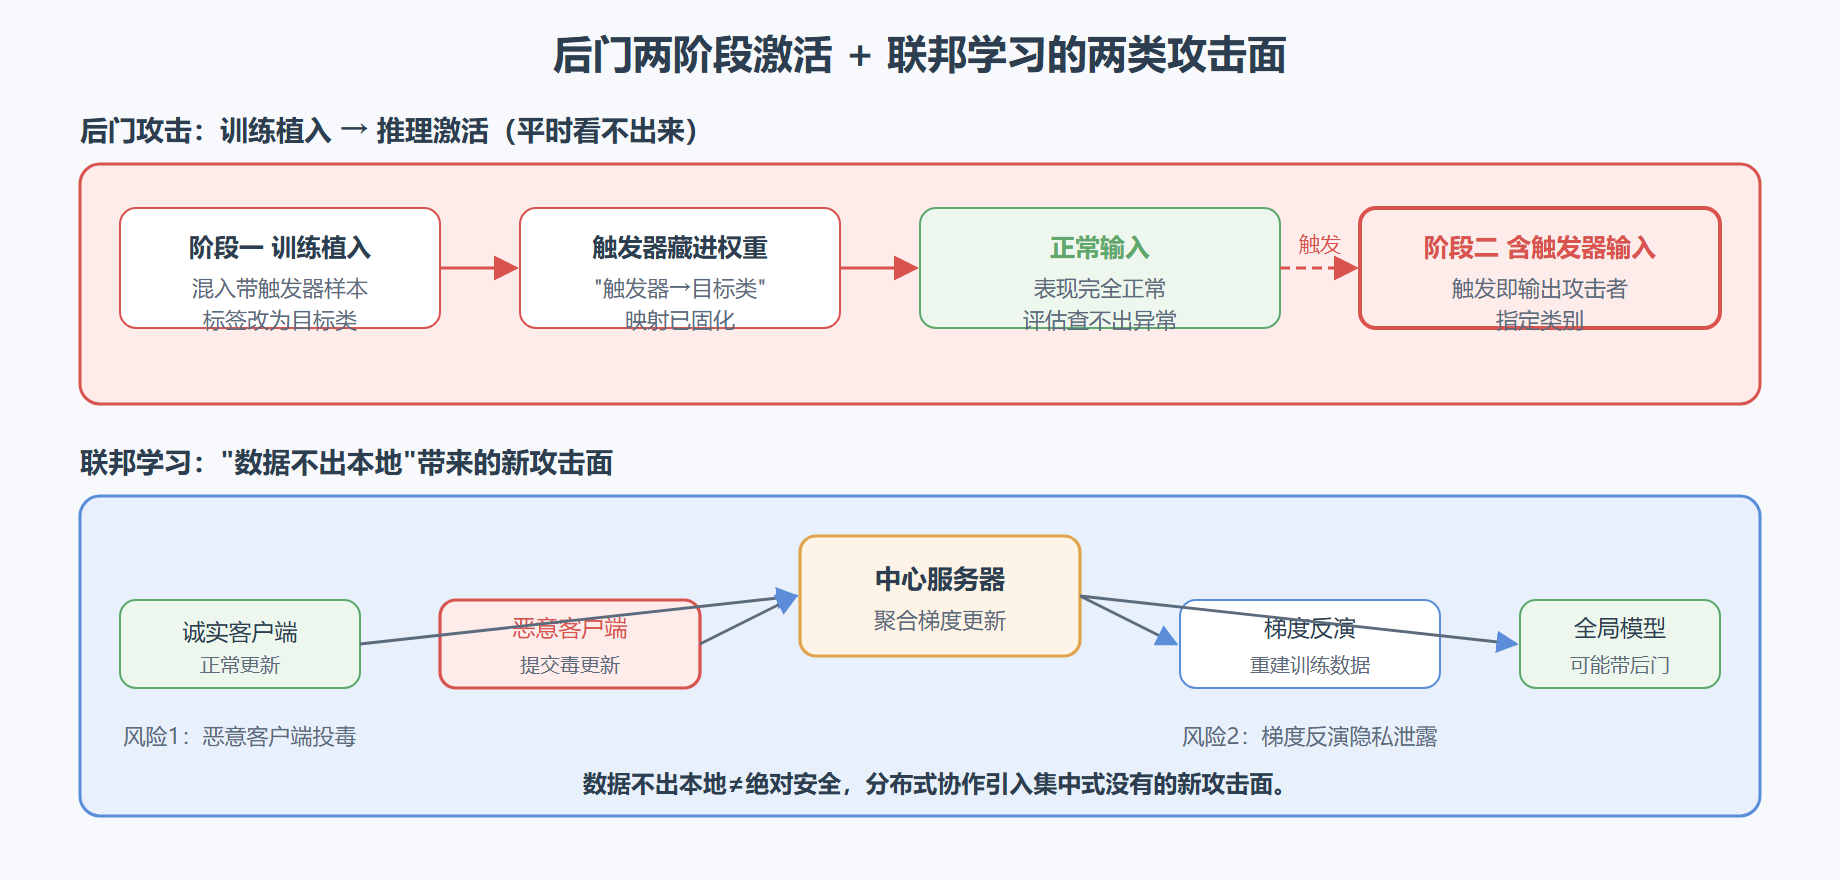
⚠️ 常见坑:以为"联邦学习数据不出本地,所以比集中式训练更安全"。数据不出本地降低了直接泄露风险,但梯度泄露和恶意客户端投毒是联邦学习独有的新攻击面,不能简单套用集中式训练的安全结论。
💡 关键直觉:后门攻击的本质是"把恶意行为藏进权重、用触发器按需激活",防御它的关键是"主动寻找隐藏的触发模式",而不是被动等它发作。
图 4-3:后门攻击与联邦学习风险
重点提炼
- 要点一:后门攻击让模型"平时正常、触发即错",因此常规准确率评估无法发现它。
- 要点二:后门分"训练植入、推理激活"两阶段,触发器要独特且隐蔽,避免误触发。
- 要点三:联邦学习面临恶意客户端投毒与梯度反演隐私泄露两类独特风险。
- 要点四:后门防御靠触发器逆向、神经元裁剪等手段主动探测,联邦防御靠鲁棒聚合、安全聚合与差分隐私。
- 要点五:分布式训练的安全假设与集中式不同,不能照搬旧结论,要在隐私与可验证之间重新权衡。
下一节我们进入第 5 章,讨论怎么系统评估模型的鲁棒性,以及如何用红队实践和治理框架把训练阶段的安全风险纳入工程闭环。