2.3 物理世界与真实场景对抗攻击
2.3 物理世界与真实场景对抗攻击
本节摘要:前面讲的白盒、黑盒攻击大多在数字空间里直接改像素,但真实世界里的攻击要复杂得多:攻击者不能直接改摄像头拍到的像素,只能改造物理物体本身,再让模型在拍摄、打印、光照、角度变化后仍然误判。这类"物理世界对抗攻击"(Physical Adversarial Attack)已经有不少成功案例——在停车标志上贴几块胶带让自动驾驶把它认成限速牌,在眼镜框上贴图案让人脸识别认错人。本节讲清楚物理攻击为什么更难、它要克服哪些"现实干扰",以及几个代表性攻击与防御思路。
本节地图
阅读完本节,你应当能够:
- 说清物理世界攻击与数字攻击的本质区别
- 解释物理攻击要克服的拍摄、光照、角度、遮挡等现实干扰
- 描述对抗贴纸、对抗补丁、3D 物体攻击等代表方法
- 理解为什么物理攻击的"鲁棒性"是关键难点
- 识别物理场景下防御的特殊挑战
一、问题与直觉:从"改像素"到"改世界"
数字对抗攻击的隐含假设是:攻击者能直接操作输入到模型的每一个像素。这在很多真实场景里并不成立。比如自动驾驶汽车的摄像头看到的是真实路况,攻击者没法直接改摄像头里的图像,只能去改真实世界里的物体——在路牌上贴东西、在衣服上印图案、在脸上戴特制眼镜。改了物理物体之后,还要经过摄像头拍摄、压缩、光照变化、角度变化、距离变化这一连串"现实干扰",模型仍然要出错,攻击才算成功。
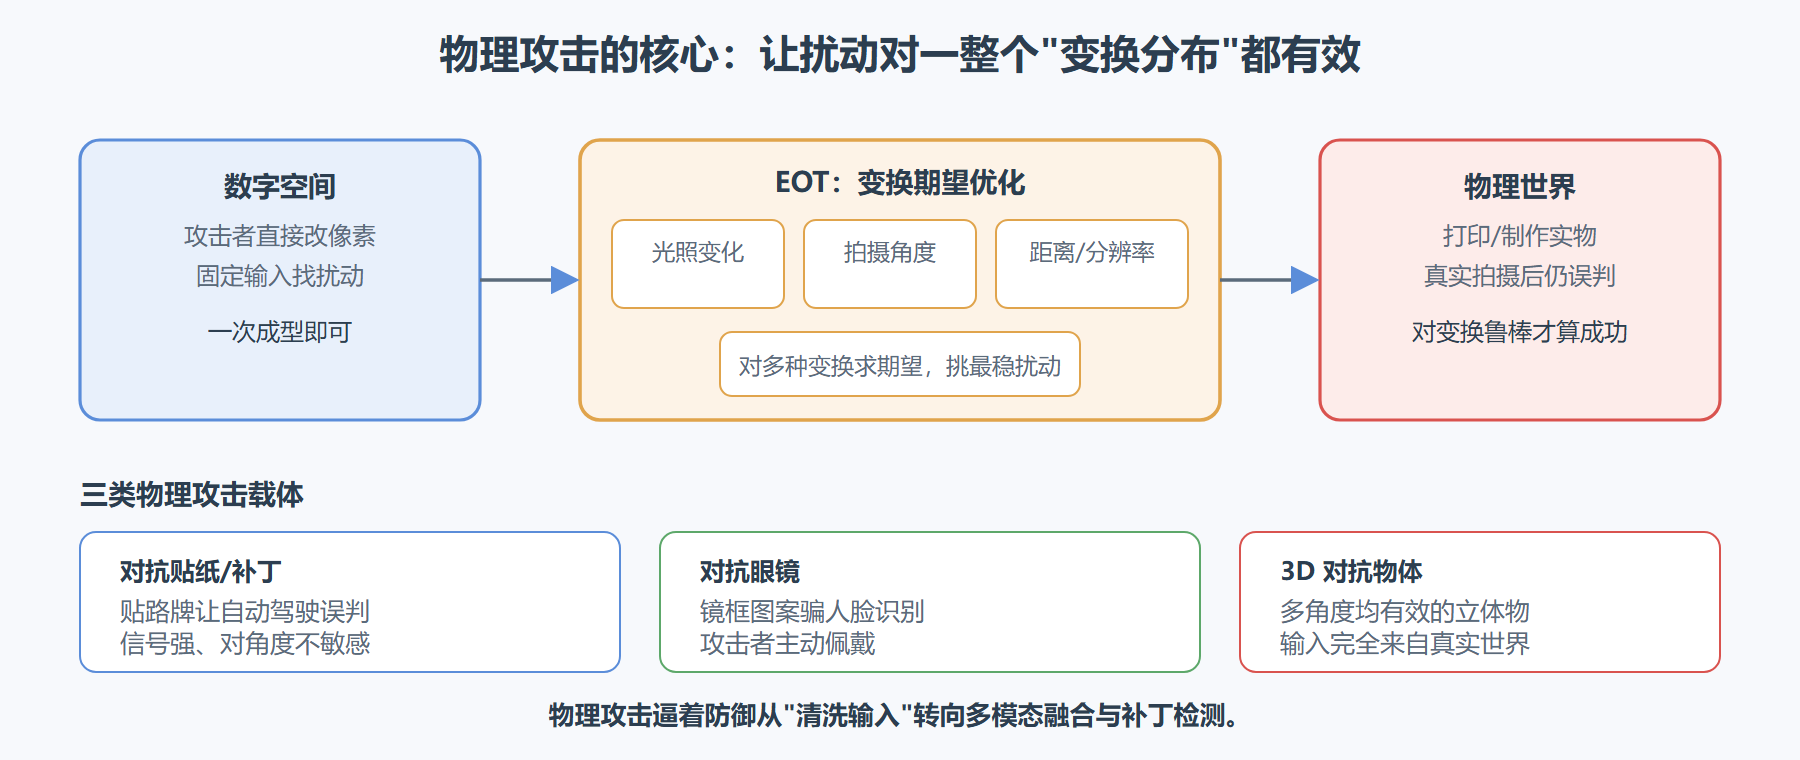
这个"经过现实世界仍有效"的要求,让物理攻击的难度大幅上升。数字攻击只要在固定输入上找到扰动,物理攻击则要求扰动对一整个"拍摄条件分布"都有效。举个直觉例子:你在数字图像上画一个让模型误判的噪声图案很容易,但把这个图案印到实物上,换个角度、换个光照,它可能就失效了。所以物理攻击的核心,不是"找到扰动",而是"找到足够鲁棒的扰动"。
物理攻击的现实意义非常大。自动驾驶、人脸门禁、安防监控、工业质检这些场景,模型面对的都是真实世界的输入。如果一个停车标志上的几块胶带就能让自动驾驶急刹车或误判,后果可能直接是安全事故。这也是物理世界对抗攻击近年来从学术研究走向产业关注的原因。
二、核心原理:物理攻击要跨过的"现实鸿沟"
物理攻击的难点可以概括为一个"鲁棒性跨越"问题。攻击者生成的扰动,要在一系列物理变换下仍然有效。这些物理变换包括:拍摄角度变化、距离远近、光照强弱、摄像头分辨率与压缩、打印时的色彩失真、物体表面的反光与遮挡等。为了克服这些,攻击者通常在生成扰动时就把这些变换"模拟"进去,用一个叫 EOT(Expectation over Transformation,变换期望)的方法:对每个候选扰动,在多种随机变换下求攻击成功率的期望,再优化这个期望。这样生成的扰动就对变换不那么敏感。
代表性物理攻击方法有几类。对抗贴纸/补丁(Adversarial Patch)是最著名的一类:生成一小块色彩强烈的图案,贴在物体上就能让模型误判。它不需要精密的打印,甚至对位置、角度都不敏感,因为补丁本身就是"最强信号",模型会不由自主地被它吸引。对抗眼镜(Adversarial Glasses)用于攻击人脸识别:在镜框上印特定图案,让系统把攻击者认成目标人物或让系统无法识别。3D 对抗物体则更进一步,直接生成一个从各个角度看都让模型误判的立体物体,比如一个让分类器误判为"乌龟"的 3D 打印模型,无论怎么旋转、怎么拍都有效。
要理解 EOT 为什么必要,可以想象一个具体的优化过程。攻击者在数字空间生成一个候选扰动后,不能只在这个固定的数字图上验证攻击是否成功——因为打印出来、拍到的画面会和数字原图有偏差。EOT 的做法是:每次评估扰动的攻击效果时,先从一组预定义的物理变换(随机旋转 ±15 度、随机缩放 0.8 到 1.2 倍、随机亮度调整、随机加高斯噪声、模拟打印的色彩偏移)里随机采样一批,把扰动施加后过这些变换,再算平均的攻击损失。优化器最小化的是这个"变换后的期望损失",而不是某一张固定图的损失。这样训练出的扰动,等价于在"所有可能的拍摄条件分布"上做了平均,因此对真实世界的随机性有抵抗力。EOT 的代价是计算量大——每次评估都要跑多个变换样本,迭代步数也更多,这也是物理攻击生成比数字攻击慢一个数量级的原因。
物理攻击还有一个数字攻击没有的维度:攻击载体的"可制造性"。一个在仿真里完美的对抗纹理,如果需要打印精度超过普通打印机的色域,或者需要表面材质在特定光线下才能呈现,那它在现实中就做不出来。所以物理攻击的优化目标里往往还要加一项"可打印性损失",约束扰动的颜色值落在打印机能还原的色域内。这个工程细节解释了为什么很多学术上成功的物理攻击,在实地复现时会失败——仿真的物理变换再全,也模拟不了真实打印机和摄像头的所有非线性。复现物理攻击时,把仿真变换和真实硬件对标一遍,往往是省不掉的前置工作。
图 2-3:数字攻击 → 物理攻击的"现实鸿沟"与 EOT 跨越
三、工程实践要点:为什么防御更棘手
物理攻击给防御带来了几个特殊挑战。第一是输入不可控:数字防御可以在输入进入模型前做清洗,但物理攻击的扰动藏在真实物体里,你没法在拍摄前"清洗"现实世界。第二是攻击隐蔽性:对抗补丁往往被设计成"看起来像普通贴纸或污渍",普通人甚至安全人员都不容易察觉异常。第三是评估困难:物理攻击的效果依赖拍摄条件,实验室里测出来的防御效果,在真实光照、天气、距离下可能完全不同。
防御物理攻击的思路大致有三条。一条是数据增强:在训练时加入各种物理变换下的对抗样本,让模型见过"真实世界的对抗样本"。一条是检测补丁:对抗补丁通常有异常的高频纹理或颜色统计,可以用专门的检测器把它挡下来。还有一条是多模态融合:结合视觉之外的信息(比如雷达、激光点云、上下文语义)交叉验证,降低单一视觉通道被欺骗的风险。但坦率地说,物理攻击防御目前还远未成熟,很多方案在更强的攻击下会被绕过。
| 攻击方法 | 载体 | 特点 | 防御难点 |
|---|---|---|---|
| 对抗贴纸/补丁 | 路牌、物体表面 | 信号强、对角度不敏感 | 外观像普通贴纸,难察觉 |
| 对抗眼镜 | 人脸、镜框 | 针对性欺骗人脸识别 | 攻击者主动佩戴,难以阻止 |
| 3D 对抗物体 | 立体实物 | 多角度均有效 | 输入完全来自真实世界,无法清洗 |
⚠️ 常见坑:用"数字对抗样本防御成功"来推断"物理攻击也能防住"。两者攻击路径完全不同,物理攻击的扰动藏在真实物体里,数字防御的经验不能直接照搬。
💡 关键直觉:物理攻击的本质是"让扰动对现实变换鲁棒"。防御它不能只靠模型,还要靠多模态、检测器与真实场景评估的组合,因为攻击发生在摄像头之前的真实世界里。
常见问题
物理对抗样本一定要打印出来吗
不一定。任何能进入摄像头视野的物理改造都可以是攻击载体,比如贴在路牌上的补丁、屏幕上显示的图案、特制的 3D 物体、印在衣服或眼镜上的纹理。关键不是"打印"这个动作,而是攻击载体要在真实世界里存在,并且经过拍摄、光照、角度、距离等一系列变换后,仍然能触发模型的误判。这也是物理攻击区别于数字攻击的本质——它发生在摄像头之前的物理世界,而不是像素空间。
为什么物理攻击比数字攻击难得多
因为数字攻击只需要在固定的输入上找到扰动,而物理攻击要求这个扰动对一整条"拍摄条件分布"都有效。打印会带来色彩失真,拍摄会引入光照和角度变化,距离会影响分辨率,遮挡会破坏扰动的完整性。攻击者必须用变换期望(EOT)等方法,把这些现实变换显式地纳入优化过程,才能生成一个"跨条件稳定"的扰动。这个额外要求让物理攻击的搜索空间和优化难度都大幅上升。
有没有办法彻底防住物理攻击
目前没有。防御只能提高攻击的成本和门槛,不能彻底消除风险。可行的做法是结合数据增强(训练时加入真实变换下的对抗样本)、补丁检测(利用补丁的高频纹理异常)、多模态融合(用雷达、激光、语义等交叉验证)做纵深防御,并且用真实场景的测试来评估防御效果,而不是只依赖实验室里的数字评估。
要点串联
- 要点一:物理攻击不能直接改像素,只能改造真实物体,再让模型在拍摄、光照、角度变化后误判。
- 要点二:物理攻击的核心难点是"鲁棒性跨越",常用 EOT 方法对多种物理变换求期望来生成稳定扰动。
- 要点三:代表方法包括对抗贴纸/补丁、对抗眼镜、3D 对抗物体,各有不同的载体与攻击面。
- 要点四:物理攻击防御更难,因为输入不可控、攻击隐蔽、评估依赖真实场景。
- 要点五:防御要结合数据增强、补丁检测与多模态融合,且目前仍不成熟,不能高估。
下一章我们从攻击转向防御,先看最主流的对抗训练与鲁棒优化,再讲检测与净化的被动防御。