6.1 评估指标 mAP 与 IoU
6.1 评估指标 mAP 与 IoU
本节摘要:检测模型有多准?本节讲 IoU、Precision/Recall、mAP、COCO 指标——衡量检测器的标尺。
本节地图
阅读完本节,你应当能够:
- 计算 IoU
- 理解 Precision/Recall
- 读懂 mAP 和 COCO 指标
概念脉络
一、IoU(交并比)
IoU(Intersection over Union)衡量预测框和真实框的重叠程度:
- IoU=1:完全重合
- IoU=0:不相交
- 通常 IoU>0.5 算正确检测(TP)
def compute_iou(box_a, box_b): """box: [x1, y1, x2, y2]""" x1 = max(box_a[0], box_b[0]); y1 = max(box_a[1], box_b[1]) x2 = min(box_a[2], box_b[2]); y2 = min(box_a[3], box_b[3]) inter = max(0, x2 - x1) * max(0, y2 - y1) area_a = (box_a[2]-box_a[0]) * (box_a[3]-box_a[1]) area_b = (box_b[2]-box_b[0]) * (box_b[3]-box_b[1]) union = area_a + area_b - inter return inter / union if union > 0 else 0
IoU 是"框和框有多像"的度量,检测的每个环节(标签分配、NMS、评估)都在用它。注意 IoU 只看重叠面积,不看中心距离和长宽比——两个中心相距很远但面积重叠大的框,IoU 也会高,这是 IoU 家族的 DIoU/CIoU 要补的缺陷。
二、TP/FP/FN
| 缩写 | 含义 |
|---|---|
| TP | 真阳性:检测对且 IoU>阈值 |
| FP | 假阳性:检测错或 IoU<阈值 |
| FN | 假阴性:漏检(真实目标未检测到) |
TP/FP/FN 的判定需要"预测框与真值框匹配":通常每个真值框最多匹配一个预测框,匹配成功记 TP,多余的预测框记 FP,没被匹配的真值框记 FN。匹配的 IoU 阈值不同(0.5 还是 0.75),统计结果天差地别。
三、Precision 和 Recall
- Precision 高:检出的多为对,但可能漏
- Recall 高:真目标多检出,但可能有误检
- 两者权衡,看 PR 曲线
Precision 和 Recall 是矛盾的两端:把置信度阈值调低,检出更多框,Recall 上升但误检增加,Precision 下降;阈值调高则相反。单独报一个数字没有意义,必须看两者随阈值变化的整条曲线。
四、PR 曲线与 AP
图 6-1 PR 曲线与 mAP
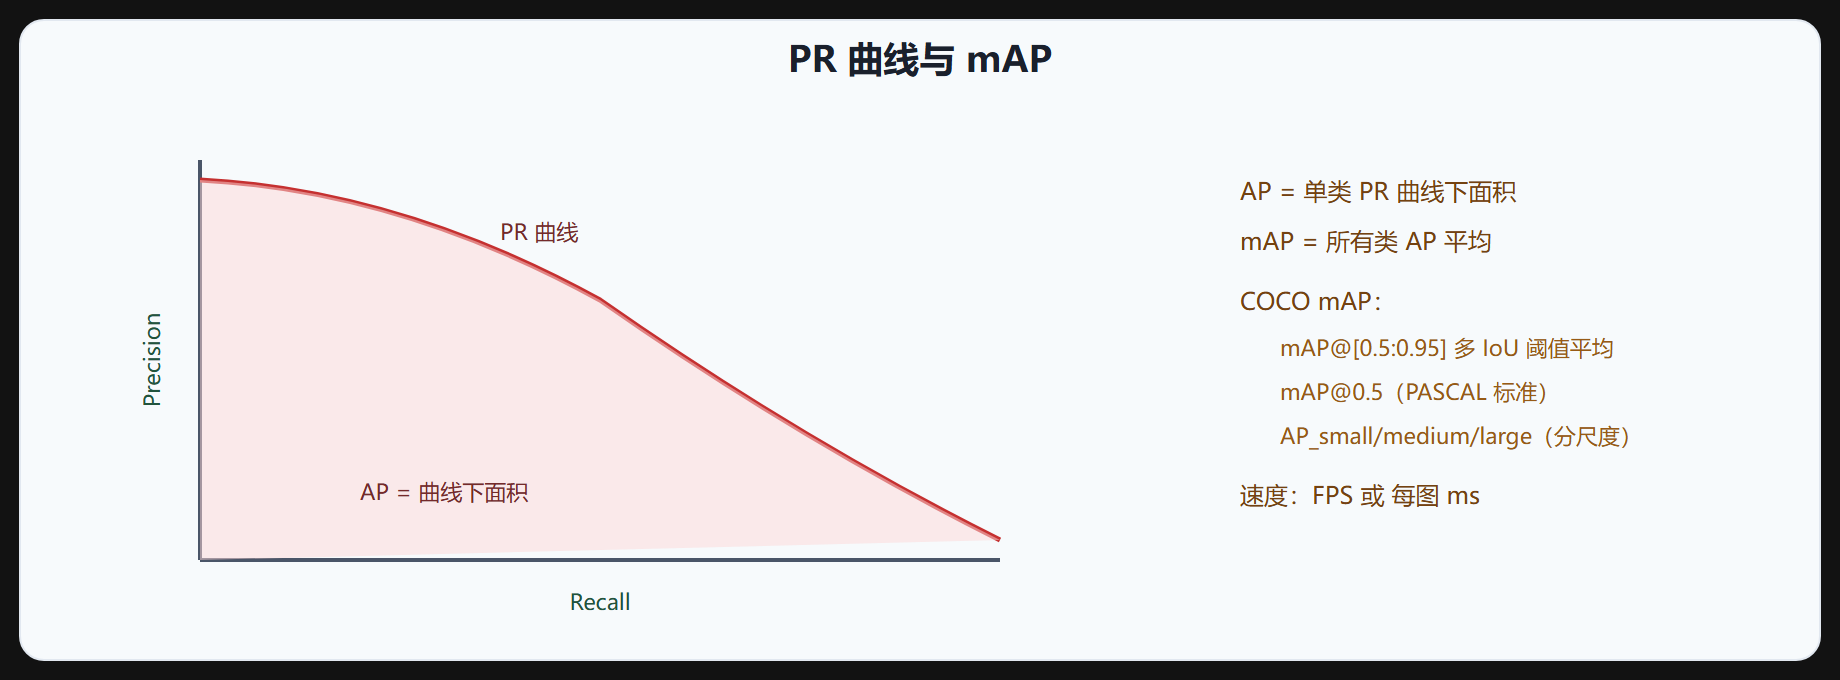
按置信度阈值从高到低排序检测,计算每个阈值下的 Precision/Recall,画 PR 曲线。AP(Average Precision)= PR 曲线下面积。
# 计算 AP 的核心逻辑(按置信度降序累积 TP/FP) def compute_ap(scores, gt_flags): """scores: 所有预测框的置信度;gt_flags: 是否匹配到真值""" order = np.argsort(scores)[::-1] tp = gt_flags[order].cumsum() fp = (1 - gt_flags[order]).cumsum() recall = tp / num_gt precision = tp / (tp + fp) # 曲线下面积(VOC 的 101 点插值或 COCO 的 100 段积分) return np.trapz(precision, recall)
AP 把"检测出的有多准"和"真目标检出多少"压缩成一个数字,同时它又随 IoU 阈值变化——所以现代评估会报告不同 IoU 下的 AP 值。
五、mAP
mAP(mean Average Precision)= 所有类别 AP 的平均:
mAP 是检测最核心的指标,综合精度和召回。
为什么按类别平均而不是全局统计?不同类别的难易差异很大:行人这种细长目标和小轿车这种紧凑目标,AP 可能差 20 个点。按类别平均后,稀有类别、难类别的表现不会完全被易类别淹没,更能反映模型的真实水平。
六、COCO 评估指标
COCO 数据集定义更严格的评估:
| 指标 | 说明 |
|---|---|
| mAP@[0.5:0.95] | IoU 从 0.5 到 0.95 步长 0.05 的平均(主指标) |
| mAP@0.5 | IoU=0.5 的 mAP(PASCAL VOC 标准) |
| AP_small | 小目标 AP |
| AP_medium | 中目标 AP |
| AP_large | 大目标 AP |
| AR | 平均召回(类似 mAP 但看召回) |
COCO 主指标 mAP@[0.5:0.95] 比 VOC 的 mAP@0.5 严格得多(要求高 IoU 下也准)。
mAP@0.5 只要框和真值有 50% 重叠就算对,很多"框得比较偏"的错误被容忍;mAP@[0.5:0.95] 在 0.5 到 0.95 十个 IoU 阈值下分别算 AP 再平均,要求框在高重叠下也准。这也是为什么同一模型在两个指标上数字差很大——COCO 主指标对框的精细程度更敏感。
七、速度指标
| 指标 | 说明 |
|---|---|
| FPS | 每秒处理帧数 |
| 延迟 | 每图处理时间(ms) |
| FLOPs | 计算量 |
| 参数量 | 模型大小 |
注意 FPS 依赖硬件和输入尺寸,对比要固定条件。FPS 与延迟是倒数关系,但批处理时延迟可能不变而吞吐上升,评测时要明确是单帧延迟还是批量吞吐。FLOPs 只反映理论计算量,实际速度还受访存、算子实现影响,只能做粗略参考。
八、评估注意事项
- 看分尺度:别只看总 mAP,看 AP_small(小目标难)
- 看速度:精度和速度权衡,固定硬件对比
- 看置信度:PR 曲线随置信度阈值变
- 看 IoU 阈值:mAP@0.5 比 mAP@[0.5:0.95] 高很多
问:mAP 高就一定好用吗? 不一定。业务还要看具体错误类型:安防场景假阳性(误报)比假阴性(漏报)成本低,医疗相反。mAP 是综合指标,业务上线前要按场景看 Precision/Recall 的取舍点,甚至单独统计特定类别、特定尺度的表现。
⚠️ 常见坑:只看 mAP@0.5 不看 mAP@[0.5:0.95]——前者宽松(IoU 0.5 就算对),后者严格(高 IoU 也要准),COCO 主指标是后者。
💡 关键直觉:IoU 衡量框重叠,TP/FP/FN 算 Precision/Recall,PR 曲线下面积是 AP,各类 AP 平均是 mAP。COCO 主指标 mAP@[0.5:0.95](严格)。还要看分尺度 AP 和速度。
重点提炼
- IoU:交并比,>0.5 通常算 TP。
- TP/FP/FN:真阳性/假阳性/假阴性,按 IoU 阈值匹配统计。
- Precision/Recall:检测出的多准/真目标检出多少。
- PR 曲线:不同置信度阈值的 P-R,曲线下面积 = AP。
- mAP:各类 AP 平均,检测核心指标。
- COCO 指标:mAP@[0.5:0.95](主指标,严格)、mAP@0.5、AP_small/medium/large、AR。
- 速度:FPS、延迟、FLOPs、参数量,固定硬件对比。
- 注意:看分尺度、看速度、看 IoU 阈值,COCO 主指标严格。
下一节讲模型部署。