6.2 模型部署与工程实践
6.2 模型部署与工程实践
本节摘要:训练好的模型要部署到生产。本节讲端到端部署流程、推理优化、边缘部署——让检测器真正跑起来。
上手前先明确
阅读完本节,你应当能够:
- 完成检测模型端到端部署
- 优化推理速度
- 部署到边缘设备
概念脉络
一、端到端部署流程
图 6-2 部署流程
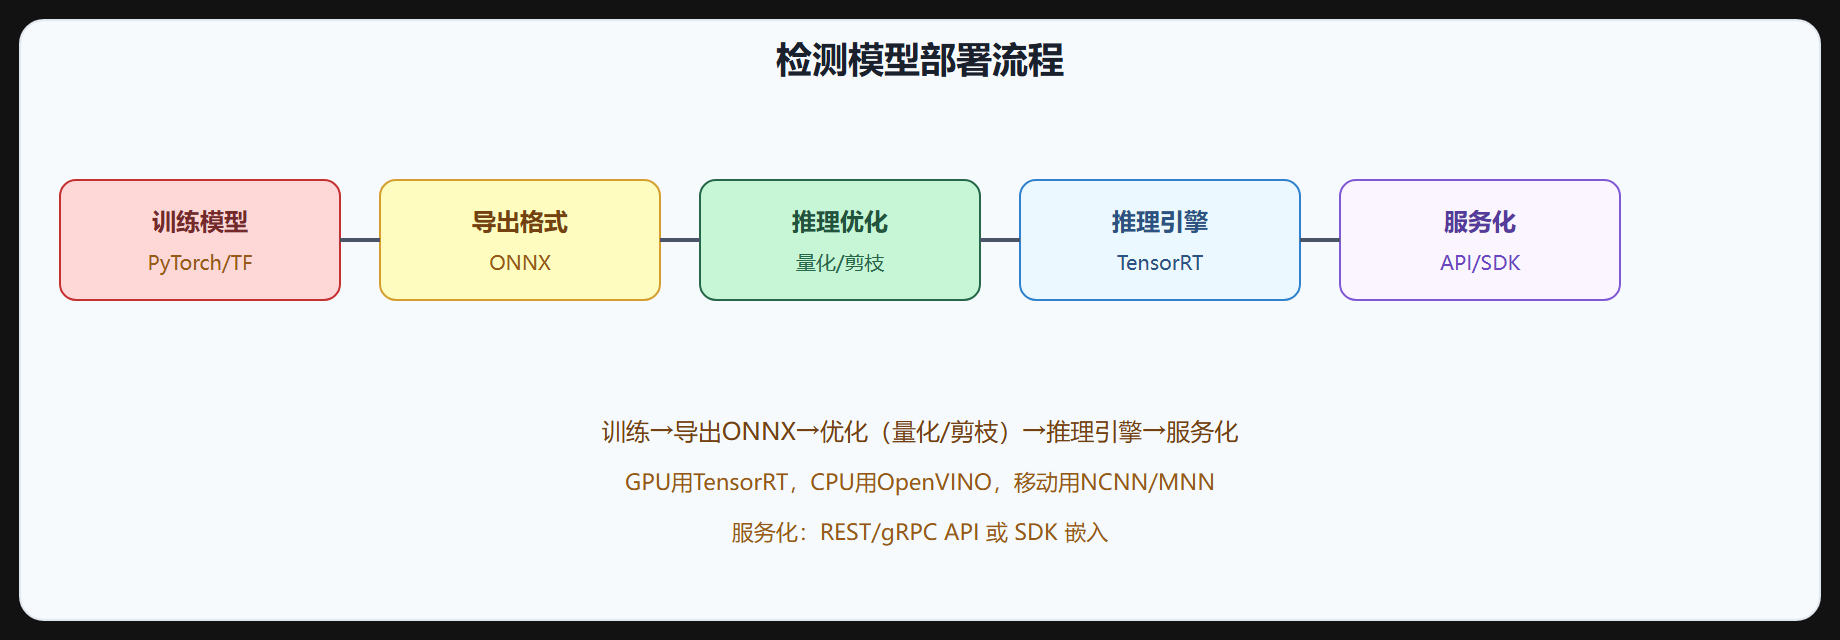
- 训练模型:PyTorch/TensorFlow 训练
- 导出格式:转 ONNX(跨平台中间格式)
- 推理优化:量化、剪枝、层融合
- 推理引擎:TensorRT/OpenVINO/ONNX Runtime
- 服务化:REST/gRPC API 或 SDK 嵌入
二、导出 ONNX
# PyTorch 导出 ONNX torch.onnx.export(model, dummy_input, "model.onnx", opset_version=12, input_names=["input"], output_names=["output"])
ONNX 是跨平台中间格式,可在不同推理引擎运行。导出时要固定输入尺寸或声明动态轴,检测模型通常要动态 batch 和动态分辨率;opset 版本决定支持的算子集合,YOLO 里的 Focus、上采样等自定义算子需要 torch 的 ONNX 导出支持,版本不匹配会报错。
三、推理优化
| 优化 | 说明 | 加速 |
|---|---|---|
| 量化(INT8) | FP32→INT8 | 4x |
| 层融合 | 合并连续层 | 1.5x |
| 剪枝 | 去冗余通道 | 2x |
| TensorRT | NVIDIA 优化 | 2-3x |
推理优化可以叠加:先剪枝压缩模型,再量化为 INT8,最后交给 TensorRT 做层融合和内核自动调优,端到端加速常常超过 10 倍。每步优化都要在验证集上复测精度,避免优化过头。
四、推理引擎选择
| 引擎 | 平台 | 特点 |
|---|---|---|
| TensorRT | NVIDIA GPU | 最强 GPU 加速 |
| ONNX Runtime | 跨平台 | 通用 |
| OpenVINO | Intel CPU | CPU 优化 |
| NCNN | 移动端 | 腾讯,ARM 优化 |
| MNN | 移动端 | 阿里 |
| Core ML | iOS | Apple |
| TFLite | Android |
引擎选择跟着部署硬件走:GPU 服务器用 TensorRT,Intel CPU 用 OpenVINO,手机端 iOS 用 Core ML、Android 用 TFLite/NCNN。如果还没定硬件,先导出 ONNX 作为通用格式,再按目标平台转对应引擎。
五、GPU 部署(TensorRT)
# TensorRT 优化 import tensorrt as trt builder = trt.Builder(logger) network = builder.create_network() parser = trt.OnnxParser(network, logger) parser.parse_from_file("model.onnx") # 构建引擎 engine = builder.build_cuda_engine(network)
TensorRT 做层融合 + INT8 量化 + 内核自动调优,GPU 推理最快。构建引擎时还可以设置工作空间大小、精度模式(FP16/INT8)、动态形状范围。注意 TensorRT 的引擎文件与 GPU 型号绑定,换卡要重新构建。
六、边缘部署
边缘设备(Jetson、树莓派、手机)资源受限:
- 模型选择:YOLOv5n/s、MobileNet 骨干
- 量化:INT8/FP16
- 剪枝:去冗余
- 推理引擎:NCNN/MNN/TFLite
- 输入尺寸:减小(如 320x320)
边缘部署的算术很简单:显存/内存决定模型上限,功耗决定可持续运行时长,时延决定能跑多复杂的流程。Jetson 系列有专用 TensorRT 支持,手机端用 NCNN/MNN 配合 ARM 优化,树莓派这类 CPU 板子则要靠小模型 + 量化 + 低分辨率三管齐下。
七、服务化
| 方式 | 说明 |
|---|---|
| REST API | HTTP 接口,通用 |
| gRPC | 高性能 RPC |
| SDK 嵌入 | 直接集成到应用 |
| 流式 | 视频流实时检测 |
# 简易 REST 推理服务(Flask 风格伪代码) @app.post("/detect") def detect(): img = preprocess(request.files["image"]) # 预处理与训练一致 boxes, labels, scores = model(img) return {"boxes": boxes, "labels": labels, "scores": scores}
视频流场景要额外处理:多路视频的并发调度、丢帧策略、跟踪模块衔接。批处理(多帧一起推理)能提高 GPU 吞吐,但要控制延迟上限。
八、部署注意事项
- 预处理一致:部署预处理和训练一致(归一化、resize)
- 后处理:NMS、框解码要正确实现
- 版本管理:模型版本化,灰度发布
- 监控:推理延迟、错误率、资源占用
- A/B 测试:新模型灰度对比
问:为什么训练好的模型部署后精度暴跌? 90% 是预处理不一致:训练用 BGR、部署用 RGB;训练归一化除以 255 再减均值,部署漏了一步;训练 resize 到 640,部署传了不同尺寸。先逐项核对预处理,再怀疑模型问题。建议把预处理封装成与训练完全一致的独立函数,单元测试输入同一张图对比张量是否一致。后处理同样要核对:训练时的 NMS 阈值、置信度阈值要和部署参数保持一致,否则线上结果与离线评估对不上。
九、常见排错清单
| 现象 | 排查方向 |
|---|---|
| 精度暴跌 | 预处理、后处理、输入尺寸 |
| 推理报错 | ONNX 导出算子、opset、动态轴 |
| 显存溢出 | 输入分辨率、batch、精度模式 |
| 延迟超时 | 层融合、量化、批处理 |
| 结果框乱 | NMS 阈值、框解码、坐标缩放 |
⚠️ 常见坑:部署预处理和训练不一致——训练归一化用 ImageNet 均值方差,部署用了不同值,精度暴跌。预处理必须严格一致。
💡 关键直觉:部署流程:训练→导出 ONNX→优化(量化/剪枝)→推理引擎→服务化。GPU 用 TensorRT,CPU 用 OpenVINO,移动用 NCNN/MNN。边缘用小模型+量化。预处理必须和训练一致。
本章回顾
- 流程:训练→导出 ONNX→优化→推理引擎→服务化。
- ONNX:跨平台中间格式,注意 opset 与自定义算子。
- 优化:量化(INT8 4x)、层融合、剪枝、TensorRT。
- 推理引擎:TensorRT(GPU)、ONNX Runtime(通用)、OpenVINO(CPU)、NCNN/MNN(移动)、Core ML(iOS)。
- 边缘部署:小模型+量化+剪枝+小输入。
- 服务化:REST/gRPC/SDK/流式。
- 注意:预处理一致、后处理正确、版本管理、监控、A/B 测试。
下一节讲数据集和基准。