6.3 数据集与基准平台
6.3 数据集与基准平台
本节摘要:训练和评估检测器需要数据集和基准。本节讲 COCO、VOC、Open Images 等主流数据集和基准平台——检测器的"考场"。
本节导读
阅读完本节,你应当能够:
- 区分主流检测数据集
- 知道各数据集特点
- 了解基准平台
概念脉络
一、主流检测数据集
图 6-3 主流数据集对比
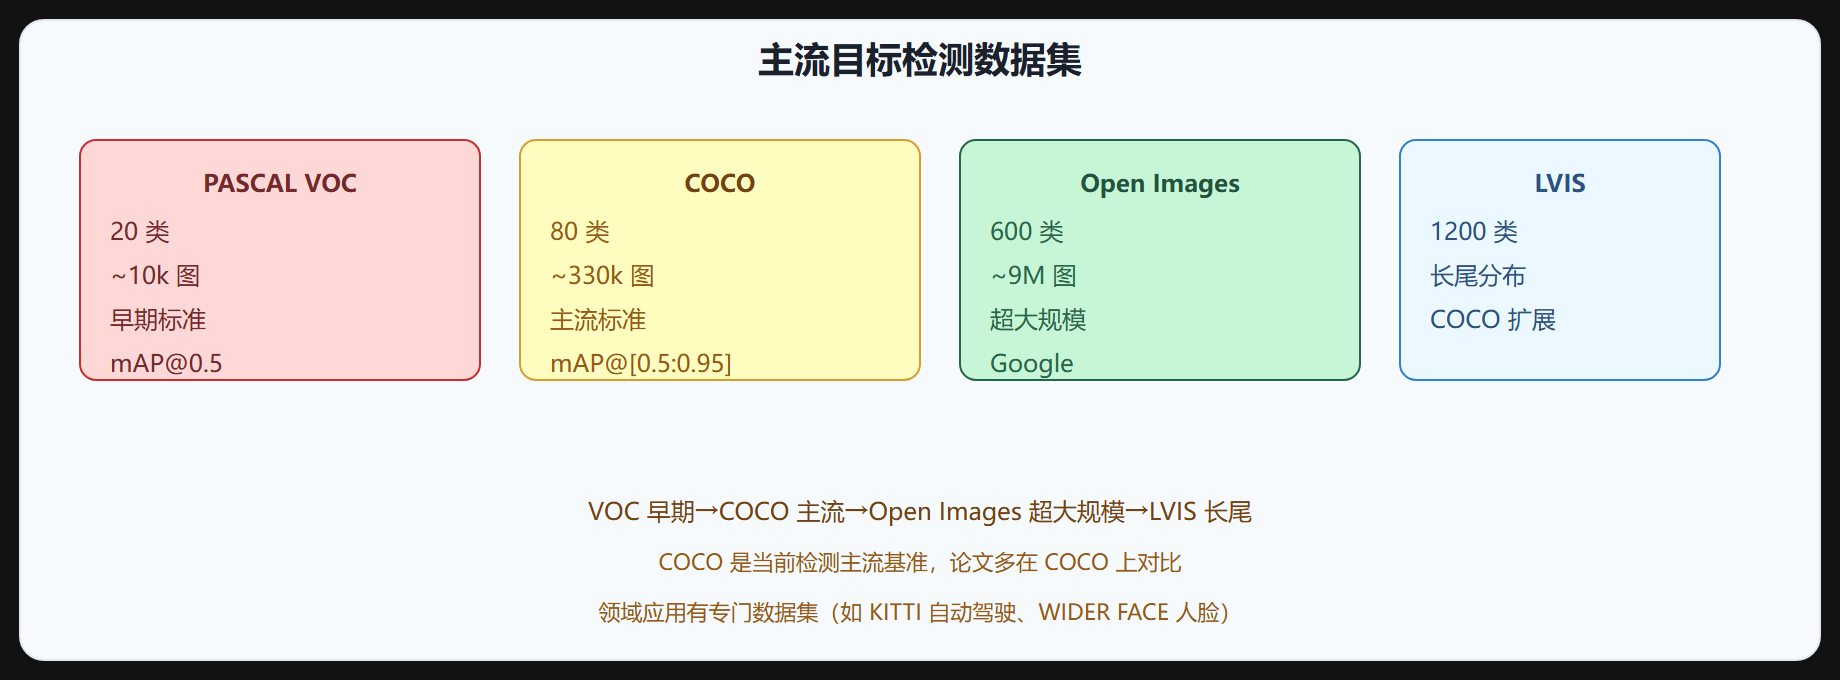
| 数据集 | 类别 | 图像数 | 特点 |
|---|---|---|---|
| PASCAL VOC | 20 | ~10k | 早期标准,mAP@0.5 |
| COCO | 80 | ~330k | 主流标准,mAP@[0.5:0.95] |
| Open Images | 600 | ~9M | 超大规模,Google |
| LVIS | 1200 | - | 长尾分布,COCO 扩展 |
| Objects365 | 365 | ~600k | 大规模日常场景 |
二、PASCAL VOC
PASCAL VOC(2007-2012)是早期检测标准:
- 20 类(人、车、动物等)
- ~10k 图像
- 评估用 mAP@0.5(IoU=0.5)
- 现已少用作主基准,但简单易用,适合学习
VOC 的价值在"教学友好":20 个类别、标注规范、规模小,一个下午就能跑完一轮训练,适合初学验证流程。R-CNN 论文就是在 VOC 上把 mAP 从 35% 提到 58%,历史意义重大。
三、COCO(最重要)
COCO(Common Objects in Context)是当前检测主流基准:
- 80 类日常物体
- ~330k 图像,~1.5M 实例
- 评估用 mAP@[0.5:0.95](严格)
- 分 AP_small/medium/large
- 还有分割、关键点标注
COCO 是检测论文的标准对比平台,YOLO、Faster R-CNN 等都在 COCO 上报告性能。
COCO 为什么成为标准?三个原因:一是图像复杂,目标在自然场景中,有遮挡、截断、小目标,比 VOC 更能反映真实难度;二是评估严格,mAP@[0.5:0.95] 要求高 IoU 也准;三是任务全,检测、分割、关键点、密集遮挡(crowd 标注)一套数据全搞定,论文对比零门槛。
四、Open Images
Google 的超大规模数据集:
- 600 类
- ~900 万图像
- 类别多、数据量大
- 适合大规模预训练
Open Images 的标签来自众包和自动标注混合,含大量层次类别和图片级标签,噪声比 COCO 大,但规模优势明显。它更适合做预训练:先用 900 万图让模型见过足够多样的视觉世界,再在下游数据上微调。
五、领域数据集
| 数据集 | 领域 |
|---|---|
| KITTI | 自动驾驶(车、人、cyclist) |
| WIDER FACE | 人脸检测 |
| Caltech Pedestrian | 行人检测 |
| ImageNet Det | 200 类检测 |
| ADE20K | 语义分割 |
领域数据集的价值是"场景真实":KITTI 的车是俯视视角、有大量遮挡,和 COCO 里的"车"分布完全不同;WIDER FACE 的小脸、密集脸是人脸场景特有的难度。做垂直项目,优先找领域数据集做预训练或混合训练,比直接用 COCO 权重更贴合。
六、基准平台
| 平台 | 说明 |
|---|---|
| Papers with Code | 论文+代码+排行榜 |
| COCO leaderboard | COCO 官方榜 |
| ONNX Model Zoo | 预训练模型 |
| TorchHub | PyTorch 预训练 |
| Hugging Face | 模型仓库 |
看论文时先看它在哪个基准上报告、用什么指标,数字才可比。Papers with Code 把论文、代码、榜单绑在一起,是快速了解"某任务当前 SOTA"的入口;模型仓库(Hugging Face、ONNX Zoo)适合直接下载预训练权重做迁移学习。
七、自定义数据集
实际项目多用自己的数据集:
- 数据采集:采集场景图像
- 标注:用 LabelImg/CVAT/Roboflow 标框
- 格式:COCO 格式(JSON)或 YOLO 格式(txt)
- 划分:训练/验证/测试集
- 数据增强:训练时增强
# YOLO 格式:每张图一个 txt,每行:类别 中心x 中心y 宽 高(归一化) # 0 0.432 0.518 0.132 0.241 # 1 0.721 0.335 0.088 0.104
标注质量直接决定模型上限:框画偏 10 像素,IoU 阈值 0.75 的评估就会判错。采集时注意覆盖场景变化(光照、角度、天气),标注时定好框边界规则(遮挡目标怎么框、边缘目标要不要),比事后调模型更有效。
八、标注工具
| 工具 | 特点 |
|---|---|
| LabelImg | 简单离线标注 |
| CVAT | 在线,功能全 |
| Roboflow | 在线,自动增强 |
| Labelme | 多边形+框 |
小项目用 LabelImg 就够;团队协作、多人并行用 CVAT;Roboflow 的优势是标注后直接做增强和格式转换。标注环节还可以引入预标注:先用现有模型自动出框,人工只修正,能把标注成本压到三分之一。
九、迁移学习
实际项目常在 COCO 预训练基础上微调:
# 加载 COCO 预训练 YOLOv5 model = torch.hub.load('ultralytics/yolov5', 'yolov5s', pretrained=True) # 微调到自定义数据 model.train(data='custom.yaml', epochs=100)
迁移学习让小数据集也能训出好模型。微调时注意:数据量小就冻结前几层(只训练检测头),数据量大再全量微调;类别数和 COCO 不同时要替换输出层;学习率比从头训练低一个数量级,避免破坏预训练特征。
十、数据规模经验
| 每类样本量 | 建议 |
|---|---|
| <100 | 迁移学习 + 强增强 + 预标注扩充 |
| 100~1000 | 迁移学习 + 常规增强 |
| >1000 | 全量训练 + 数据清洗 |
问:数据量不够怎么办? 按顺序试:预标注扩充 → Copy-Paste 合成 → 公开数据集混合 → 半监督伪标签。先确认数据质量(错标、漏标)再谈数量,错标数据的危害比少数据更大。
⚠️ 数据集选择:学习用 VOC(简单),研究对比用 COCO(标准),大规模预训练用 Open Images,实际项目用自定义+COCO 预训练微调。
💡 关键直觉:VOC 早期(20 类)、COCO 主流(80 类,mAP@[0.5:0.95])、Open Images 超大规模(600 类)、LVIS 长尾。COCO 是论文标准对比平台。实际项目用自定义数据集+COCO 预训练微调。
要点串联
- VOC:20 类,~10k 图,早期标准,mAP@0.5,适合学习。
- COCO:80 类,~330k 图,主流标准,mAP@[0.5:0.95],分尺度 AP。
- Open Images:600 类,~9M 图,超大规模,Google,适合预训练。
- LVIS:1200 类,长尾分布。
- 领域数据集:KITTI(自动驾驶)、WIDER FACE(人脸)。
- 基准平台:Papers with Code、COCO leaderboard、ONNX Model Zoo。
- 自定义:采集→标注(LabelImg/CVAT)→格式(COCO/YOLO)→划分→增强。
- 迁移学习:COCO 预训练+自定义微调,小数据也能训好,按数据量决定冻结策略。
第 6 章结束。本教程全部完成。