1.4 LSM 与 B+树选型:何时选哪个
1.4 LSM 与 B+树选型:何时选哪个
本节摘要:选型问题没有标准答案,但有一条可推导的判断路径。本节用读放大的数学直觉作为切入点,对比 B+树(就地更新)与 LSM-Tree(追加写)在写入放大、读放大、空间放大三个维度上的天然差异,给出"读多写少选 B+树、写多读少选 LSM"的粗判断,再补充数据量、硬件、查询模式三个修正因子。看完你能对着自己的负载画出一条清晰的选型决策线。
先说结论
阅读完本节,你应当能够:
- 从磁盘物理特性出发,推导 B+树与 LSM 在写入路径上的本质差异
- 用"三放大"框架比较两类引擎的代价结构
- 根据读写比例、数据量、硬件与查询模式做初步选型
- 说清"没有更好的引擎,只有更合适的引擎"这句行话的具体含义
一、问题与直觉
先问一个会被反复追问的问题:为什么 MySQL 的 InnoDB 用 B+树,而 LevelDB 用 LSM?是不是 LSM 更先进?
都不是。答案藏在两种结构对磁盘随机写的态度里。
B+树信奉"就地更新":数据在磁盘上保持有序,插入/更新时找到对应页改掉。这在读多写少的场景下非常香——读路径稳定,一次查询就是 O(log n) 次页访问。但写入时,每一次随机插入都可能引发页分裂、回写,本质是随机 I/O。机械硬盘时代,随机写是性能毒药。
LSM 信奉"推迟整理":写入先到内存,攒成顺序流落盘,整理交给后台。写入吃满顺序带宽,但读取要跨多层找数据,读放大是它的原罪。
一句话:B+树把成本押在写入上,LSM 把成本押在读取上。 选谁,取决于你的业务更怕哪种成本。
二、核心原理
三放大的数学直觉
两个引擎真正的差别,用"三放大"能算清楚:
| 放大维度 | B+树 | LSM-Tree |
|---|---|---|
| 写放大 | 低(就地更新) | 高(多次重写) |
| 读放大 | 低(O(log n) 页访问) | 高(多层查找) |
| 空间放大 | 低(页内碎片小) | 高(旧版本 + 墓碑未清) |
写放大的公式直觉:LSM 中一个键从 L0 沉降到最底层 Ln,每层 10 倍容量增长,如果层数是 L,它平均要被重写约 L/2 次。层数越多、数据越大,写放大越明显。
读放大的公式直觉:LSM 的点查在最坏情况下要检查 MemTable + Immutable + 全部 L0 文件 + 每深一层各一个文件。布隆过滤器能把"键不存在"的大部分查询挡掉,但"键存在且在深层"时,代价仍然存在。
三个修正因子
只看读写比例太粗,真实选型还要加三个修正:
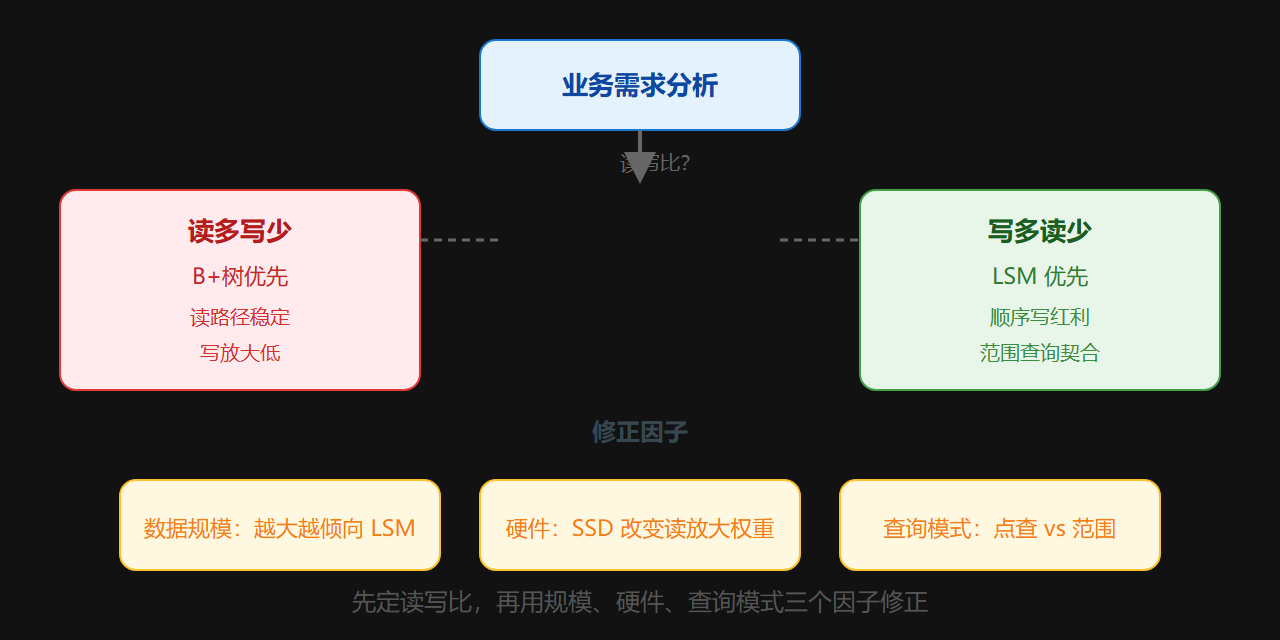
1. 数据规模。 LSM 的优势在数据量超过内存时更加显著——因为它的写路径几乎不依赖数据量。B+树在数据量巨大时,随机写问题会被放大。所以"大数据量 + 高写入"几乎必然指向 LSM。
2. 硬件代际。 这个修正因子最容易被忽略。LSM 的设计前提是"随机写远慢于顺序写"——这在机械硬盘时代铁板钉钉,但在 NVMe SSD 时代,随机读延迟已经低到接近顺序读,读放大的绝对代价变小了。所以 SSD 上 LSM 的读路径没以前那么难受,但写放大对闪存寿命的威胁反而更突出。硬件在变,选型结论也要跟着变。
3. 查询模式。 点查密集的场景,B+树读路径更稳定;而范围查询密集、且数据更新频繁的场景,LSM 的有序合并反而有优势(B+树的范围扫描要处理页分裂后的碎片化)。
三、工程实践要点
一个可执行的判断流程
- 先定读写比例:写密集(写占比显著高于读)倾向 LSM,读密集倾向 B+树。
- 再看数据规模:远超内存,且增长快,优先 LSM。
- 再看查询模式:点查为主 → 评估读放大可接受度;范围扫描为主 → LSM 天然契合。
- 最后看硬件:HDD 上 LSM 写优势最大;SSD 上权衡写放大与闪存寿命。
- 别忘了运营约束:需要 SQL/事务/二级索引 → 选成熟数据库(其底层可能是 LSM,如 MyRocks、TiKV)。
| 场景 | 推荐方向 | 理由 |
|---|---|---|
| 日志、时序、事件流 | LSM | 写密集,顺序写红利最大 |
| 用户档案、配置读取 | B+树 | 读多写少,读路径稳定 |
| 缓存热点数据 | LSM 或 B+树 | 看写入频率 |
| 区块链状态存储 | LSM | 追加式区块 + 快照语义契合 |
⚠️ 常见坑:用"速度"做唯一选型标准。LevelDB 顺序写快,不等于你的业务就适合它——如果你的业务 95% 是点查,一个 HDD 上的 LevelDB 可能比 B+树更慢,因为读放大 + 磁盘随机读会吃掉所有写入红利。
💡 关键直觉:把三放大想成一份"代价账单"。选引擎不是选优点最多的,而是选"账单最匹配自己收入结构"的。你的业务挣的是写入吞吐,就选 LSM;挣的是读取稳定性,就选 B+树。
SOURCE 独有事实
一个容易被忽视的细节:LevelDB 的读取路径对"键不存在"的查询特别友好——因为布隆过滤器能让绝大多数不存在的键在内存里就被判定,根本不触发磁盘 I/O。这意味着如果你的业务有大量"探活式查询"(查一个很可能不存在的键),LSM 的读代价并没有想象中可怕。这是对比选型时很多人漏掉的加分项。
四、深入展开:选型不是二选一
图:B+树与 LSM 的选型决策图
一个常被忽略的中间地带:混合引擎
教科书式的选型总在"LSM vs B+树"之间二选一,但真实工业界大量存在混合方案。最典型的例子是 MySQL 的 MyRocks(用 RocksDB 替换 InnoDB):它在 SQL 和事务语义不变的前提下,把底层存储从 B+树换成 LSM,从而让读多写多的业务获得写入红利。这种"上层语义不变、下层引擎替换"的混合思路,正是 LSM 成熟后被广泛采用的路径。
另一个方向是存算分离架构下的分层:热数据放内存引擎、温数据放 LSM、冷数据放对象存储。这时候"选哪个引擎"的问题变成了"数据在哪个生命周期该用哪个引擎"。对工程师来说,掌握"三放大"框架的意义正在于此——它让你能评估每种分层方案的成本结构,而不是死守一个引擎。
用数据说话:三个决策场景推演
场景 A:订单流水查询系统。读写比约 1:10,点查为主,偶尔按用户查历史订单。数据量中等。选型推演:写少读多 → 读路径稳定优先 → B+树更合适。如果硬上 LSM,读放大在点查密集场景会抵消写优势。
场景 B:物联网设备数据采集。每秒百万级上报,写密集,按设备和时间范围查询。选型推演:写密集 + 范围查询 → LSM 天然契合。B+树在如此高的写入下会频繁页分裂,性能崩得很快。
场景 C:用户会话状态存储。读写比例接近 1:1,单键点查,数据有 TTL 性质。选型推演:读写均衡,点查为主。此时三放大都不是决定因素,更要紧的是删除与空间回收——如果你需要快速过期清理,LSM 的墓碑延迟回收会是个麻烦,可能需要评估 B+树或带 TTL 支持的衍生品。
这三个推演说明,选型判断的关键不是"记住哪个引擎更好",而是"对着自己的读写比、查询模式、删除模式,算出两种结构各自的代价账"。
一个易被忽视的运维维度:复杂度
选型还要算运维账。LevelDB 参数少、单写者、代码精简,出问题时排查路径短;RocksDB 参数数百个,灵活但配置失误风险高;B+树数据库(如 InnoDB)功能完整但意味着要运维一个数据库服务。对中小团队,引擎的"易排查性"可能比"理论性能"更重要——一个能快速定位问题的系统,比一个理论最快但出了事无从下手的系统值钱得多。
常见问题
问:为什么分布式数据库里 LSM 这么流行? 因为分布式场景天然需要高写入吞吐来消化多节点的写入压力,而 LSM 的顺序写特性让每节点都能高效吸收;同时分布式层可以解决 LSM 在单机上的痛点(如用多副本分担读放大、用事务层补齐语义)。TiKV、CockroachDB 都是这个思路。
问:SSD 普及后,B+树会不会回归? 部分场景会。随机读延迟大降后,B+树读路径的优势缩水,但它的写放大低、空间利用率高这些优点还在。所以更可能出现的是"针对 SSD 特性重新设计的混合结构",而不是简单的二选一回归。这提醒我们:选型结论有保质期,硬件变了要重新算账。
问:这个教程为什么选 LevelDB 而不是 RocksDB 讲? 因为 LevelDB 是"最小可理解的完整实现"。RocksDB 的功能增强太多,学起来容易被细节淹没;LevelDB 把 LSM 的核心机制以最清晰的方式呈现,学会了它,再学 RocksDB 就是"在这个骨架上做加法"。
一张便于携带的选型速查卡
| 业务特征 | 首选方向 | 关键理由 |
|---|---|---|
| 写占比高、数据量大 | LSM 系 | 顺序写红利 + 不依赖数据量 |
| 读占比高、点查为主 | B+树系 | 读路径稳定、写放大低 |
| 大量"键不存在"查询 | LSM 系 | 布隆过滤器拦截,读代价被低估 |
| 范围扫描频繁 | LSM 系 | 有序合并契合扫描 |
| 删除频繁且量大 | 谨慎评估 | 墓碑延迟回收是共性代价 |
| 需要 SQL/事务/二级索引 | 完整数据库 | 语义层决定,引擎可替换 |
这张表不是教条,而是一份"初始假设"。真正下结论前,永远要用你自己的负载跑一次基准测试——数据会告诉你答案,而不是这张表。
最后说一句选型的心态:选型是接受不完美的过程,不是寻找完美的过程。 每种引擎都有它固有的代价,你要做的不是找到一个"没缺点"的方案,而是选一个"缺点你能接受"的方案。如果你抱着"肯定有个十全十美的引擎"的心态去找,你会一直失望——因为存储系统的本质就是一连串权衡。带着这个心态进入后面的章节,你会发现每一次设计选择都变得可以理解,因为你知道它背后是在为某种权衡买单。
重点提炼
- 要点一:B+树把成本押在写入(就地更新),LSM 把成本押在读取(多层查找)。
- 要点二:三放大框架——写放大、读放大、空间放大——是两种结构的核心差异点。
- 要点三:写密集 + 数据量大 + 范围查询,倾向 LSM;读密集 + 点查 + 数据量可控,倾向 B+树。
- 要点四:硬件是修正因子:HDD 放大 LSM 写优势,SSD 让读放大代价变小但写放大威胁变突出。
- 要点五:选型要看"代价账单"是否匹配业务,而不是比谁更快。
- 要点六:大量"键不存在"的查询场景下,LSM 的布隆过滤器是隐性优势。
读完本章你应该建立了 LevelDB 的宏观地图。下一章我们钻进它的内部,看哲学如何落成 MemTable、SSTable、Manifest 这些具体组件。