7.4 在线问题应急处置手册
7.4 在线问题应急处置手册
本节摘要:凌晨三点,值班手机响了:查询成功率跌到六成。这一刻你的每个动作都应该来自演练而不是灵感。本节是一张可以直接打印的处置卡片:四类高频事故——节点掉线、版本堆积、磁盘告急、查询雪崩——各自的分诊判据、标准动作序列、以及"什么情况下该升级而不是硬扛"。它把 7.2 的指标读法和 7.3 的兜底能力压缩成应激状态下的肌肉记忆。
卡片使用目标
阅读完本节,你应当能够:
- 用分诊决策树在五分钟内把一次告警归类到四大事故族;
- 按标准序列处置 BE 掉线并判断何时需要人工升级;
- 面对版本堆积告警执行"掐源头、加速消化、必要时锁定"三步处置;
- 区分"可以扛的雪崩"与"必须熔断的雪崩",并知道各自的开关在哪。
一、分诊总图:先把事故归族
应激状态下最危险的动作是"看到什么修什么"。正确姿势是先花五分钟归族——四类事故的症状、判据与处置方向完全不同,归错族就会南辕北辙:
| 事故族 | 典型症状 | 第一判据 | 处置方向 |
|---|---|---|---|
| 节点故障 | 查询报副本不可达、成功率跌 | 节点存活状态与心跳 | 隔离坏节点,让冗余顶上 |
| 版本堆积 | 导入变慢、合并积压分数爬升 | 积压分数与导入速率的比值 | 掐源头限速,加速消化 |
| 存储告急 | 磁盘水位告警、写入报错 | 各节点磁盘水位分布 | 清理与扩容,先保写入 |
| 查询雪崩 | 延迟全面抬升、连接数打满 | 异常查询的来源集中度 | 限流熔断,保护核心流量 |
归族的素材全部来自 7.2 的四象限面板与节点状态查询,不需要任何超出日常面板的信息。下面的分诊图值得贴在工位上。
图 7-4:告警响起后的五分钟分诊决策树
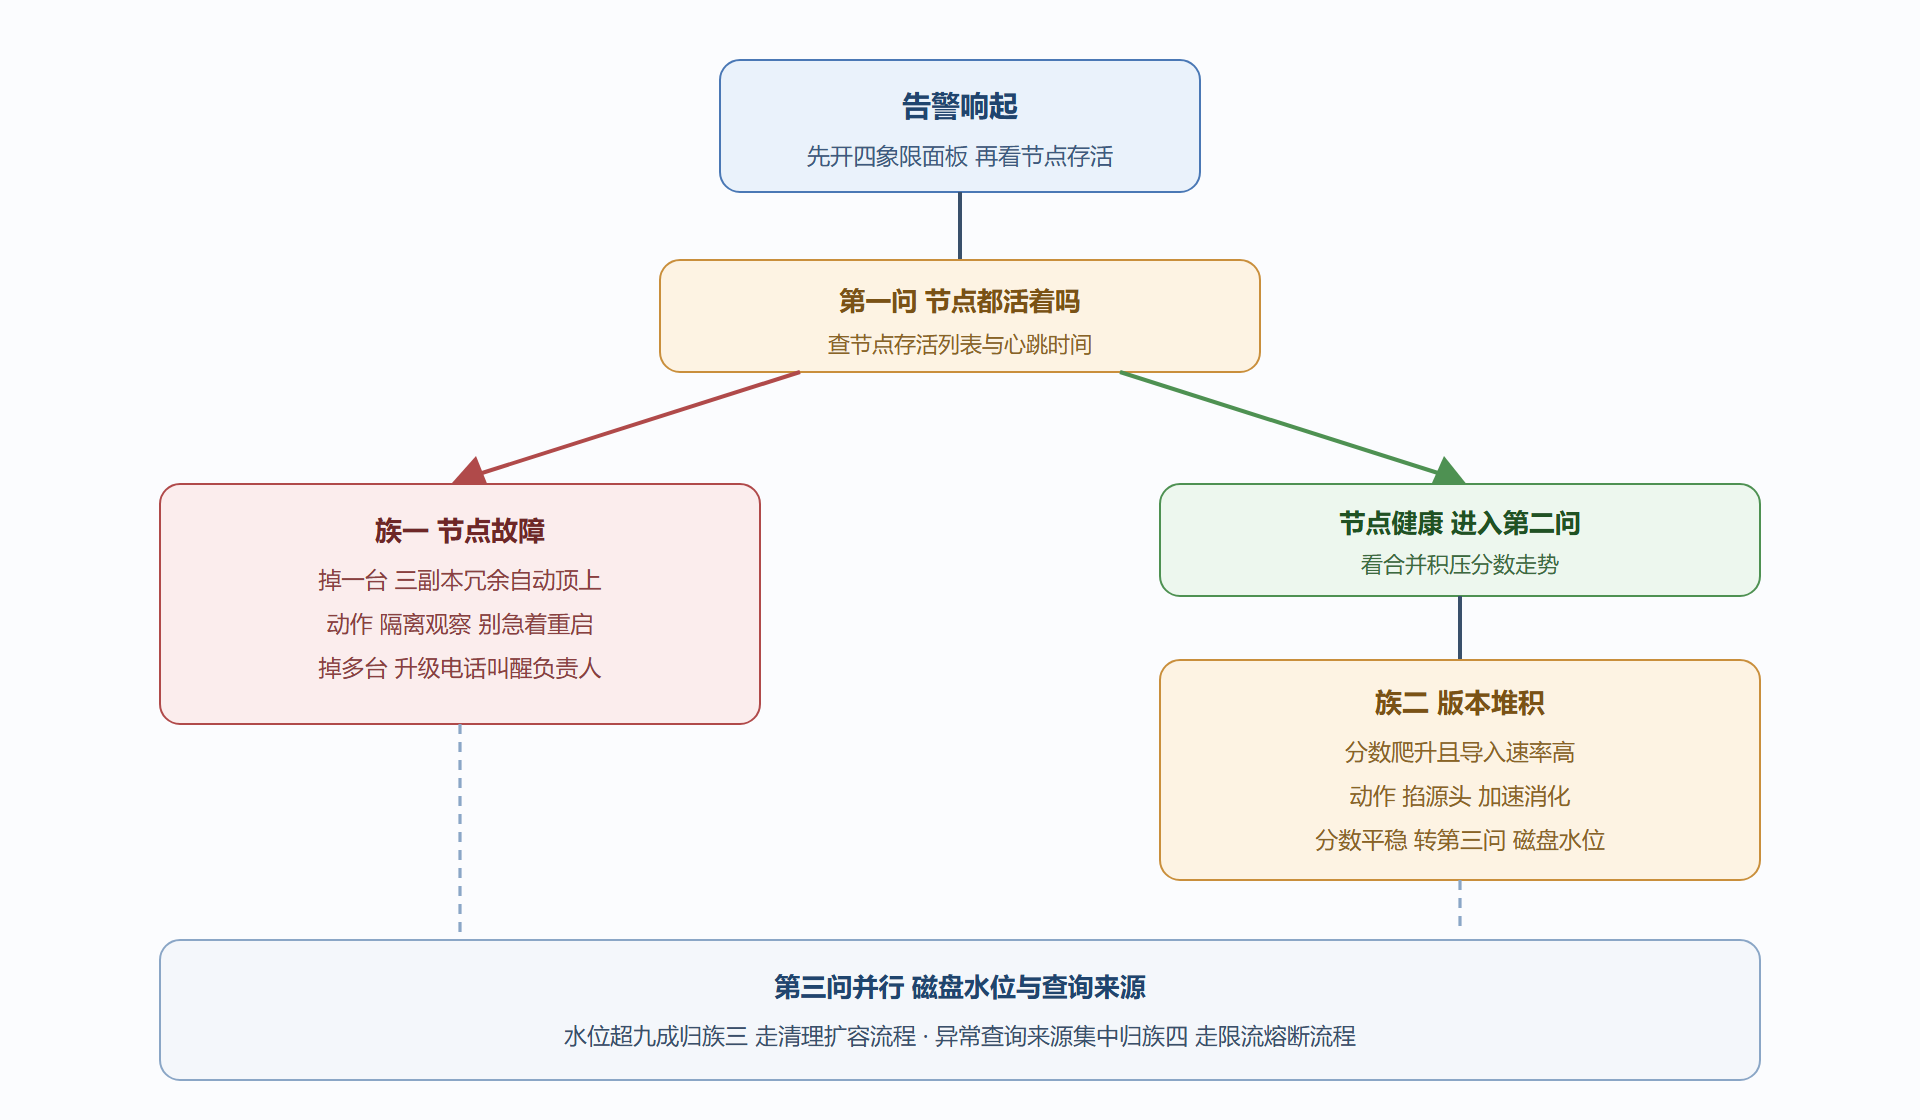
二、族一 节点掉线:隔离观察优先于重启
BE 掉线的标准序列分四步。第一步确认范围:查节点存活状态,一台还是多台、FE 还是 BE——单台 BE 掉线在三副本体系里理论上无感,多台同时掉是灾难场景,直接升级到负责人并停止一切写操作评估。第二步隔离观察:把故障节点标记为下线状态使其退出调度,让副本冗余自动补齐缺口;观察十分钟,若查询成功率恢复、补副本任务正常推进,说明数据冗余在正常工作。第三步再诊重启:单台节点的重启放到业务低峰,重启前先看它的系统日志末尾——是内存被系统杀掉、磁盘只读挂死、还是进程崩溃,三种根因对应完全不同的善后(前者要查内存配置,中者要查磁盘健康,后者才值得怀疑软件问题)。第四步复盘录入:把根因、处置时长、恢复后的副本补齐耗时记入事件库。
升级的红线要提前写死:同机架两台 BE 同时异常、任何一台 FE 失联、或副本补齐任务持续失败——这三种情况无论凌晨几点都打电话叫人,不要在值班群里等回复。宁可十次虚惊,不可一次独断。
-- 查看节点存活与副本状态 分诊第一步 SHOW BACKENDS; SHOW FRONTENDS; ADMIN SHOW REPLICA DISTRIBUTION FROM DATABASE dws;
三、族二 版本堆积:掐源头是唯一正解
版本堆积的机理在 4.4 排错实录里拆过:每批导入形成一个数据版本,合并速度跟不上版本产生速度时,堆积分数持续爬升,查询被迫做多路合并,最终全面变慢。处置的三步里,第一步也是唯一治本的一步是掐源头:找出堆积期间导入速率异常的表与任务,把并发与频率压回常态——多数堆积事故的源头是一个失控的补数任务或上游重试风暴。第二步加速消化:临时调高合并任务的线程配额与调度优先级,让积压以更快速度退潮;注意这会加剧 IO 争抢,执行前确认查询负载处于低谷。第三步是保底动作而非常规手段:对堆积最严重的表临时锁定导入,宁可数据延迟也不能让合并击穿内存红线——锁定要配合明确的解除条件与通知链,别让锁变成新事故。
判断何时该动手的标准:堆积分数随导入量同步波动且高峰后自然回落,是健康的动态平衡,不动;分数只涨不回落、或回落速度明显慢于历史,才进入处置。过度敏感的处置本身也是事故源——为一次自然回落暂停导入任务,制造的数据延迟同样会被投诉。
四、族三与族四:存储告急与查询雪崩
磁盘告急的处置按水位分档。九成以下是预警档:清理对象按收益排序——过期分区的删除(第 3 章动态分区机制的日常兑现)、回收站与临时表、快照残留;每一类清理都要先估收益再动手,避免"清理半天省出二十吉"。九成五以上是行动档:立即删除确认无用的分区与残留,同步评估紧急扩容——加盘或加节点,别在水位九成八时还幻想靠清理续命,写入失败只在一瞬间。
查询雪崩的分水岭是来源集中度。来源分散的全面变慢(所有业务都慢),大概率是集群级根因——磁盘、网络、合并挤压,回族一族的排查路径;来源集中的雪崩(某个新上线应用的连接数打满、某条失控循环查询反复提交),处置是外科手术式的:定位来源账号与应用,先限流后沟通,必要时临时禁用该账号——这是唯一的"熔断"场景,动作要快,事后解释要有审计日志撑腰。两个方向的处置开关完全不同,分诊时务必先看来源分布再动手。
五、把手册变成团队的
最后一步与本节同样重要:这份手册只有变成"你们的"才有价值。落地三件事:把分诊图与四族动作序列做成值班卡片,贴群公告与工位双份;每季度拿一次历史事件做桌面推演——读题、口述处置序列、对照手册找差距;每次真实事件后二十四小时内做"手册偏差复盘",实际处置与手册不一致的地方,要么改手册、要么改动作,绝不允许"当时看情况随机应变"成为长期状态。应急处置的成熟度不在手册厚度,而在最后一次真实告警时,值班同学翻没翻手册。
六、升级的时机与话术
手册没写全的情况一定会出现,此时唯一正确的动作是升级而不是硬扛——但要升得专业。升级的信息包要一次给全:现象一句话(哪个象限、什么指标、何时开始)、已排除项(按分诊树走过哪些分支)、当前证据(截图或日志摘录)、已做动作与结果。这四样凑齐,接手的负责人五分钟就能进入状态;缺了任何一样,升级就退化成"你来看看"的现场交接,双方一起在黑暗里摸索。
升级后的分工也要明确:值班同学继续按手册做无损动作(采集证据、保守限流),结构性变更(重启节点、切换流量、回滚版本)由升级对象决策。这条边界的意义在于保护双方——值班同学不为超出手册的后果背锅,负责人也不会回到岗位时发现集群已被善意但仓促的操作改得面目全非。
常见疑问
问:手册覆盖不了的新症状怎么积累进手册? 每次真实事件后二十四小时内的复盘会承担这个职能:把新症状按四族的判据格式补写进对应小节(现象、第一判据、动作序列、预防条款),与原手册同等格式。半年不更新的手册是摆设,更新频率本身就是手册生命力的体检指标。
问:演练和真实事件的最大差距在哪? 在信息噪音。演练时四象限面板干净、指标曲线清晰;真实事件的凌晨三点,你可能面对的是告警风暴、过期面板和一半失联的监控。所以桌面推演要刻意加入噪音训练——给一条模糊线索、让一半面板"坏掉",逼值班同学先重建观测再动手。能在噪音里走完分诊树,才算真的会。
本节要点回顾
- 先归族再动手:四族事故判据不同,归错族比不处置更糟。
- 掉线先隔离观察:三副本冗余在干活时,重启是第二选择。
- 堆积掐源头:限速上游是唯一治本,锁定导入是保底非常规手段。
- 磁盘按水位分档:九成五以上立即行动,别赌清理速度。
- 雪崩看来源集中度:来源集中才熔断,全面变慢回集群级排查。
线上防线布防完毕。最后一章走出机房:Doris 如何接入整个数据生态,又如何在行业场景里兑现价值。