7.3 备份恢复与灾备演练
7.3 备份恢复与灾备演练
本节摘要:先讲一段行业里反复发生的事故:某团队的分析师把生产库当成测试库,一条不带分区过滤的删除语句清空了一张两亿行的核心表——团队这才发现他们的"备份"是半年前的一次手工导出。本节讲怎么让这种故事在你这里无法发生:快照的版本语义、一套恢复演练的完整记录、以及跨集群准多活的搭建账本。
学习目标
阅读完本节,你应当能够:
- 解释快照如何在不阻塞写入的前提下锚定一致的数据版本;
- 建立仓库快照策略并为核心表设定量化的 RPO 与 RTO 目标;
- 完整执行一次恢复演练并产出验收报告;
- 评估是否需要以及如何搭建跨集群的准多活灾备。
一、从一次误删说起:备份的第一问不是怎么备
事故复盘时最刺心的发现往往不是"没备份",而是"备了但不敢用":导出文件躺在对象存储里,格式是半年前的旧表结构,恢复一次要人工重建表、重放数据、核对口径,预估要一天——业务等不起,最后靠从上游源系统重新回刷三天数据才补齐。这个案例立起备份设计的第一问:你备份的到底是"数据文件",还是"一份随时可验、可信恢复的能力"? 前者人人都有,后者需要机制。
Doris 的快照机制给了这个能力以工程基础。快照不是物理文件的拷贝,而是对某个全局一致数据版本的元数据锚定:发起备份的时刻,系统记下当前已提交事务的版本边界,之后的读取与导出严格基于这个边界——源表继续写入完全不受影响,备份读到的永远是发起时刻的确定状态。这套"写不停、备一致"的语义让备份可以放进业务时间执行,不必再抢深夜窗口。配合增量策略——首次全量、后续只记录变化部分——存储开销与备份时长都被压到日常可承受的水平。
-- 仓库级快照 定期归档核心库 BACKUP SNAPSHOT repo_daily.snap_20260828 ON DATABASE dws PROPERTIES ("type" = "incremental"); -- 按分区粒度恢复 误删场景的精确抢救 RESTORE SNAPSHOT repo_daily.snap_20260827 ON DATABASE dws TABLE fact_sales PARTITION (p20260827, p20260826) PROPERTIES ("backup_timestamp" = "对应时间戳", "meta_version" = "对应元数据版本", "reserve_replica" = "true");
二、一次恢复演练的完整记录
备份的价值只在演练里兑现。下面是一次按季度执行的演练记录,可直接当模板抄。
背景:核心库三张事实表、两张维表,日增合计约两千万行,快照策略为每日凌晨增量归档到远端仓库。演练目标:随机选定一个分区子集,从两天前的快照恢复,要求业务无感知、总时长两小时内。
操作:先在测试环境执行完整流程——创建恢复任务、监控分片下载与校验进度、验证表结构与行数、抽样比对聚合口径;测试环境跑通后,在生产只读时段对演练分区执行同样的恢复。关键控制点有三处:恢复前用快照的元数据核对目标分区清单,防止恢复错版本;恢复过程中监控集群网络水位,避免与晚高峰导入叠加;恢复后立即跑一组口径核对查询,与源表同分区的聚合值逐项对账。
结果:测试环境全程五十分钟,生产环境三十八分钟,行数与聚合口径全部对平,演练期间在线查询 P99 无可见抖动。演练报告归档,包含时间线、控制点检查表与两处改进项(快照元数据的核对脚本自动化、口径核对查询预存为固定模板)。
解读:这次演练真正买到的不是"恢复成功了"这个结论,而是三样东西——经过验证的 RTO 数字(四十分钟量级,远优于业务承诺的四小时)、一套写下来就能执行的步骤手册、以及团队里至少两个人亲手按过恢复键。事故夜晚最贵的成本是"没人在最近半年里真的做过这件事",演练就是把这个成本从夜里挪到白天。
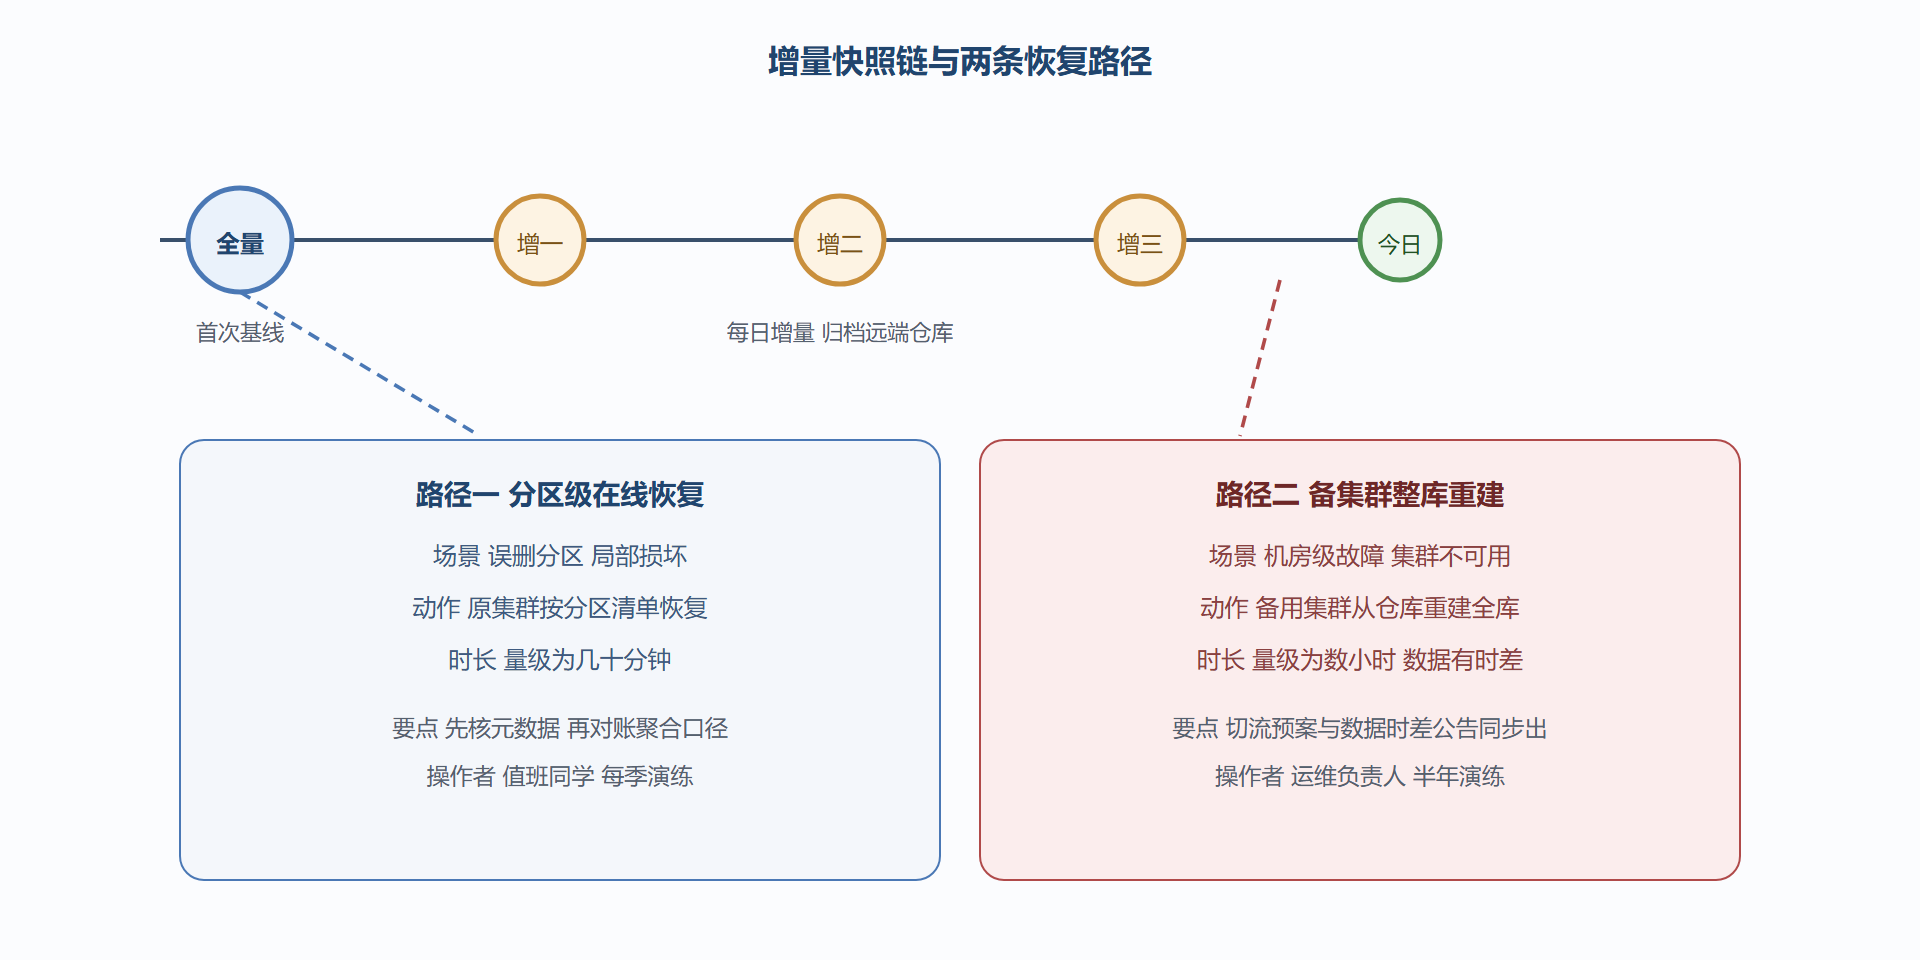
变式:误删单分区走上面的小粒度恢复;整库级灾难(机房故障)则跳过在线恢复,直接在备用集群从远端仓库重建——两条路径都要在演练计划里,因为它们的操作者、耗时与验收标准完全不同。第三种变式是"恢复到临时表先验证",对来路不明的快照或跨版本恢复,先落在临时命名空间核对无误再切换,多一步保险。
图 7-3:一条快照链与两条恢复路径
三、跨集群:准多活的账本
单集群快照解决"数据坏了怎么办",跨集群架构回答"机房没了怎么办"。双集群的常见形态是准多活:主集群承载写入与核心查询,灾备集群日常承接只读流量(报表、审计类分析),两者之间按快照节奏同步——灾备集群永远明确知道自己截至哪个版本。它不是冷备(资源在干活,切换有底子),也不是真多活(双写与冲突解决超出当前能力边界),这个"温"字头的定位恰恰是成本与韧性的平衡点。
搭建账本要算三笔。时差账:同步节奏决定灾备集群的数据滞后量,每小时一轮快照意味着切换时最多丢一小时数据——这个数字必须让业务方书面确认,RPO 是业务决策不是技术决策。切换账:切换动作包括改连接串、验证只读流量、公告数据时差,演练过的团队可以压到十分钟量级;没演练过的,光"找齐所有连接串"就能耗掉一小时。成本账:灾备集群日常承接只读流量,硬件利用率不再是纯闲置的冷备,两套集群的总成本换来的是机房级故障的业务连续性——值不值,取决于业务停一小时的价格。
四、把演练变成制度
备份体系最终的评价标准只有一条:真出事时,恢复动作是否像演练过一样流畅。制度化的做法是两级演练节奏——分区级恢复演练每季度一轮,随机抽表、按手册执行、出验收报告;机房级切换演练每半年一轮,选业务低峰把只读流量真实切到灾备集群运行一天再切回。每轮演练的改进项回写手册,手册版本号与快照策略版本号一起管理。检查一个团队的灾备水平,别看文档写得多厚,问三个问题就够:最近一次演练是什么时候、RTO 的实测数字是多少、谁亲手按过恢复键。
常见疑问
问:快照频率越高越好吗? 不是无级变速箱,是成本函数:快照越密,RPO 越小,但远端仓库的存储增量与元数据管理开销同步上升。按数据变更率分表设频——高频变更的事实表每小时一轮,低频维表每日一轮——比全局统一频率省钱且更贴业务。频率的最终批准权在业务方,因为 RPO 是业务承诺。
问:恢复演练会干扰生产吗? 分区级演练可以做到零干扰:在测试环境全流程执行,生产侧只做口径核对查询。机房级切换演练确实要动真实流量,所以才安排半年一轮并选业务低峰——不是"要不要付干扰成本"的问题,而是"现在付小钱还是事故夜付大钱"的问题。
本节要点回顾
- 备份的是能力不是文件:可验证、可执行、有人会按,三者齐备才叫有备份。
- 快照锚定版本边界:写不停、备一致,备份可以放进业务时间。
- 演练买三样东西:实测 RTO、成文手册、按过键的人。
- 准多活算三笔账:时差、切换、成本,RPO 是业务决策。
- 两级演练节奏:分区级季练、机房级半年练,改进项回写手册。
防线再稳也有漏网之时——下一节直接摊开值班卡片:四类高频事故的分诊决策树与标准动作。