1.3 四引擎同台:Selenium与Playwright、Cypress、Puppeteer选型
1.3 四引擎同台:Selenium与Playwright、Cypress、Puppeteer选型
本节摘要:Selenium、Playwright、Cypress、Puppeteer 四个引擎的差异源于架构出身:Selenium 走标准协议驱动任意浏览器、语言无关、生态最老牌;Playwright 用自动等待与现代调试换来了新项目的开发体验;Cypress 把测试塞进浏览器内部运行、上手快但绑定 JavaScript 且多标签页能力弱;Puppeteer 是 Chromium 系的原生控制刀,浏览器覆盖窄。本节给出一套"架构出身 → 能力差异 → 团队匹配"的选型路径,把第 1.2 节的边界判断延伸到"选哪个引擎"的落地决策。
先用行话定调:你在选的不是工具,是生态位
工程圈聊选型常讲一个词:生态位。一个工具的生态位由三件事锁定——它驱动浏览器的架构方式、它服务的语言社区、它被验证过的年份。四个引擎的生态位几乎没有重叠,所以"谁取代谁"是个伪问题,真问题是"你的项目落在哪个生态位里"。
Playwright 出身于微软,架构上继承了 WebDriver"进程外驱动"的思路,但改用浏览器私有协议直连,绕开了标准协议的历史包袱,换来开箱即用的自动等待、网络拦截与多标签页管理;官方语言绑定覆盖 JavaScript、Python、Java 与 .NET。Cypress 出身于前端测试社区,思路最激进:测试代码直接跑在浏览器内部,与页面同进程,因此调试体验、时间旅行式的快照回看极好,代价是只能用 JavaScript 编写,且受同源进程模型限制,多标签、多域场景先天吃力。Puppeteer 出身于 Google,最初为 Chrome DevTools 的自动化而生,对 Chromium 系控制得最细腻,常用于爬取、生成页面快照,但 Firefox 与 Safari 的支持长期是短板。Selenium 则是四者中唯一以 W3C 标准为契约的引擎,任何语言、任何遵循标准的浏览器都能接入,代价是上层体验的现代化程度不如新引擎。
一张表看懂能力差异
| 维度 | Selenium | Playwright | Cypress | Puppeteer |
|---|---|---|---|---|
| 驱动架构 | W3C 标准协议,进程外 | 私有协议直连,进程外 | 浏览器内运行 | DevTools 协议 |
| 语言支持 | Python、Java、C#、Ruby、JS 等全生态 | JS、Python、Java、.NET | 仅 JavaScript | 主推 JavaScript |
| 浏览器覆盖 | Chrome、Firefox、Safari、Edge 等 | Chromium、Firefox、WebKit | 以 Chromium 为主 | Chromium 系 |
| 自动等待 | 需自行设计等待策略 | 内置自动等待 | 内置命令重试 | 需自行设计 |
| 多标签多窗口 | 完整支持 | 完整支持 | 支持受限 | 支持良好 |
| 并行与分布式 | Grid 成熟体系 | 原生 worker 并行 | 付费或自建 | 需自建 |
| 调试体验 | 依赖日志与截图 | 追踪回放、网络面板 | 时间旅行快照 | DevTools 级 |
| 生态年份 | 二十年以上 | 2020 年起 | 2017 年起 | 2017 年起 |
表格是静态快照,读它的正确姿势是横着看短板:Selenium 的短板在上层体验——等待要自己管、调试要自己配;Playwright 的短板在生态年限——社区沉淀与企业级案例还在积累;Cypress 的短板在语言与场景约束——跨域旅程、多窗口流程天然别扭;Puppeteer 的短板在浏览器覆盖——Firefox、Safari 场景别勉强。
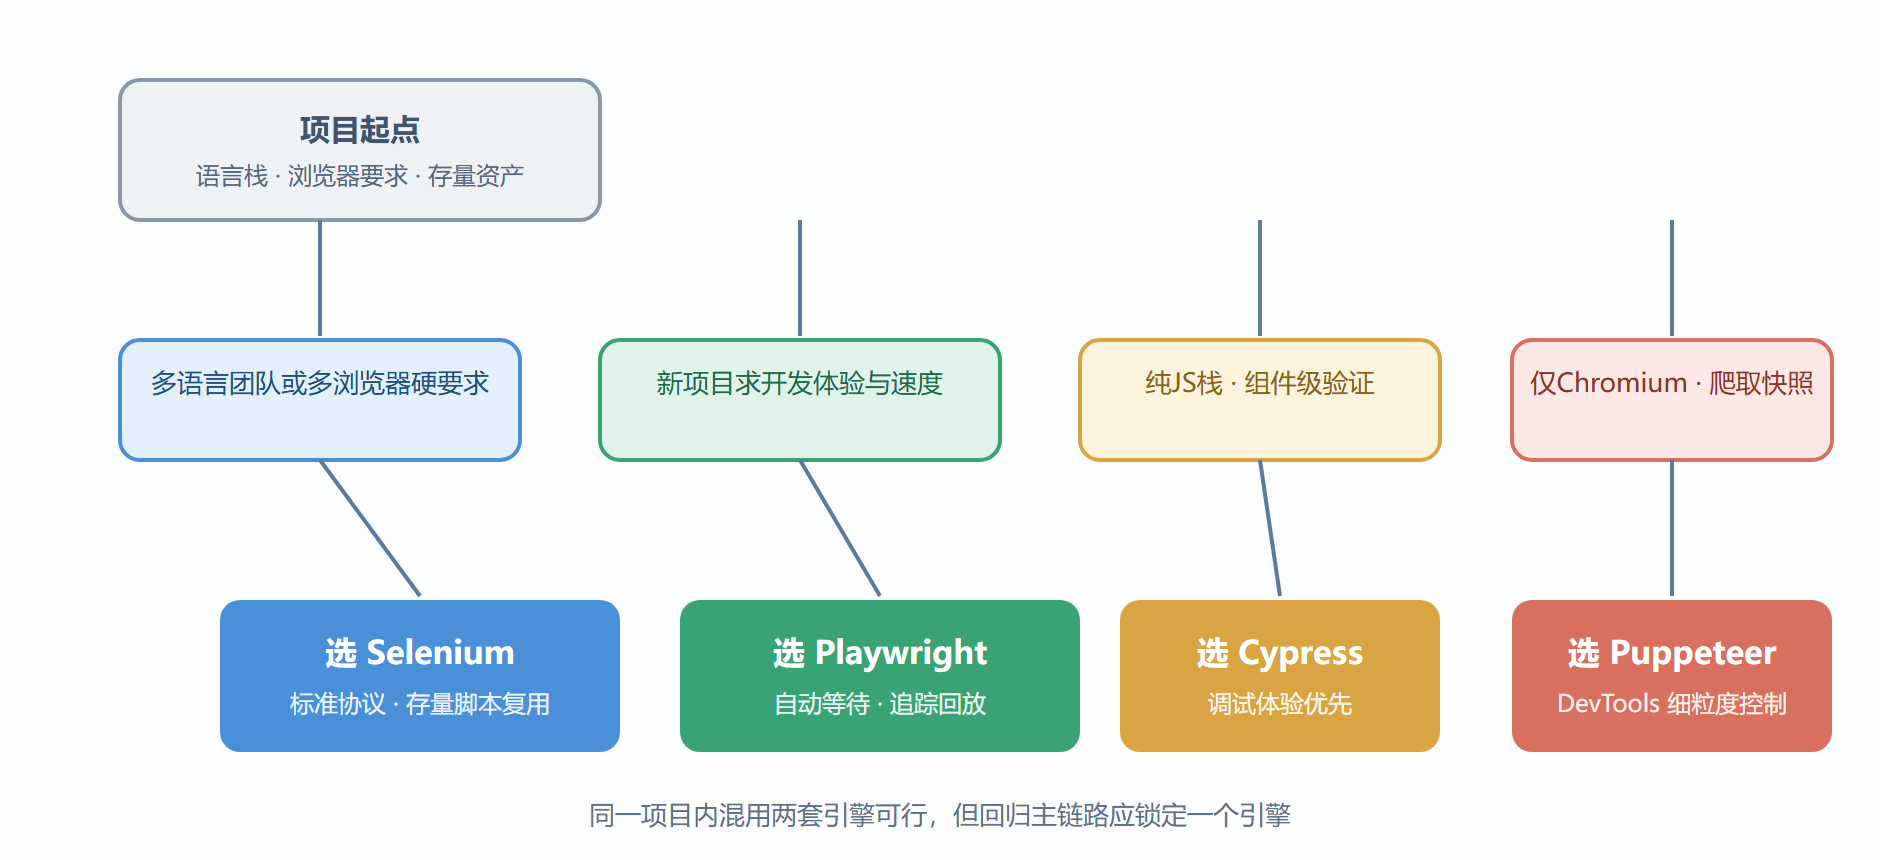
图1-3 四引擎选型决策路径
同一件事,四种说法
选型最终要落到团队日常写的代码上。看同一个操作——"打开登录页、填入账号密码、点击提交"——在三种引擎里的写法差异,比任何评测文章都直观。先是 Selenium 的 Python 写法,等待需要显式声明:
from selenium import webdriver from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC driver = webdriver.Chrome() wait = WebDriverWait(driver, 10) driver.get("https://example.example.com/login") wait.until(EC.visibility_of_element_located((By.ID, "username"))).send_keys("qa_user") driver.find_element(By.ID, "password").send_keys("secret") driver.find_element(By.ID, "login-btn").click()
同样的动作,Playwright 的 Python 写法把等待藏进了每次操作里,代码里看不到任何显式等待:
from playwright.sync_api import sync_playwright with sync_playwright() as p: browser = p.chromium.launch() page = browser.new_page() page.goto("https://example.example.com/login") page.fill("#username", "qa_user") page.fill("#password", "secret") page.click("#login-btn")
两段代码的差别不在语法糖,而在哲学:Selenium 把"页面什么时候就绪"这个问题明明白白交给你,逼你理解渲染时序(第 3 章 3.3 整节都在讲这个);Playwright 把它接管了,代价是出问题时你需要理解它内置等待的边界条件。团队里有人愿意吃透机制,选哪个都顺;团队想少操心机制,新引擎的开发体验确实占优。
选型决策的三个建议
建议一:以存量资产为重。 已有几百条稳定运行的 Selenium 用例,换引擎意味着重写、重训、重搭流水线,除非存量套件本身已经腐烂到重写比修复便宜,否则不动。建议二:以团队语言为锚。 团队主力是 Java 或 Python 且要测全浏览器,Selenium 与 Playwright 都在候选池;团队是纯前端栈、测自家组件库,Cypress 顺理成章。建议三:以浏览器覆盖为底线。 明确要求 Safari 支持的项目,Cypress 与 Puppeteer 直接出局,剩下的在 Selenium 与 Playwright 里按体验与生态权衡——很多成熟团队的实际答案是双轨:新模块用新引擎快速覆盖,历史回归仍由 Selenium 套件守护。
收工清单
- 生态位决定论:四个引擎因架构出身不同而几乎不重叠,"谁取代谁"是伪问题,匹配才是真问题。
- 记忆锚点:Selenium 拼标准与全语言,Playwright 拼体验与自动等待,Cypress 拼浏览器内调试但绑定 JS,Puppeteer 拼 Chromium 细粒度控制。
- 代码即哲学:显式等待写不写进代码,暴露的是"谁对渲染时序负责"这一根本分歧。
- 三建议:存量资产为重、团队语言为锚、浏览器覆盖为底线。
至此第 1 章的三问有了答案。下一章我们把镜头拉近:拆开 Selenium 的三层架构,看清一次点击从代码到浏览器内部到底经过了什么。