5.3 显存账本:权重、KV 缓存与计算缓冲三本账
5.3 显存账本:权重、KV 缓存与计算缓冲三本账
本节摘要:显存不足的报错九成源于只算了一本账。显存里同时住着三户人家:权重(大头但固定)、KV 缓存(随窗口线性增长)、计算缓冲(随批次与窗口波动),外加一笔驱动开销的隐形房租。本节给出三本账的精确算法与对账方法,让你在下一次运行前就知道「这个配置塞不塞得下」。
为什么账要算在三处
新手的心智模型里显存里只有模型。于是 4.7GB 的文件塞进 6GB 显卡理应从容,结果两千 token 窗口一起就爆。真相是权重只占六到七成,剩下的空间被推理过程的「活账本」分走:模型读过的每个 token 都要留下中间状态(KV 缓存),每轮计算还要工作台面(计算缓冲),驱动与运行时还要抽一笔固定开销。三本账各有一个旋钮:权重看位宽,KV 缓存看窗口,计算缓冲看批次。调参的本质就是在这三本账之间分配空间。
一、第一本:权重账
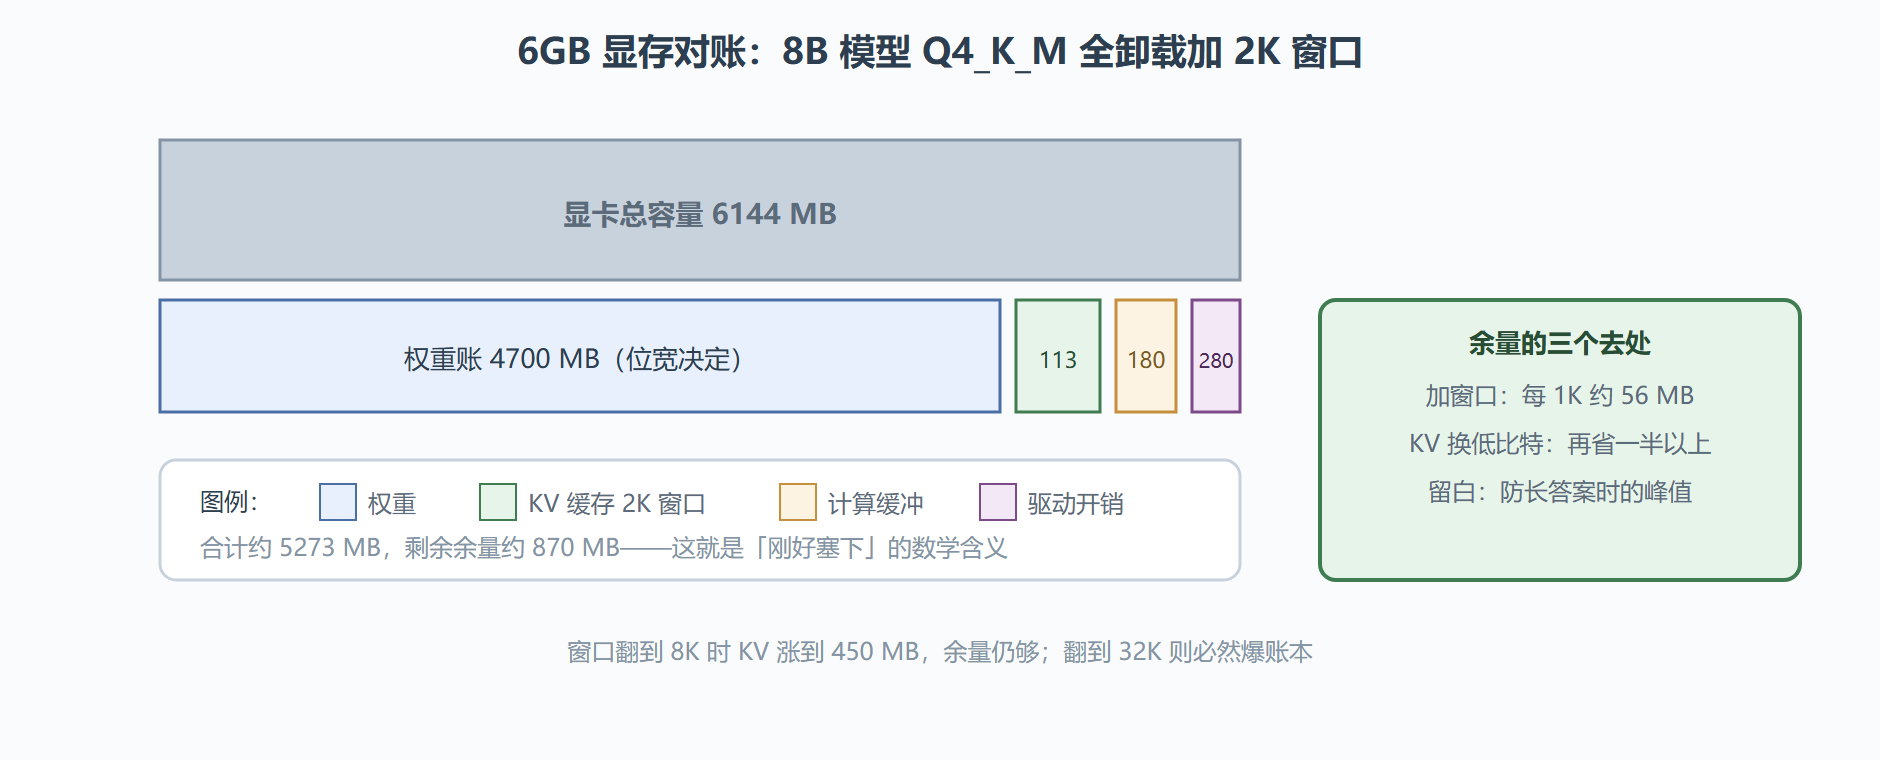
权重账最简单,就是文件大小——GGUF 加载即映射,权重占用的显存约等于文件体积。Q4_K_M 的 8B 模型约 4.7GB,Q3 档约 3.9GB,以此类推(心算公式见 1.2 节)。启动日志里这行就是账本实数:
load_tensors: CUDA0 model buffer size = 4700.00 MiB
二、第二本:KV 缓存账
每个 token 在每层都要留下两份向量(K 与 V),总量由架构与窗口决定:
KV 缓存 ≈ 2 × 层数 × KV维度 × 窗口token数 × 每元素字节 Qwen2.5-7B:28 层,KV 维度 512(分组注意力,4 头 × 128 维),16 位存储 每个 token 的缓存 = 2 × 28 × 512 × 2 字节 ≈ 56 KB 窗口 2048:约 112 MB 窗口 8192:约 450 MB 窗口 32768:约 1.8 GB
分组注意力(GQA)是这里的关键变量:现代模型用少量 KV 头服务多个查询头,KV 维度远小于隐藏维度,缓存压力比老架构低一个数量级——同样的窗口,新模型就是比老模型省。账本实数在日志里同样可查:
llama_kv_cache: KV self size = 112.50 MiB
三、第三本:计算缓冲账与隐形房租
计算缓冲是每轮矩阵乘的工作台面,大小随批次与窗口变化,架构不同差异也大,量级在一两百 MB 到近 GB 之间。它无法精确预算,但可以从日志读出:
CUDA0 compute buffer size = 180.00 MiB
预算时按两三百 MB 预留是稳妥的。除此之外还有一笔日志里查不到的驱动与运行时开销:Windows 上 CUDA 上下文加驱动常驻约 250 到 300MB,Linux 略低。这笔房租不随你的参数变化,但预算必须给它留位。
图 5-3 6GB 显卡的显存账本:一次全卸载配置的对账
四、对账实操:一次完整的预算演算
把三本账装进一个十行的小计算器,任何「模型加窗口」组合运行前都能先算一遍:
def vram_budget(file_gib, layers, kv_dim, ctx, f16_kv=True): weights = file_gib * 1024 per_token = 2 * layers * kv_dim * (2 if f16_kv else 1) / 1024 # KB kv = per_token * ctx / 1024 # MB compute, driver = 200, 280 total = weights + kv + compute + driver print(f"权重 {weights:.0f} + KV {kv:.0f} + 缓冲 {compute} + 驱动 {driver} = {total:.0f} MB") vram_budget(4.7, 28, 512, 2048) # 约 5273 MB:6GB 卡的安全线内 vram_budget(4.7, 28, 512, 8192) # 约 5610 MB:贴线,有爆账风险 vram_budget(3.9, 28, 512, 8192) # 约 4810 MB:Q3 档换大窗口,从容
演算结论与前两节完全自洽:这台机器上 Q4_K_M 配 2K 窗口是舒适区,8K 窗口贴线赌运气,想上大窗口就退 Q3 档(或等第 6 章的 KV 量化救场)。
五、常见问题
日志里的 buffer size 加起来比实际占用小,差额去哪了?
驱动开销、显存碎片与驱动自身的缓存都藏在这部分差额里。对账时把「日志可查三项之和」乘以 1.1 再与卡容量比较,是更接近现实的口径。
计算缓冲为什么每次运行都不一样?
它跟实际请求的批次、提示长度有关。预算按你日常最长的提示词估,别按空载状态估——空载时省下的账,长请求一来就连本带利还回去。
显存爆了会怎样?
好情况是程序报分配失败退出;坏情况是驱动把显存换页到内存,速度断崖式下跌还带着系统卡顿。宁可用预算公式提前算,不要靠报错当预算工具。
扩展账本:一台机器多个模型
账本方法还能回答一个编排问题:这台机器能同时驻留几个模型?算法与三本账相同,只是把「一个模型的三本账」换成「多个模型的权重账加各自峰值账」的组合。给出这台机器的实测结论:7B 的 Q4 主力加 0.5B 的 F16 冒烟件可以共存(合计约 5.2GB,贴线但可行);主力加嵌入模型的双常驻是更实用的组合(嵌入件几百 MB,第 8.3 节的本地检索就靠它)。编排纪律有两条:共存模型总数乘各自窗口额度的总账不得超卡;任何长驻模型都要为峰值留白,别把账算满。多模型常驻是「把工具箱装进显存」的玩法,账本清楚,玩法才稳。
账本思维的三条外延
三本账的算法是具体的,账本思维是通用的,它能外延到三处。外延一:买硬件——显卡的显存规格直接决定你的模型上限,按「目标模型位宽加窗口余量」倒推需要的容量,购物车里少花冤枉钱。外延二:读别人的配置——社区帖里的参数组合,用账本一算就知道对方是全卸载还是部分卸载、窗口给没给足,抄配置之前先验账。外延三:判断瓶颈——速度异常时先看是权重账超标(频繁换页)还是缓冲账超标(分配失败),两类症状、两种修法,账本直接给出排查方向。账本是本书出现的第一个「可迁移思维模型」,后面章节还会遇到它的变体。
常见问题
日志里的缓冲大小为什么随窗口变化?
计算缓冲的一部分与上下文长度线性相关(注意力中间值的暂存区),窗口翻倍它也水涨船高。预算脚本里的「两三百 MB」是 4K 内窗口的经验值,上 16K 后请按日志实测修正。
KV 缓存能不能放内存、只把权重放显存?
支持这种分层形态,适合「大窗口加小显存」的组合。代价是注意力计算要跨总线读缓存,生成速度明显受损——它是「装得下」与「跑得快」之间的又一个权衡点,窗口需求刚性时可用。
怎么知道一台陌生机器的可用显存口径?
标注容量减去系统占用才可用:Windows 桌面环境给系统留 700MB 到 1GB 是常态。实操先用一个超小模型把卡占满试探,读出实际可用值,再用这个数做后续预算的基数——比查规格表更接近真实。
本节要点回顾
- 三本账加一笔房租:权重看位宽、KV 看窗口、缓冲看批次、驱动开销固定留两三百 MB;
- KV 缓存公式:2 乘层数乘 KV 维度乘窗口,GQA 让现代模型每 token 只摊几十 KB;
- 对账以日志为实数、以公式为预算,两者互为校验;
- 余量的优先级:KV 低比特化最划算,其次扩窗口,永远留一点防峰值;
- 权益分配想通了,下一节把视野放宽到 N 卡之外的世界。