1.4 三大推理运行时选型对比
1.4 三大推理运行时选型对比
本节摘要:OpenVINO、TensorRT、ONNX Runtime 是当前最常见的三个推理运行时。本节按硬件版图、性能上限、转换链路、工程成本四个维度做正面对比,给出可操作的选型决策树,并说明三者组合使用的常见形态——它们不是三选一的死敌,更像三种可拼接的工具。
上一节摸清了硬件,现在回答全章最实际的问题:下一个项目到底押哪个运行时。我们的立场先摆出来:这个问题没有脱离硬件存量的答案。同一份模型、同一个延迟目标,在不同硬件版图下的正确选择完全不同。本节给的是判断框架,不是标准答案。
一、三个候选,三种出身
先认识对手。TensorRT 是 NVIDIA 的推理加速器,深度绑定自家 GPU:性能上限在三类里最高,代价是模型要先转成引擎再针对具体显卡编译,跨设备迁移需重新构建,闭源也让排错依赖官方支持。它适合算力采购以 NVIDIA 为主、追求极致吞吐、且设备型号相对固定的团队。
ONNX Runtime 是微软主导的跨平台引擎,生来就讲 ONNX 这门通用语。它的最大特色是执行提供者(EP)机制——CUDA、TensorRT、DirectML 甚至 OpenVINO 本身都可以作为后端挂载进来。性能通常不及原生深度调优的后端,但「一份模型处处能跑」的工程便利让它成为很多团队的默认起点。
OpenVINO 前两节已经介绍:以 IR 为中心,在英特尔硬件上优化最深,量化与性能分析工具链完整,AUTO 调度把多设备选择自动化。它的短板同样明确——出了英特尔硬件圈,算子覆盖与性能优势都要打折扣。
二、四维正面对比
| 维度 | OpenVINO | TensorRT | ONNX Runtime |
|---|---|---|---|
| 硬件版图 | 英特尔 CPU、核显、Arc、NPU 最深 | NVIDIA GPU 专属 | 跨平台最广,性能取决于所选后端 |
| 性能上限 | 英特尔硬件上接近极限 | NVIDIA GPU 上三类最高 | 通用路径中等,挂 TensorRT EP 后接近上限 |
| 转换链路 | ovc 转 IR,支持 ONNX 与 PyTorch 直读 | ONNX 转引擎并按设备编译 | 直接吃 ONNX,无需转换 |
| 量化工具 | NNCF 一条龙,校准到部署闭环 | 自带量化工具,侧重 GPU | 配套量化工具,深度学习类后端各有差异 |
| 多设备调度 | AUTO、MULTI、HETERO 内置 | 单设备为主,多卡靠系统层 | 依赖 EP 组合,粒度较粗 |
| 语言栈 | Python、C++ 一等公民,另有多语言绑定 | C++ 与 Python | Python 与 C++ 为主,移动端有专属包 |
| 排错透明度 | 性能计数器与洞察报告开源可查 | 闭源,依赖官方文档与支持 | 开源,EP 层问题需进对应后端排查 |
表格里最容易被忽略的是最后一行。部署是长期运维,出了问题能不能查,比跑分高低更影响总成本。我们见过团队为了基准测试里两个百分点的差距选了闭源方案,上线后遇到算子级性能问题,排错手段只剩升级版本和提交工单——这笔账在选型时就应该算进去。
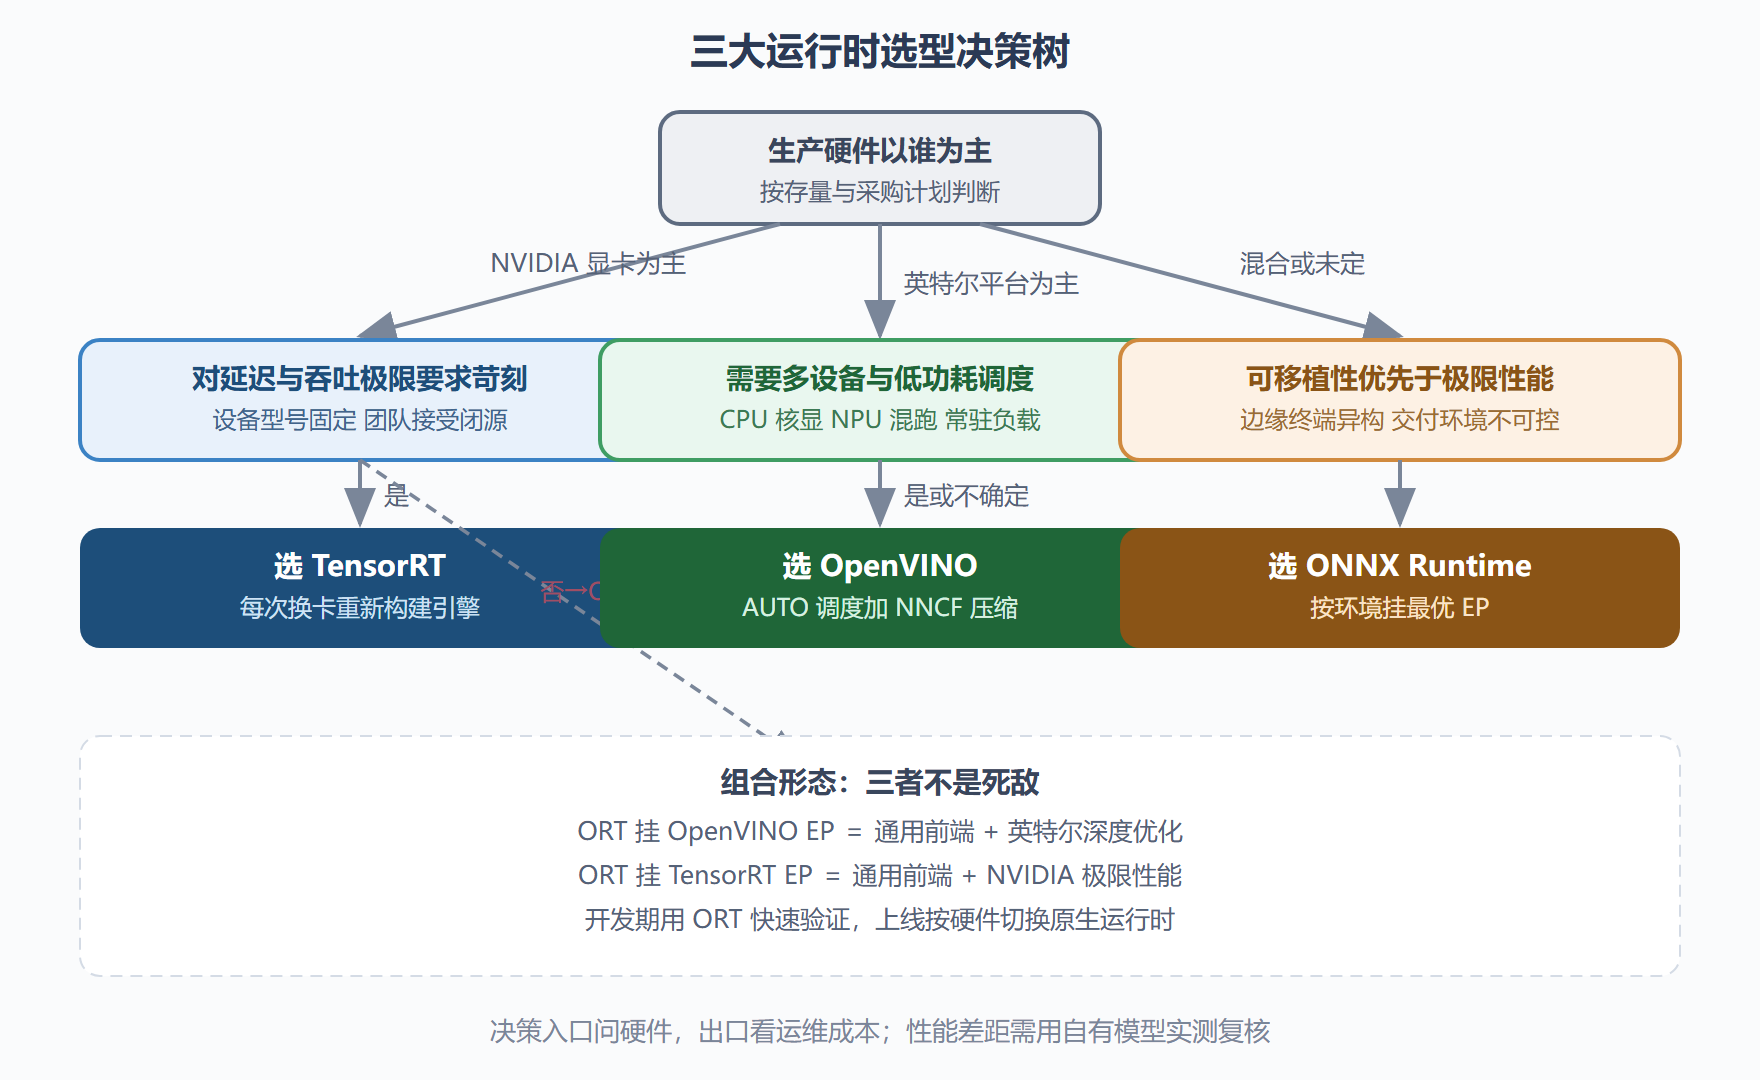
图 1-3 运行时选型决策树
三、组合使用:常见而不张扬的形态
实战里三类运行时经常同框。最常见的组合是 ONNX Runtime 挂 OpenVINO EP:模型管理与分发光由 ORT 承担,落到英特尔硬件上的算子交给 OpenVINO 执行。另一种是开发期用 ORT 快速搭原型,验证可行性后再按上线硬件迁移到原生运行时。还有团队在服务端用 TensorRT 跑大算力的视觉主干,边缘端用 OpenVINO 跑核显与 NPU——同一条业务链,两端各自选了最合适的执行器。
组合的代价是两套栈的版本协同与排错链路变长。判断要不要组合,用一个问题就够:你的性能瓶颈是否真的在推理执行上?第 7 章的性能分析会给出度量方法。很多时候瓶颈在预处理或数据搬运,此时换运行时的收益接近于零,先把流水线测明白再选边。
一个选型复盘:三条路都试过的项目
用一段真实的选型复盘把框架变成动作。某零售分析团队要做货架识别,存量硬件是五十台混合机型——六成是带核显的英特尔迷你主机,四成是老旧的第三方迷你 PC,另有一台训练用工作站带 NVIDIA 显卡。项目组的选型走了完整三步。
第一步明确约束:边缘设备离线运行、单机预算为零(利用存量)、延迟要求宽松(秒级可接受)。第二步按决策树走:混合存量且未定,ONNX Runtime 兜底是纸面答案。他们确实先用 ORT 把原型跑通,两周完成可行性验证——这一步的判断完全正确。第三步出现转折:实测发现同型号机器上 ORT 的 CPU 路径比 OpenVINO 慢约四成,而机型存量六成是英特尔平台。团队最终按机型分流:英特尔机型编译到 OpenVINO 运行时,其余机型保留 ORT,模型文件两侧通用(都是 ONNX/IR 同源),运维复杂度被模型格式统一压住了。
复盘的三条经验值得抄走:原型期的兜底选择不会白费——即使最后分流,原型期的接口设计完整保留;性能差异要用自己的模型测——「慢四成」是他们拿自己的检测模型实测出来的,任何公开跑分都替代不了;分流的成本靠统一模型格式控制——真正贵的不是两套运行时,是两套模型维护线。
评测基准怎么做才公平
既然「实测」这么关键,就补一节怎么做一次站得住脚的运行时评测。四条纪律:同一份模型——各运行时走各自的转换链,但来源必须是同一份原始模型,转换过程记录在案;同一台机器——轮换运行时而不是轮换机器,环境变量里记录供电、散热与后台负载状态;同一种调用姿势——同步对同步、异步对异步、性能提示对齐,用默认配置对比默认配置,用调优后对比调优后,混着比得出的结论一文不值;业务指标优先——对比「每秒处理多少帧真实业务请求」而不是「单次推理的微秒差异」,后者往往落在测量噪声里。
评测报告的落款要附环境快照:系统版本、驱动版本、运行时版本、供电状态。三个月后有人质疑结论时,这些快照是唯一能自证清白的东西。评测的成本不高——认真做一轮约两个工作日——却能在项目全周期里反复止损,是本章性价比最高的一项作业。
三个高频追问
选型话题收尾前回答三个高频追问。追问一:选型结论要不要写文档?必须写——一页选型记录(结论、三条理由、放弃项)是后续所有技术争论的仲裁依据,半年后新同事质疑「为什么不用某引擎」时,这份记录省掉一轮完整的重新论证。追问二:选型多久重评一次?绑版本节奏而不是绑日历——运行时大版本更新、硬件采购计划变更、业务延迟需求收紧,三者任一出现才触发重评;周期性为重评而重评,消耗的是本可投入优化的工程时间。追问三:小项目要不要做这么完整的选型?流程可以缩、动作不能省——哪怕只用一天,也把「硬件存量、延迟预算、运维约束」三问过一遍并留下三行字结论。选型的仪式感可以打折,选型的思考不能跳过:这一章的全部内容,压缩到底就是这三问加三行字。
本节要点回顾
- 选型第一问是硬件:NVIDIA 存量看 TensorRT,英特尔平台看 OpenVINO,混合与未定用 ONNX Runtime 兜底。
- 性能上限排序因设备而异:没有全场冠军,只有匹配环境的优势方。
- 运维成本进总账:排错透明度、版本协同、跨设备迁移成本都该在选型时计价。
- 组合是常态:ORT 挂 EP 兼顾通用与深度优化,开发期与生产期可以换栈不换模型。
选型尘埃落定,假设你留下了 OpenVINO——第 2 章开始处理第一个实操问题:手里的模型怎么变成 IR,转换失败时怎么排。