6.4 视频结构化流水线实战
6.4 视频结构化流水线实战
本节摘要:把检测模型放进一条「解码、推理、跟踪、结构化输出」的视频流水线,是工程落地的总装课。本节给出四段式流水线的职责切分与线程模型、一段可跑的异步骨架代码、逐段瓶颈的定位方法,以及实测调优前后的对照数字。
前五节各自交付了零件:转换好的模型、调度好的运行时、立起来的服务。这一节做总装——一条 7×24 小时吃视频流、吐结构化记录的流水线。它是本书出场率最高的真实形态:安防、零售、质检、交通,底层都是这一条链。
四段式流水线:各段有自己的时钟
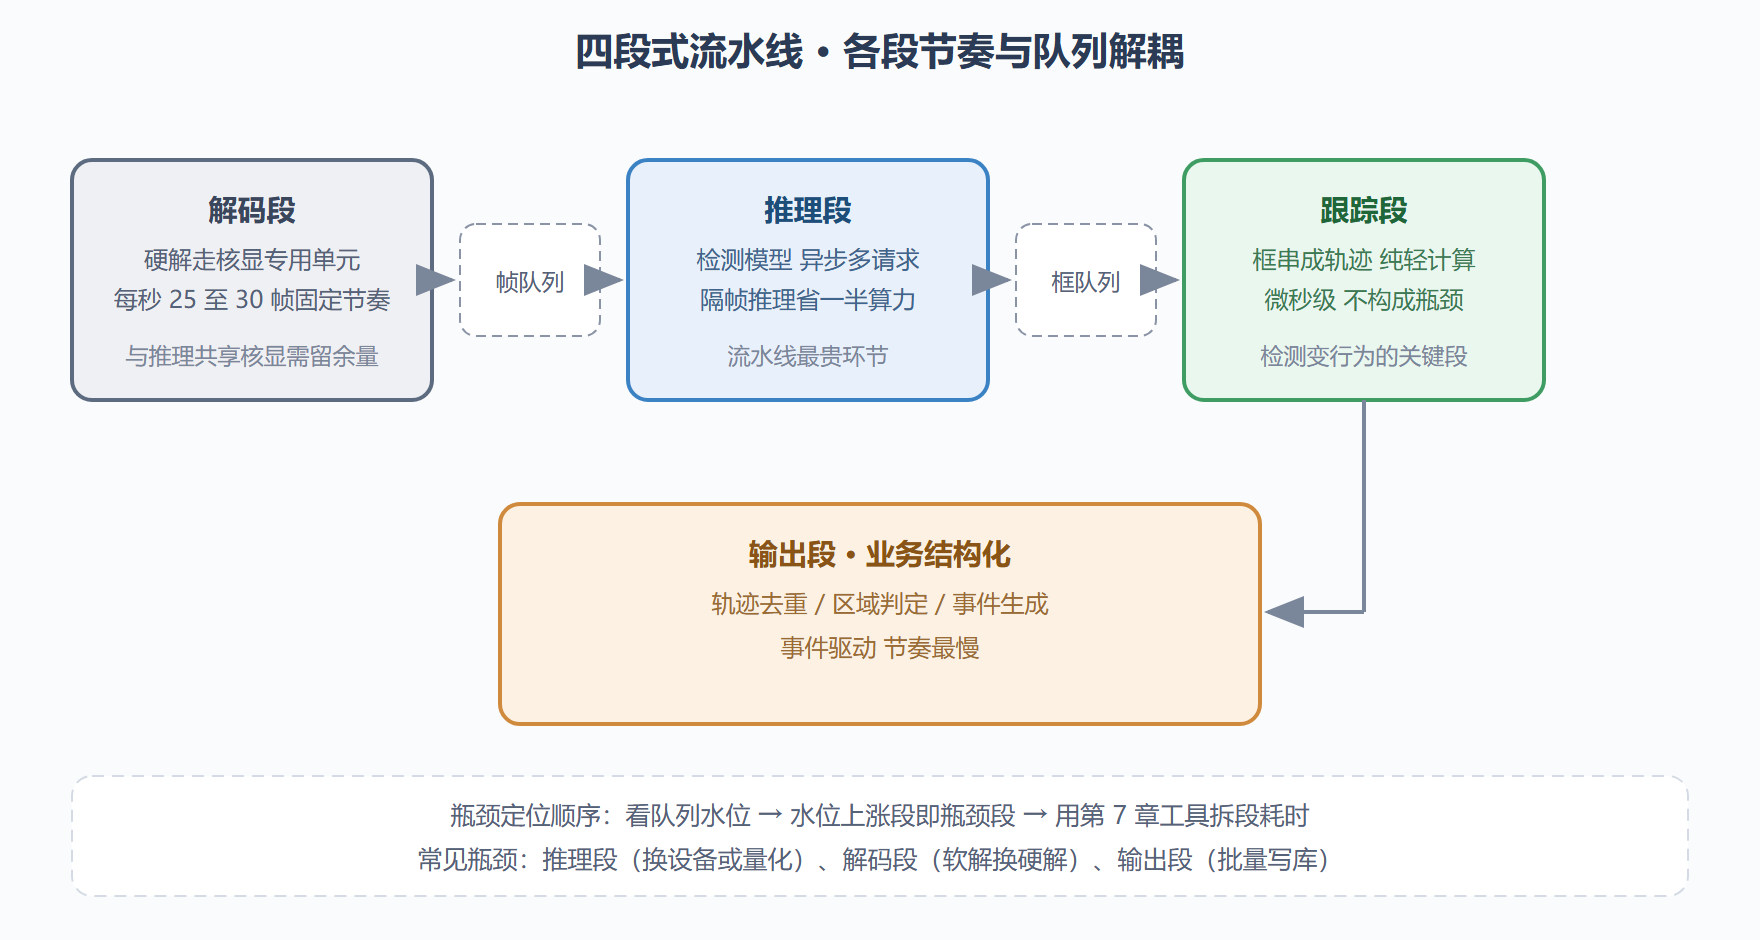
流水线按职责切四段,每段的节奏完全不同。
解码段把压缩视频流还原成帧。硬解码走核显的专用单元,CPU 占用近乎为零;软解码吃 CPU 但兼容性好。解码频率由视频帧率决定,通常每秒 25 到 30 帧,节奏固定。
推理段对关键帧跑检测模型。它是流水线里最贵的环节,节奏可以比视频慢——不是每帧都值得推理,隔帧或按场景触发都能省一半算力,业务几乎无感。
跟踪段把逐帧的检测结果串成目标的连续轨迹。纯 CPU 轻计算,微秒级,但它是「检测框」升级为「行为记录」的关键:没有跟踪,同一件商品在连续帧里是十个目标;有了跟踪,才是一条可统计的轨迹。
输出段做业务结构化——轨迹去重、区域判定、事件生成,写出结构化记录。节奏最慢,通常按事件驱动。
四段节奏不同,用线程或异步队列解耦是唯一正解:每段一个队列缓冲,慢段不阻塞快段,队列水位就是 7.2 节排错时的第一观察对象。
图 6-4 视频结构化流水线总装图
异步骨架:一段能跑的最小实现
把四段接成异步循环,骨架如下——注意它如何在 3.3 节异步模式的基础上做流水线化:
import queue import threading frame_q = queue.Queue(maxsize=8) # 解码到推理的缓冲 result_q = queue.Queue(maxsize=64) # 推理到输出的缓冲 def infer_worker(): request = compiled.create_infer_request() while running: frame = frame_q.get() # 阻塞取帧 request.start_async(frame) # 提交即返回 request.wait() result_q.put(request.get_output_tensor().data) # 解码线程持续向 frame_q 投帧;输出线程从 result_q 消费
三处细节决定这段代码的成色。队列容量是背压阀门:帧队列容量 8 意味着推理段跟不上时,解码线程被反压阻塞而不是无限堆积内存——视频流场景必须宁丢帧不爆内存。推理请求复用:请求在 worker 里创建一次循环复用,遵循 3.1 节「贵操作出循环」。多路视频的扩容方式是每路一组独立队列与请求,而不是共享一个请求池——请求级的线程纪律(3.1 节三纪律)在多路场景下最容易被无意违反。
实测对照与瓶颈定位
一条两路 1080p 流水线在我们测试机上的调优前后对照:
| 指标 | 初版 | 调优后 | 改动 |
|---|---|---|---|
| 端到端延迟 | 340 毫秒 | 130 毫秒 | 解码直连推理核显缓冲,减少两次拷贝 |
| 单机路数 | 3 路 | 6 路 | 隔帧推理加 INT8 量化 |
| 丢帧率 | 偶发 4% | 0 | 帧队列容量从 2 提到 8 |
调优过程严格按「先测量后动手」:第 7 章的性能工具逐段计时,发现端到端延迟的大头不在推理(INT8 后仅 18 毫秒)而在两次多余的帧拷贝——「换更强的卡」这类常识判断完全错了方向,正确的动作是 3.2 节的零拷贝改造。这单经历是全书方法论的一次浓缩:瓶颈经常不在你盯着的地方,队列水位与逐段计时会把真相摆出来。
多路场景的资源配置账
单路骨架跑顺后,多路是自然的扩张,资源账要重算。每增加一路,新增的不只是推理计算——解码缓冲、帧队列、跟踪状态各占一份内存,核显的解码单元也有路数上限。实测的扩容曲线值得记录:我们的测试机从一路到四路,延迟几乎不变(设备利用率从三成升到七成);第五路开始延迟爬升,第八路丢帧重现。曲线说明扩容的瓶颈从「每路串行耗时」切换到了「设备总容量」,解法随之变化:前者加并发优化单路,后者只能减负——降帧率、缩输入、量化压缩,或者按 6.3 节的拓扑分工把部分路数分给别的设备。扩容前先画这条曲线,扩容时才知道自己在曲线的哪一段。
结构化输出的接口设计
输出段产出的「结构化记录」是流水线与业务系统的契约,设计质量决定下游集成成本。三条设计原则。轨迹为单位:输出以目标轨迹为最小单元(进区时间、出区时间、类别、轨迹摘要),而不是逐帧检测框——下游关心「发生了什么」,不是「每帧看见了什么」。事件与快照分离:结构化记录走数据库,关键帧快照走对象存储,记录里存引用不存图——两边各自扩容互不拖累。schema 版本化:输出结构加版本字段,下游按版本解析,上游演进不破坏旧消费者。这套设计让流水线从「demo 输出打印」升级为「业务系统的数据源」,也是 6.2 节服务化四项责任里「接口契约」在流水线场景的具体形态。
一条容易被忽视的健康指标:处理延迟的分布
帧率与丢帧之外,流水线还有第三个健康指标:单帧处理延迟的分布。均匀的延迟分布说明各段配合顺畅;出现「多数帧很快、少数帧极慢」的长尾,说明存在周期性阻塞——常见根因是输出段的批量写库、日志同步刷盘、或解码单元的周期性缓冲切换。长尾本身不影响平均帧率,却会让「检测到目标到记录入库」的最坏时间失控,对实时告警类业务是实质缺陷。定位手段就是队列水位加逐段计时:长尾出现时看哪个队列瞬时堆积,水位尖峰对应的段就是嫌疑段。把延迟分布(而不只是平均值)纳入监控面板,长尾无处遁形——这也是 7.1 节「平均延迟骗人」论断在流水线里的又一次应验。
三个高频追问
流水线实战收尾,回答三个高频追问。追问一:隔帧推理会不会漏检快速移动的目标?会漏检瞬间事件,但有解法——跟踪段用轻量运动预测把帧间轨迹外推,推理段只需修正预测,隔帧的漏检被连续性补上;「检测加预测」的分工比盲目提高推理频率划算。追问二:多路视频的时间同步怎么处理?不同源的帧时间戳先统一到同一时钟(取分发服务器或采集端的时间基准),跨路事件关联(比如两路画面同一目标)才有意义——时间戳问题在单路 demo 里隐形,多路上线即爆发,先把时钟基准定下来。追问三:流水线的单元测试怎么做?四段各自可独立喂测试数据——解码段喂固定视频样本、推理段喂固定帧、跟踪段喂固定检测序列、输出段比对结构化记录的完整字段,端到端再留一条黄金路径回归;「段级可测」是四段式切分的隐藏红利,也是架构切分值得坚持的又一个理由。三个追问的共同答案:流水线的问题都要在「段」的粒度上回答,段边界清晰,答案自然清晰。
本节要点回顾
- 四段各有节奏:解码固定频率、推理可降频、跟踪微秒级、输出事件驱动,队列解耦是骨架。
- 队列即背压:容量设计成「宁丢帧不爆内存」,水位是最重要的健康信号。
- 请求复用加独立分路:每路独立队列与请求,扩容靠加路不靠共享。
- 先测量后动手:逐段计时定位瓶颈,常识判断在实测面前经常是错的。
至此工程落地章完成。最后一章回答收尾之问:跑起来的系统怎么证明它跑得好、出问题怎么快速定位——第 7 章性能分析与排错。