6.3 边缘与云端部署
6.3 边缘与云端部署
本节摘要:边缘与云端不是二选一,而是按延迟、数据主权、网络可靠性、单请求成本四个变量的连续谱。本节给出拓扑决策的四个问题、三种典型分工形态,以及模型更新与监控在两侧的不同打法。
服务化解决「模型怎么被调用」,拓扑解决「算力放在哪」。这个问题看似基础设施话题,实际的决定权在业务特征手里:帧从哪来、结果多快要、数据能不能出门。本节把拓扑决策拆成四个问题,让你按题作答而不是按时髦作答。
四个问题定拓扑
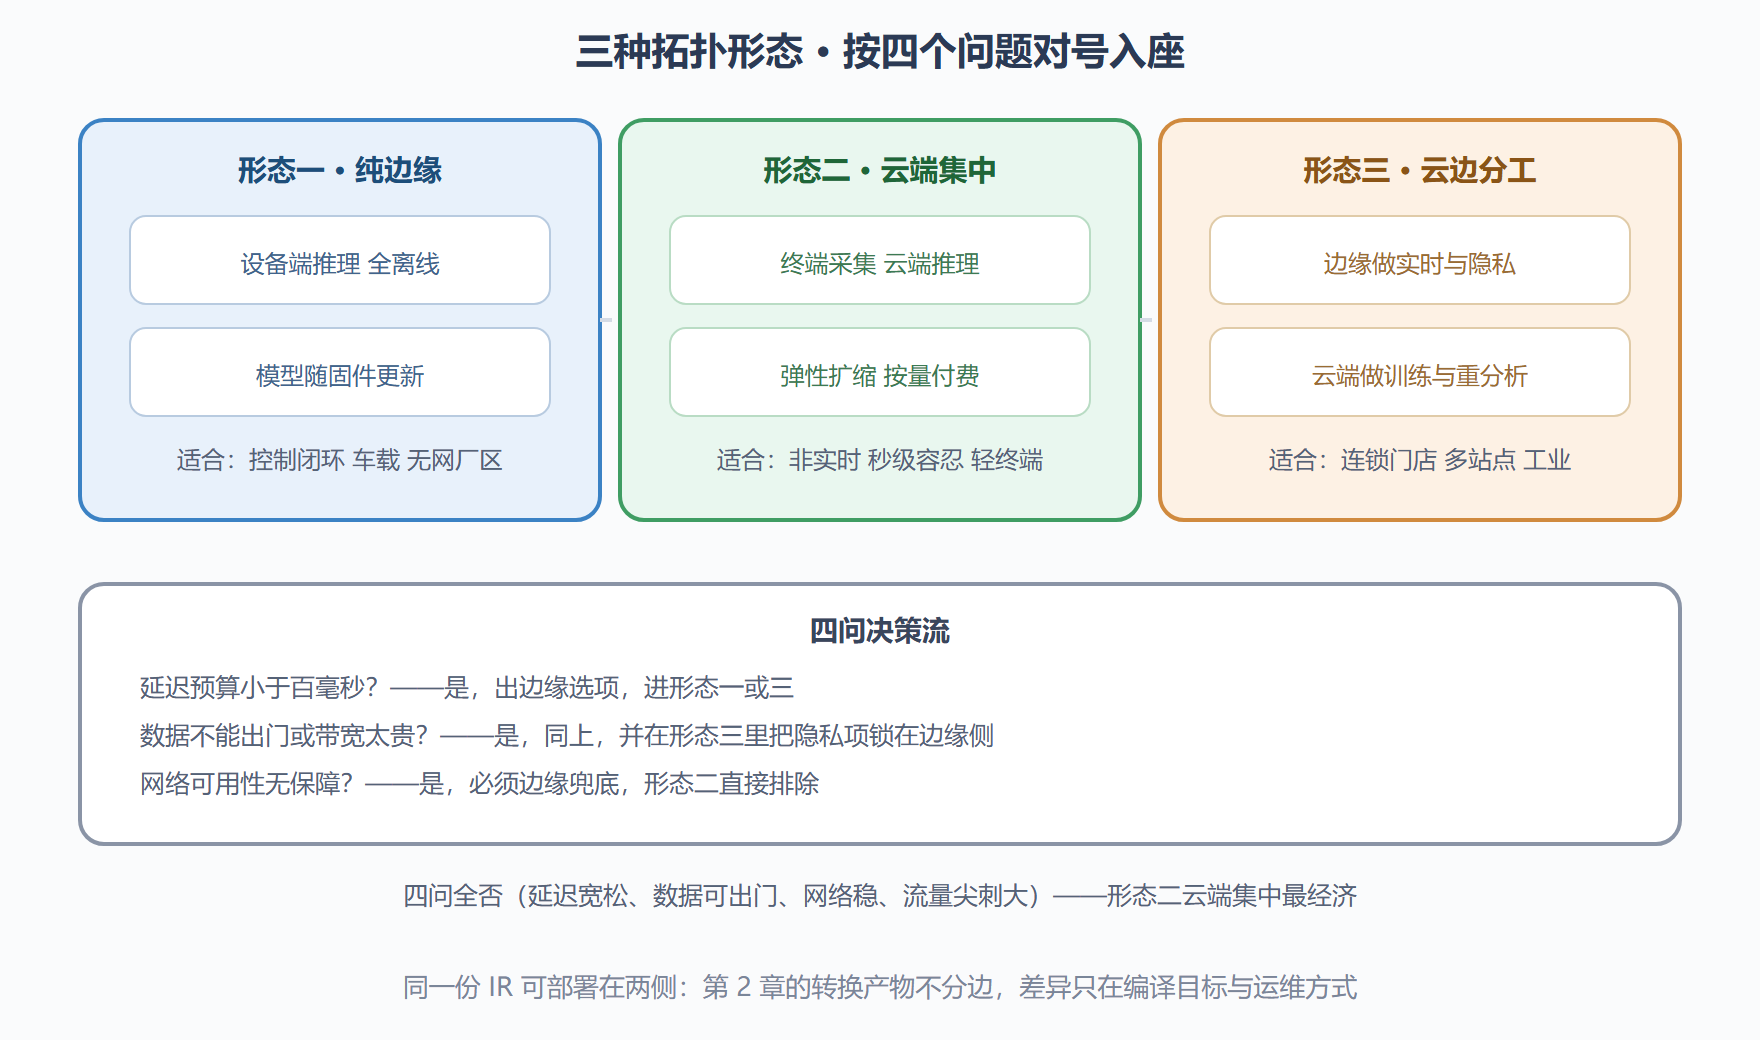
结果要多快? 端到端延迟预算在几十毫秒内的(机械控制、实时告警),网络往返本身就把云排除在外——广域网单程延迟的抖动比推理耗时还大,链路依赖等于把业务命脉交给运营商。秒级可容忍的(报表分析、内容审核),云端集中算力的经济性开始占优。
数据能不能出门? 这条经常一票否决。影像不出院区、生产数据不出厂区,是合规红线而非成本考量;视频原始流出门的带宽成本也常把「云端集中」的经济性反过来。凡是数据主权或带宽占大头,天平滑向边缘。
网络可靠吗? 门店、厂区、车载场景的网络可用性从来不按 SLA 走。断网即停摆的业务,边缘是唯一选项;断网可以降级运行的,云边混合才成立。
单请求的成本账怎么算? 云端弹性实例按用量计费,流量平稳时单位成本可控;流量尖刺明显时,为峰值预留的云端资源大半时间在空转,边缘设备的固定成本反而更优。反过来,重模型低频调用,边缘盒子可能一年都收不回采购成本。
图 6-3 三种典型拓扑形态与适用边界
同一份模型,两侧不同的活法
OpenVINO 的一个实用性质是模型产物与部署位置解耦:同一份 IR,编译到边缘盒子的 CPU 是它,编译到云端服务器的多路至强也是它。差异出在两侧的运维重心。
边缘侧的重心是不动手:设备散在各处,触达成本高。模型更新要设计成分发机制——灰度推送、失败自动回退、版本可查;监控要设计成低频汇总上报,不能让遥测流量吃掉业务带宽;降级策略要预演——推理服务挂了,设备是否退回规则逻辑。5.3 节的资源切分经验在这里原样适用,外加一条:边缘设备的磁盘与内存都金贵,模型文件与运行日志的滚动清理要在上线前写进系统设计。
云端侧的重心是弹性与复用:流量尖峰靠横向扩实例吸收,编译产物缓存复用(同一模型不必每次启动重新编译)、多实例共享模型仓库。云主机的 CPU 规格多样,编译时锁定指令集架构可以避免「新机型上跑着兼容路径」的隐性浪费——这是 4.3 节指令集话题在云端的延伸。
一条容易走偏的路:过早拓扑化
我们在评审里反复拦下一类设计:业务还没跑通,拓扑图已经画了三层云边协同。拓扑的目的是服务业务指标,指标没定,拓扑就是在给架构师过瘾。正确顺序是先按 7.1 节的方法把单点性能测明白、把延迟预算拆解到环节,拓扑的选择余地会自己显现——多数「必须云边协同」的诉求,拆完预算后发现一个形态就够。
两个形态迁移的真实案例
拓扑决策看两个端到端案例。案例一是「云端迁边缘」:某工厂外观检测起初把图像传云端识别,上线三个月后两类问题爆发——厂区网络抖动导致检测队列积压,产量数据出域触发了合规审查。迁移方案把检测模型压到 INT8 部署在厂内工控机,云端只保留模型训练与数据回流。迁移后延迟从平均两百毫秒降到十五毫秒,合规问题随之消失,代价是自建了一套边缘设备的模型分发流程。案例二是「边缘升云边分工」:连锁便利店的海报识别起初每店一台边缘盒子,模型月度更新靠人工巡店刷机,五十家店更新一次要三周。重构后边缘盒子保留实时识别,云端集中做模型迭代与灰度,新模型经云端的分发通道按店灰度推送。更新周期从三周压到一天。
两个案例方向相反,教训同构:拓扑不是一次决策,是随业务演进的连续调整;每次调整的触发器都不是技术时尚,而是具体痛点——网络抖动、合规红线、更新周期。把「什么信号出现时该重新审视拓扑」写进运维手册(延迟劣化超过预算、数据合规新规、更新成本超过阈值),拓扑治理就从架构师的直觉变成了团队的机制。
离线降级:边缘方案的第二条命
纯边缘与云边分工的方案,都要回答同一个问题:断了网之后,业务降级成什么样。降级设计分三档。第一档功能降级:联网功能(日志上传、模型更新、远程支持)停用,核心推理照常——这是默认底线,任何边缘方案都必须做到。第二档能力降级:网络中断超过阈值后,把重模型换成常驻的轻量备胎模型,精度让位给可用性——备胎模型要在上线前就与主模型同套验收,不能临时抓一个顶数。第三档安全停机:核心推理也不可用时(设备故障、极端环境),业务侧的机械或人工兜底流程接管。三档各自的切换条件与恢复条件要写成状态机并演练——「演练」是关键词,没演练过的降级方案在真断网时的表现,通常比没有方案更混乱。
成本核算的一个完整框架
四问里的成本账,给一个可复用的核算框架。边缘侧合计:硬件采购摊销加电力加现场运维人力(按巡店频率折算)加网络基础费。云端侧合计:实例费用(按峰值预留还是按量)加存储与流量费加运维人力。两侧共同的隐形项:模型分发的开发与维护成本——云边分工形态里这笔最容易被低估。核算周期按三年算,设备类项目寿命普遍如此。给一个经验参照:路数在个位数、点位分散、数据敏感的场景,边缘的三年总成本几乎总是更低;点位集中、流量尖刺大、模型迭代每周发生的场景,云端的弹性优势才能兑现。框架的意义不是给出答案,而是让两边的支持者用同一张表吵架——数字进桌,情绪退场。
三个高频追问
拓扑话题收尾,回答三个高频追问。追问一:边缘设备的模型更新能不能完全自动化?技术上可以(分发通道加自动回退),但建议保留人工灰度环节——边缘场景的输入分布与测试集差异最大,自动推送直接全量是常见事故源;「自动分发、人工放行」是效率与稳妥的平衡点。追问二:云端推理与边缘推理的结果会不一致吗?同一份 IR 加同一配置下结果一致,但两侧编译目标不同、版本可能不同步,现实中确实会漂——对结果一致性敏感的业务,把「两侧版本对齐」写进发布检查单。追问三:混合形态的监控怎么做?两侧各采各的指标、汇聚到一处看板,边缘侧注意「汇报间断网也要活」——指标先落本地、联网后补传,监控本身不能成为对网络的依赖。三个追问的共同底色:拓扑的复杂度不在画图,在运维细节,而运维细节的最省心解法是「把断网、漂移、更新当设计输入,不当意外」。
拓扑评审的三个必答题
把四问决策法用成评审清单,给任何拓扑方案三个必答题。一答「最坏网络」:广域网断开二十四小时,业务降级到什么程度?答不出的方案还没设计完。二答「最坏数据」:如果合规方明天要求某类数据不得出域,方案要动多少?改动越小说明架构越有韧性。三答「最坏规模」:点位翻三倍后,更新的推送与运维人力怎么走?线性增长的运维是拓扑埋下的债。三题都有明确答案的方案,才值得进入细节评审——这三个「最坏」问题把四问决策法从静态选择变成了压力测试,是拓扑评审里性价比最高的十分钟。
本节要点回顾
- 拓扑是连续谱:延迟、数据主权、网络可靠性、成本结构四问定形态,不赶时髦。
- 三形态:纯边缘保实时与离线,云端集中换经济与弹性,云边分工兼顾两侧。
- 两侧运维重心:边缘重「不动手」(灰度、回退、降级),云端重「弹性与复用」(扩缩、缓存、指令集锁定)。
- 先测后定拓扑:单点性能与延迟预算拆解清楚之前,别画三层架构图。
拓扑定了、服务立了,还差一口气:把「摄像头进、结构化结果出」的完整链路跑起来。6.4 节用一条视频结构化流水线,把全书前六章的零件做一次总装。