2.4 作业提交全链路复盘
2.4 作业提交全链路复盘
本节摘要:本节把前三个站点的知识串成一次完整实操:从敲下提交命令那一刻开始,逐段还原客户端生成作业图、Dispatcher 接单、ResourceManager 批槽位、TaskManager 领任务的全过程,并标注每一环的典型报错特征。这是一张"提交排错地图",作业起不来时按图索骥。
深夜的那条提交记录
凌晨的值班群里甩进来一句"作业提交了十分钟还没起来,Web UI 上也看不到"。遇到这种事,新手翻遍百度,老手只问一句:卡在哪一步? 提交不是一锤子买卖,而是一条有明确站点的流水线,每一站都有专属的日志特征与死法。本节就沿着这条流水线复盘一遍——它是第 2 章的收官站,也是你第一次把架构知识兑现成排错能力。
全链路六站
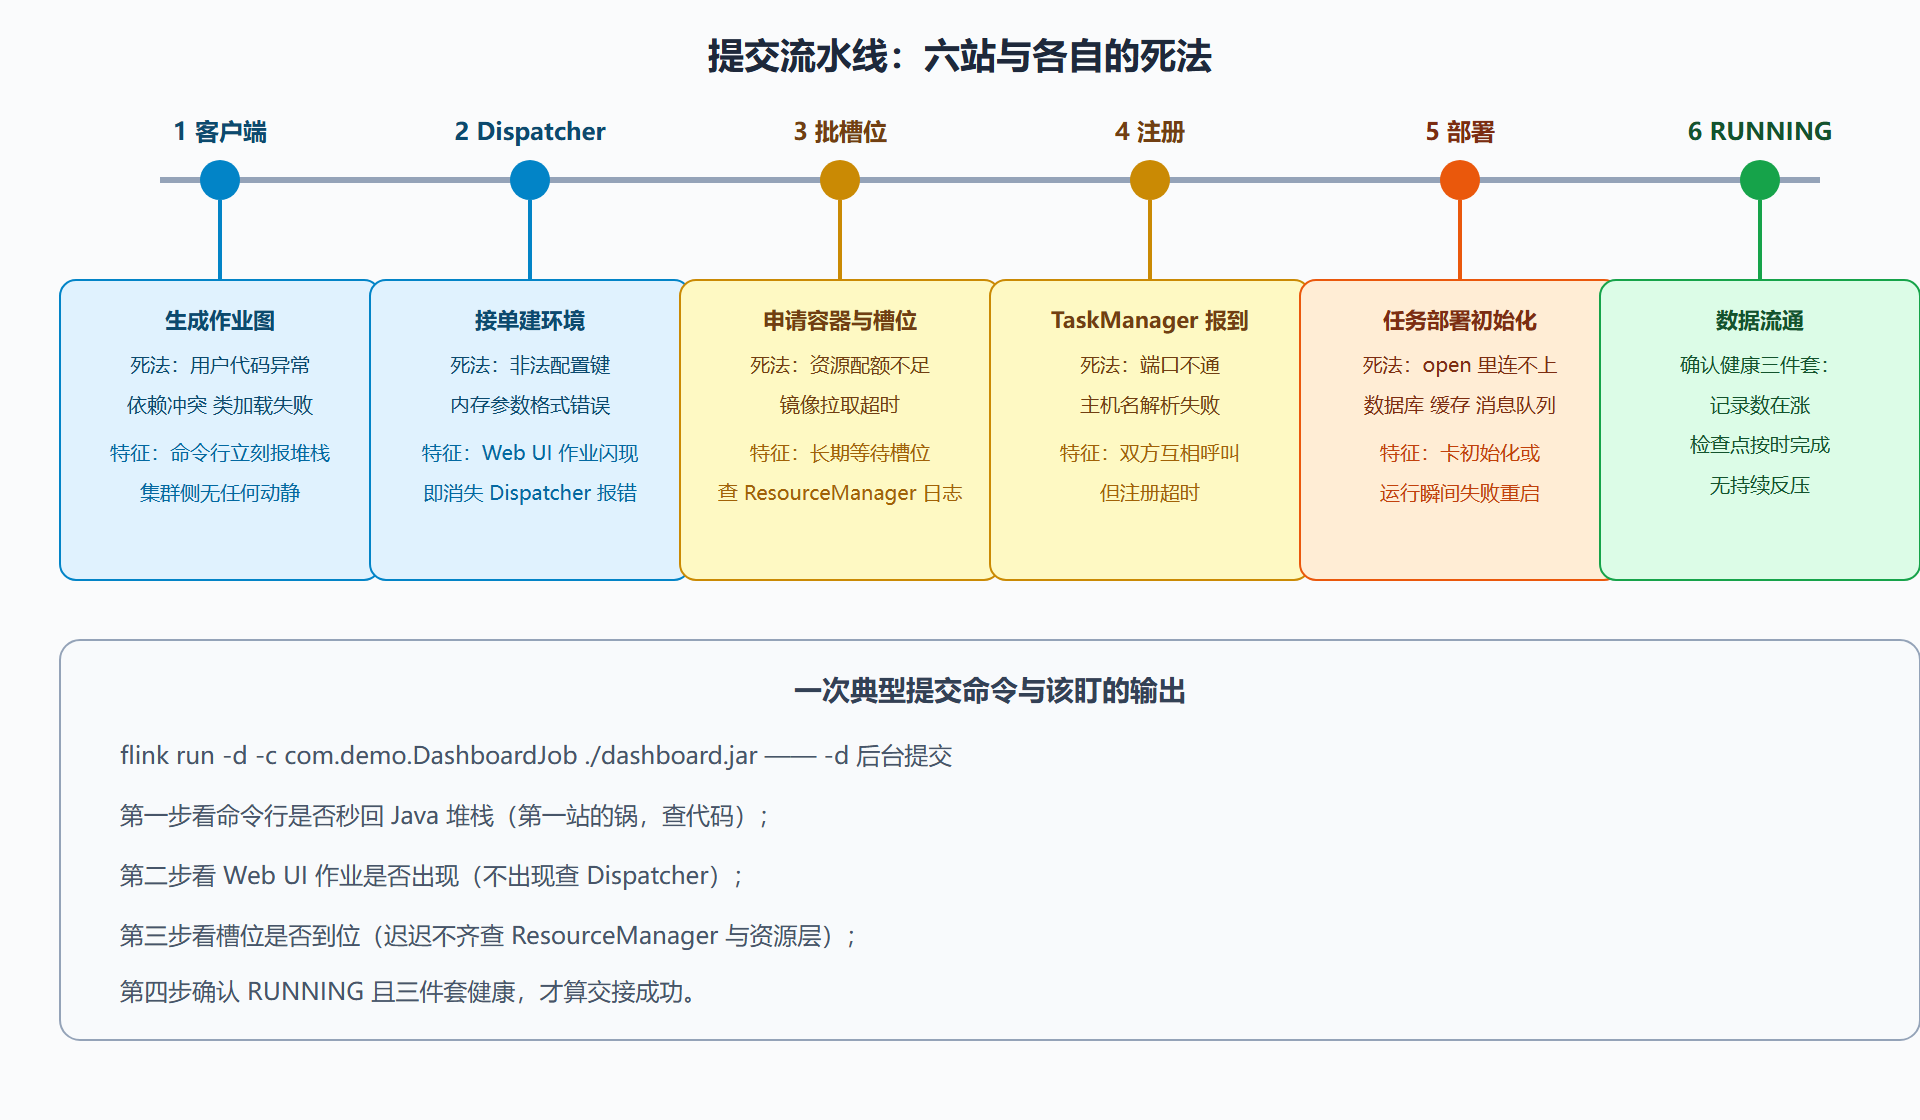
第一站:客户端侧的图生成。 提交命令的本质是把一段用户代码交给客户端进程执行:它跑 main 函数,把 DataStream 程序翻译成作业图,连同依赖 JAR、配置一起打包发给集群。绝大多数"提交即失败"死在这里——用户代码抛异常、main 里环境初始化出错、依赖冲突导致类加载失败。特征是命令行立刻打出 Java 堆栈,集群侧风平浪静。看到这种报错先别怀疑集群,本地 main 能不能跑通是第一道自查。
第二站:Dispatcher 接单。 作业图送达 Dispatcher,它为这次提交创建运行环境,随后向 ResourceManager 申请执行该作业所需的容器与槽位。这一站的死法多与配置有关:非法配置键、格式错的内存参数,Dispatcher 会直接拒绝并把原因写进日志。作业若在 Web UI 上"闪现一下就消失",多半是这一站把作业弹了回来。
第三站:ResourceManager 批槽位。 账本先生开始分房:检查现有空闲槽位,不够则向资源层申请拉起新 TaskManager。Kubernetes 上这一步是拉容器镜像,YARN 上是申请容器资源。这一站的经典死法有三个:资源层配额不够、镜像拉取超时、TaskManager 起来后注册失败(常见于内存参数超过容器限额被操作系统干掉)。作业长时间停在"正在等待槽位分配",就守着 ResourceManager 的日志看。
第四站:TaskManager 注册与槽位下发。 新生的 TaskManager 向 ResourceManager 报到,后者把槽位分给对应作业的 JobMaster。这一站的死法通常是网络问题——TaskManager 与 JobManager 之间端口不通、主机名解析失败。日志特征是双方各自喊话但互相听不见。
第五站:任务部署与链建立。 JobMaster 把执行图的每个子任务派发到槽位,TaskManager 为每个任务起线程,算子链按 2.2 节的规则合并成形。用户代码在 open 生命周期方法里做的初始化(建连接、加载配置)此刻执行——作业卡在"正在初始化"或反复在"运行中"瞬间失败,八成是 open 里的外部依赖连不上(数据库、缓存、消息队列的地址、账号、网络)。
第六站:数据流通,作业 RUNNING。 源算子开始拉数,水位线开始推进,Web UI 上记录数开始跳动。到这一站才算真正"提交成功",但值班经验提醒:RUNNING 不等于健康,要再确认检查点是否按节奏完成、各子任务反压读数是否正常,才算交接完毕。
图 2-4 提交流水线与每站的典型死法
把地图刻进肌肉记忆
这张地图的用法是排除法:作业起不来时,先判断"集群看到作业了吗"。看不到——死在第一、二站,查客户端输出与 Dispatcher 日志;看到了但一直不 RUNNING——死在第三、四站,查资源层与网络;RUNNING 又退回重启——死在第五站,查任务日志里的初始化异常;RUNNING 但不健康——回到第 2.3 节看反压,去第 4 章看检查点。四个岔路口,四条诊断分支,比"重启试试"科学得多。
还有一种提交形态的差异值得提前知道:同样是提交,有的模式客户端在本地生成图(连着集群跑),有的模式把 main 直接调度到集群里执行(Application 模式)。差别带来的影响是——本地生成会占用提交机带宽传 JAR,集群执行则把这份开销挪进了集群内部。大型 JAR 频繁提交导致提交慢,换提交形态往往立竿见影,这个话题在第 6 章 6.1 节部署模式里展开。
三份真实报错的对号入座
把地图练成条件反射,最好的教材是真实报错。报错一:提交命令秒回"ClassNotFoundException"。对号入座:第一站,用户依赖打包缺类。处置:检查构建产物的依赖合并(shade 与否、依赖范围),集群侧无责。报错二:Web UI 作业卡在"等待槽位分配"超过十分钟。对号入座:第三站。处置顺序:先看集群空闲槽位数(真没资源),再看 ResourceManager 日志的容器申请记录(申请被资源层拒绝——配额或镜像问题),最后核对作业声明的并行度是否超过集群容量(申请量本身不合理)。报错三:作业反复"RUNNING 数秒即重启"。对号入座:第五站,任务初始化失败。直接翻 TaskManager 日志里该任务的异常栈,十有八九是外部连接配置错误(地址错、账号过期、网络不通)。三份报错覆盖了六站流水线的三个高频故障面,处置的共同起点都是"先定位站点,再读对应日志"——顺序反了就会在错误的日志文件里大海捞针。
收尾一个习惯建议:把每次提交故障按"站点 + 症状 + 处置"三列记进团队的知识库。六站流水线的故障面是有限的,攒上几十条真实记录后,新故障出现时翻一下库,八成能找到前人的处置路径——提交排错地图会随着记录变厚而越来越准,这是值班团队最划算的一项复利投资。
本节要点
- 提交是一条六站流水线:客户端建图、Dispatcher 接单、批槽位、注册、部署、RUNNING,每站死法与日志特征都不同。
- 排错用排除法:先问"集群看到作业了吗",再看"槽位到位了吗",最后看"任务初始化成功了吗"。
- RUNNING 不等于健康,交接前要确认记录数、检查点、反压三件套。
- 提交形态影响 JAR 传输开销,提交慢时考虑换成集群侧执行的 Application 模式。
第 2 章结束。作业已经稳定呼吸,但数据的"时间"还是一笔糊涂账——下一章,我们进入全册最核心的概念山头:时间语义与窗口。