2.3 网络通信模型:缓冲区与反压的物理原理
2.3 网络通信模型:缓冲区与反压的物理原理
本节摘要:跨算子链的数据交换走的是一套基于网络缓冲区的通信栈:上游攒批发送,下游按需领取,信用机制让压力能够逆着数据方向回传。本节拆解这套机制的工作原理,解释"反压"这一值班室头号高频词的物理学成因,并给出缓冲区相关核心参数的第一轮调参直觉。
一个只有半个词的行话
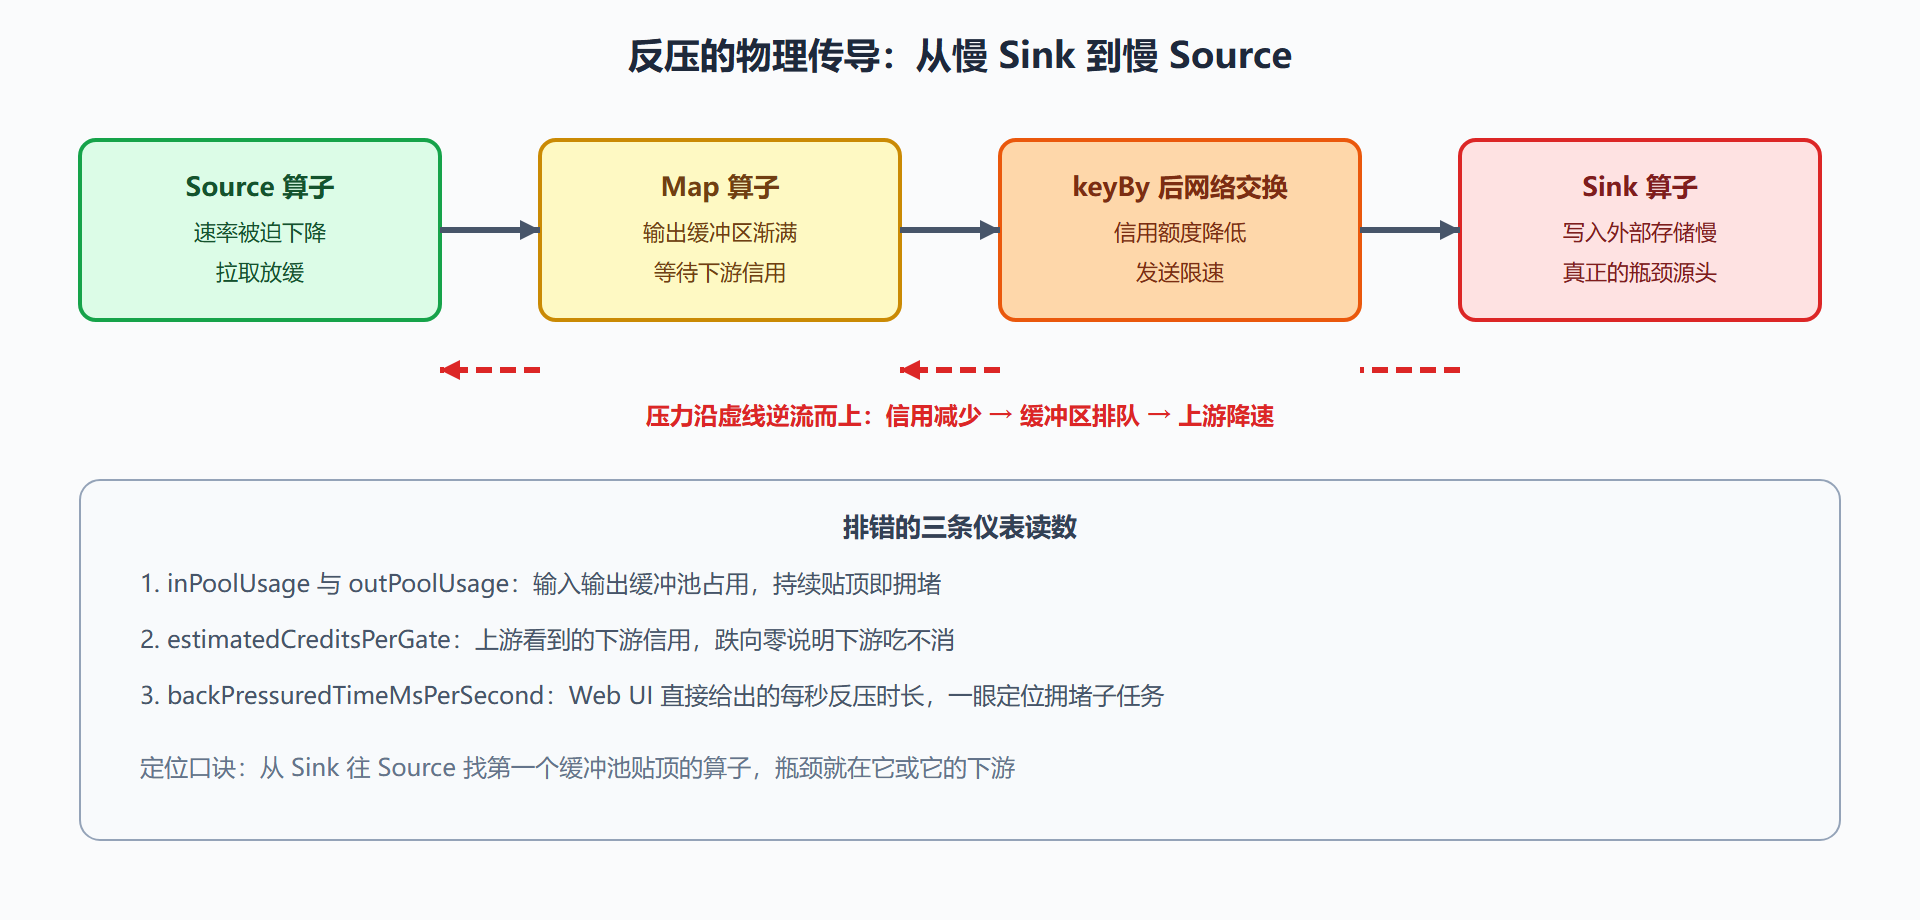
"反压",值班群里出现频率最高的词,其实是个只说了一半的外来语——backpressure 的完整语义是"逆流而上的压力"。数据从上游流向下游,压力却能从下游顶回上游:下游消费不动,它的输入缓冲区先满,然后拒绝新的信用,上游发不出去,上游自己的输出缓冲区跟着满,再往上的算子随之降速。理解了这个传导链,"反压"就不再是玄学,而是一套可以逐级检查的物理装置。本节正是要把这套装置拆给你看。
网络栈的两层结构
先分清数据在哪一层流动。同一条算子链内,数据在线程内直接传引用,不碰网络栈;只有跨链、跨进程的重分区(keyBy、rebalance 等)才走网络通信。所以反压问题只发生在链边界,这也是为什么排查时要先看 2.2 节的链结构——链划得越合理,需要过网络的点越少。
跨链通信的路径是:上游子任务把序列化后的记录写进输出缓冲区(ResultPartition 的子分区),缓冲区攒够一批或超时后经网络发出;下游子任务用输入缓冲区(InputGate)接收,反序列化后交给算子线程。两端之间最核心的设计是信用机制:下游定期向上游通报"我还有几个空闲缓冲区"(这就是信用),上游最多只发信用额度以内的数据量。
这套设计的巧妙之处在于把"死等"变成了"预约"。早期实现里上游不管下游死活,只管往缓冲区塞,塞满就阻塞等待;信用机制改为下游申报容量、上游按额度发货,缓冲区不再被填到溢出,压力以"信用数字下降"的形式精确回传。你在指标里看到的 outputQueueLength 与 estimatedCreditsPerGate,就是这条传导链上的仪表读数。
图 2-3 反压传导链:压力如何逆流而上
缓冲区的取舍:延迟换吞吐
攒批发送带来吞吐,也带来延迟——缓冲区不满就不发,数据就得等。引擎的解法是缓冲超时:缓冲区攒够大小立即发送,或者超时未攒满也强制发送。超时设 0 表示来一条发一条(延迟最低、吞吐受损),默认值在吞吐与延迟间取平衡。低延迟大屏场景可以调小这个值,纯吞吐管道则可以放大。
// 缓冲超时:默认约 100 毫秒,攒满即发、超时也发 // 大屏类低延迟作业建议压到 10 毫秒;纯吞吐管道可放大到 200 毫秒 StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment(); env.setBufferTimeout(10); // 全局设置;个别算子可用 name("x").setBufferTimeout(...) 单独覆盖
# 网络缓冲相关:每条通道固定缓冲数 + 浮动缓冲池,内存紧张时先核对这两项 taskmanager.network.memory.buffers-per-channel: 2 taskmanager.network.memory.floating-buffers-per-gate: 8
参数背后的直觉值得记一笔:每条通道固定缓冲保证基本吞吐,浮动缓冲池按需调剂给繁忙的通道。下游并行度高、通道多的作业,浮动池是缓冲竞争的焦点;反压作业的缓冲往往都被瓶颈方向的通道占走,这也是为什么缓解反压有时要"限制消费不均"(比如给倾斜键打散,见第 8 章)而不是一味加缓冲。
反压不是故障,是系统的自我保护
值得建立一个反直觉的认知:反压本身不是 bug,而是引擎在"下游消费不动"时的正确反应——它用降速代替数据丢失,用排队代替内存溢出。真正要治理的是瓶颈本身:Sink 写外部存储太慢,就去优化写入批量与重试;某算子逻辑过重,就去拆分或并行化;数据倾斜造成单实例拥堵,就去打散热键。第 6 章 6.4 节会带你完整走一遍从发现反压到定位瓶颈算子的实操流程,那里用到的每一步推理,都建立在本节的物理模型上。
一道缓冲区工单的完整推理
把本节原理演练成一道完整的工单推理。工单:作业吞吐比设计值低三成,无倾斜、无慢调用,监控上各子任务繁忙度均匀地高——齐忙的脸型,排除倾斜;外部依赖响应正常,排除瓶颈外移。翻到网络层证据:日志里出现网络缓冲不足的提示,浮动缓冲池占用长期贴顶。对照本节的账本推理:该作业 keyBy 后下游并行度六十,每条通道固定缓冲加浮动池的总量在高并行度下捉襟见肘,上游子任务频繁等信用,整体吞吐被网络层卡住。处方:上调托管内存里网络分区占比、下调缓冲超时观察延迟变化,一轮调整后吞吐回到设计值。
这道工单的推理链值得背下来:先排除倾斜(看分布)、再排除外部(看依赖)、然后翻网络账本(看缓冲池占用与信用读数)。缓冲区问题在监控上的指纹是"齐忙加缓冲贴顶",与倾斜的"忙闲分化"、慢调用的"IO 等待占比高"构成三种不同的脸谱——学会认脸,网络层的故障就不再是玄学。
最后补一个容易混淆的对照:反压与延迟是两个维度。缓冲超时调小能降低"数据的等待延迟",但对反压无能为力——反压时瓶颈在消费端,缓冲再快发出去也只是把队列从上游搬到下游。把这两个旋钮分开调、分开观测,是网络层调参的基本修养。
另一个收尾提醒:升级引擎版本后,网络栈的默认行为可能微调(缓冲默认数、信用的刷新节奏),大版本升级后的第一轮压测要专门复核网络指标——老参数在新版本上的表现未必是老样子,压测数据才是唯一可信的判据。
本节要点
- 跨链数据走"输出缓冲区 → 网络 → 输入缓冲区"的路径,信用机制让下游用"申报容量"的方式限流上游。
- 反压的传导链:Sink 变慢 → 下游信用减少 → 上游发送受限 → 缓冲区排队 → 整条链降速,压力逆数据方向回传。
- 缓冲超时是延迟与吞吐之间的旋钮:压小换低延迟,放大换高吞吐。
- 反压是自我保护而非故障,治理对象永远是瓶颈算子而不是"压力"本身。
架构三章至此打通了静态与动态。下一节把镜头拉回到你最熟悉的动作——敲下提交命令之后,这趟旅程的每一步如何在日志里留下足迹。