2.3 增量模型与快照:状态保留的两条路径
2.3 增量模型与快照:状态保留的两条路径
本节摘要:增量模型与快照经常被混为一谈,其实解决的是两个相反的问题:增量模型回答「数据太多,怎么只算新来的」,快照回答「上游一直在改,我怎么留住每一天的旧样子」。本节先拆增量模型的判定机制与三种追加策略,再用一个订单状态表的小实验展示快照如何自动记录每次变化,最后给出两者的选型决策图。看懂这节,你对 dbt 物化体系的理解就补上了最难的一块。
一个同时需要新数据和历史的需求
设想一个再普通不过的需求:订单表。业务方的两个要求同时摆在桌面上——
其一,订单明细表已经积累了几亿行,报表每天要读,不可能每次构建都全量重算,只处理昨天新增的订单就行。这是增量模型的用武之地。
其二,订单的「状态」字段天天在变:昨天是「已下单」,今天变成「已发货」,后天变成「已完成」。业务复盘纠纷时经常要问「这单在三天前是什么状态」,而仓库里的源表只有当前值,旧值早被覆盖了。留住历史,这是快照的用武之地。
两个需求看起来都在对付「变化」,方向却完全相反:增量模型关心的是「新的行怎么进来」,快照关心的是「旧的值怎么留下」。 混淆两者的团队不少,后果通常是用了增量却以为留了历史(没有),或者用快照扛了本该增量扛的大表量(成本爆炸)。
增量模型:判定与三种策略
一个增量模型的骨架长这样:
-- 增量模型:每天只处理新到的订单 {{ config( materialized='incremental', unique_key='order_id', incremental_strategy='merge' ) }} select order_id, user_id, status, amount, updated_at from {{ ref('stg_orders') }} {% if is_incremental() %} -- 只有增量运行时才拼这个条件:只取比目标表里最新记录更新的行 where updated_at > (select max(updated_at) from {{ this }}) {% endif %}
三个配置项各管一件事。unique_key 声明这一行的身份:同一张订单再次出现时,按订单号识别。incremental_strategy 声明撞上同一身份时怎么处理——追加(append,新行直接插进去,旧行不动,适合纯日志型数据)、删除再插入(delete 加 insert,删旧行插新行)、合并(merge,按唯一键比对更新,最常用也最稳)。is_incremental 条件是省算力的关键:全量首跑时它不生效(查全表),增量运行时才拼上「只取比目标表里最新记录更新的行」。
三种策略怎么选,给一个工程速查:数据只进不改(日志、流水),追加最简单;数据会改且目标表能高效按键删除更新,用删除再插入或合并;仓库支持合并语法(多数现代云仓库都支持),优先合并——它把「比对、删、插」合成一个原子操作,不会出现删了旧、插新失败的中间态。
增量模型最深的坑在判定条件漏数据。用「更新时间大于目标表最大值」做增量判定时,如果上游有迟到数据——时间戳比目标表最大值还旧、但确实没进过目标表——它就被永远挡在门外,而且没有任何报错,属于「静默丢失」。缓解办法有三:判定条件留安全重叠(比如多取一小时,靠合并策略去重);用事件时间之外另加一个高水位校验;核心表每天安排一次小范围全量核对。第 3.3 节的测试体系里,「行数对账」测试就是为这类场景准备的验收工序。
快照:给变化的历史拍照
快照的配置不在模型文件里,而是独立的定义文件:
# 快照定义:追踪订单表的状态变化 snapshots: - name: orders_snapshot relation: ref('stg_orders') # 写法示意:指向被追踪的模型 config: unique_key: order_id strategy: check check_cols: ['status', 'amount'] # 只盯这两个字段的变化 updated_at: updated_at
策略有两种。时间戳法(updated_at):靠上游的更新时间字段判断「这行变了没有」,要求源表老老实实维护这个字段。比对法(check):不依赖任何时间戳,构建时把监视列的当前值和快照里的上次值逐列比对,有差异就记录。源表时间戳不可信时(大量老系统恰好如此),比对法是唯一的依靠。
跑一次构建后,快照表里的行是这样一番景象:同一张订单不再只有一行,每次被追踪字段变化都会产生一条新记录——新的字段值、这条记录的生效时间与失效时间、以及一个「当前还是历史」的标记。查询「三天前这单什么状态」就是一句简单的日期过滤:找生效时间早于三天前、失效时间晚于三天前的那条记录。
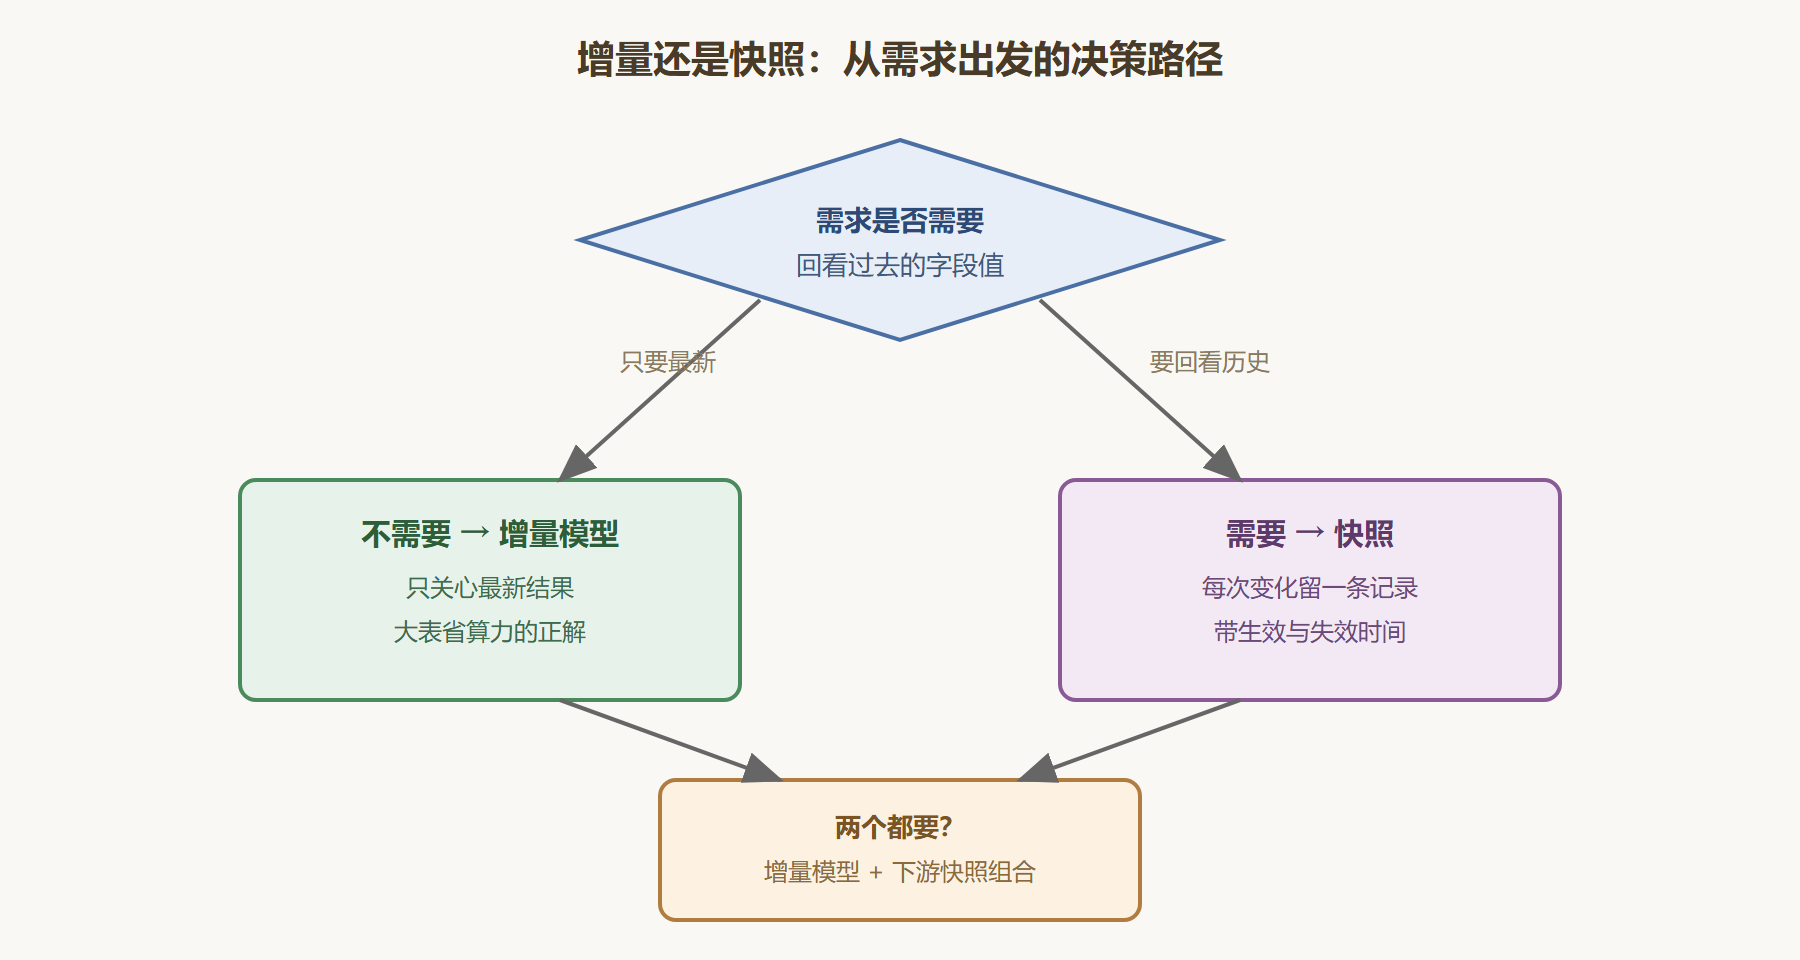
图:增量与快照的决策路径
一个五分钟小实验
把两者放进同一个场景跑一遍,行为差异立刻清楚。准备一个只有五行的小订单模型(物化设为增量,唯一键是订单号),再为它配一个比对法快照(盯状态字段)。第一天,五行订单全是「已下单」:增量表五行,快照表五行。第二天,上游模拟三张订单状态变成「已发货」、再新增两张订单:增量表从五行变成七行——新增的两行插进来、变化的三行被合并更新,状态字段的旧值已经不存在了;快照表从五行变成十行——变化的三单各多出一条新记录,旧记录原样躺着,只是被打上了失效时间,新订单也各有一条。第三天查「昨天发货的三单是什么时候下的单」,增量表答得出(当前值还在),快照表答得又快又准(按时间区间过滤)。实验做下来,两条路径的分野不用背也记住了:增量表里永远是「最新一版」,快照表里是「每一版」。
💡 关键直觉:增量的对手是「全量重算」,它省的是算力;快照的对手是「历史丢失」,它保的是记忆。大表 + 要历史时,两者是上下游关系而不是二选一:底层增量扛量,紧贴其后再建快照记录变化。
实验延伸:两种「坏了」的样子
五分钟的正向实验做完,建议再做两个「负向实验」——故意把配置写错,看两种典型事故长什么样。在测试环境里,这比在生产里第一次见到它们便宜得多。
负向实验一:增量条件漏了判断。 把 is_incremental 条件整段删掉但保留增量物化。现象:每次构建都全量扫描,构建时长与全量表无异——增量「白配了」。这个实验教你从执行日志识别「假增量」:如果一个自称增量的模型每次处理的行数与源表总量同量级,八成是条件失效(或条件写在了编译期不生效的位置)。
负向实验二:唯一键选错。 把订单明细的增量模型唯一键从订单号改成「订单号加明细行号」之外的某个非唯一列(比如用户号)。现象:合并策略按用户号比对,同一用户的多行订单互相覆盖,目标表行数莫名减少且无任何报错。这个事故的教训写进 3.3 节的测试体系就是那条主键唯一性测试——它存在的意义就是当场抓住「唯一键选错」这类配置事故。
两个实验共同的启示:增量的配置错误几乎都是「静默」的——不报错、不告警,只让数字慢慢变得不对。这也是 4.4 节档案三那句「对账是唯一的探测器」的由来。
本节要点回顾
- 方向相反的一对机制:增量管「新行怎么进来」,快照管「旧值怎么留下」,混淆方向是大多数事故的起点。
- 增量三件套:唯一键定身份、策略定冲突处理、增量条件定省算力的边界。
- 静默丢失是增量最深的坑:迟到数据会被时间戳判定挡在门外,靠安全重叠与对账测试兜底。
- 快照两种策略:源表时间戳可信用时间戳法,不可信用比对法盯关键列。
- 组合式:底层增量扛大表,下游快照留历史,量与记忆兼得。
至此,本章把「编译、依赖、物化、增量、快照」的机制线走完。下一章进入实战主线:这些机制如何在真实项目里组织成一个分层的、可验收的数仓工程。