4.1 常量缓冲与描述符堆实验
4.1 常量缓冲与描述符堆实验
本节摘要:描述符是 D3D 12 世界的"票据":CPU 写数据进常量缓冲,GPU 凭描述符找到它并按约定格式解读。本节做一个完整实验——建堆、造票、更新矩阵、绑定绘制,并现场踩一次对齐坑,把手动挡最硬核的一块驾驶技术练进手感。
先拆一个行话:Descriptor
图形圈的黑话里,Descriptor(描述符)与 Handle(句柄)最容易混。句柄只回答"在哪"——一块内存的地址;描述符还回答"怎么读"——地址之外附带解读规则:这是 2D 纹理还是 3D,格式是 RGBA8 还是 D32,采样时怎么处理边界。GPU 不吃裸指针,只认票据,因为同一块显存可以被解读成完全不同的东西。理解了这层,描述符堆(Descriptor Heap)就好懂了:票据册——一批票据按槽位排好,GPU 绘制时凭槽位翻册取票。根签名则是"这趟车要用哪几张票"的清单。三者关系一句话:堆是册子,描述符是票据,根签名是要票清单。
实验设计
目标:给 3.2 节的三角形加上"随时间变换的旋转矩阵"。这份数据每帧变化、体量小、更新频繁——常量缓冲的标准画像。实验分五步:建常量缓冲(上传堆)、建描述符堆、把常量缓冲登记成描述符、根签名加常量缓冲参数、每帧更新并绘制。每一步给代码与解读。
图1 描述符堆实验的票据流
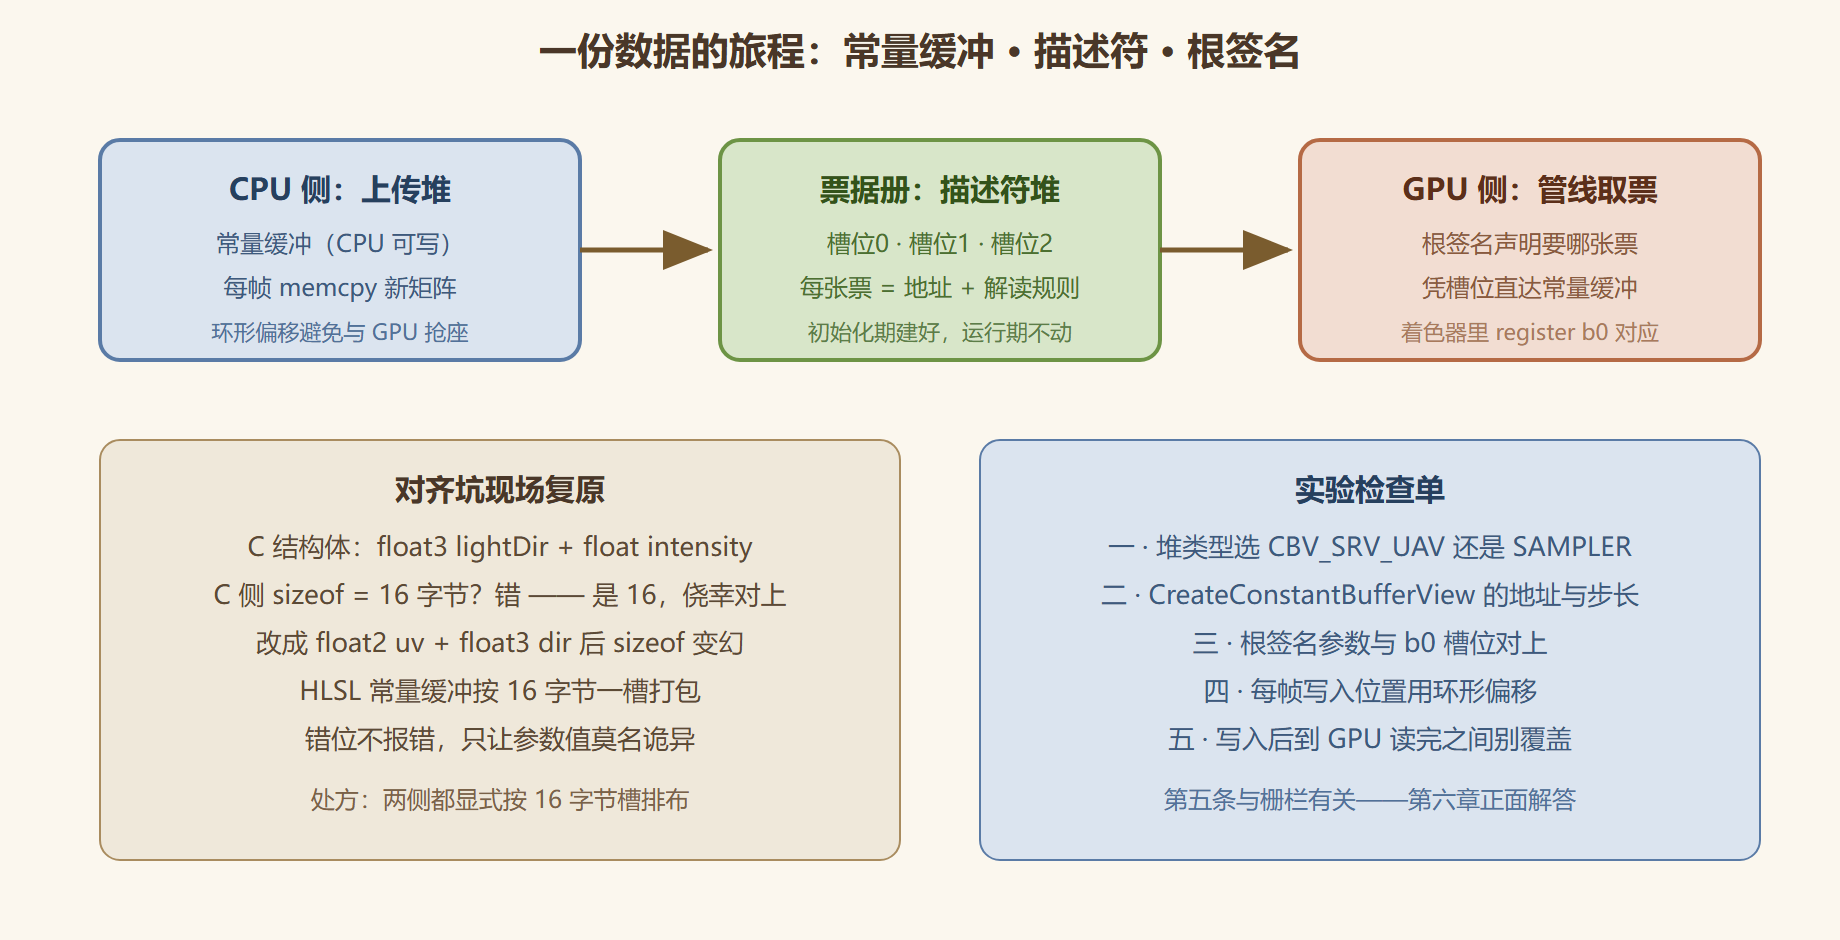
动手:五步实验代码
第一步与第二步:建缓冲与票据册。
// 常量缓冲:矩阵按 256 字节对齐分配(硬件对常量缓冲有对齐要求,取整最稳) const UINT cbSize = (sizeof(XMMATRIX) + 255) & ~255; ComPtr<ID3D12Resource> cb; CD3DX12_HEAP_PROPERTIES up(D3D12_HEAP_TYPE_UPLOAD); auto cbDesc = CD3DX12_RESOURCE_DESC::Buffer(cbSize * FrameCount); // N 帧环形 device->CreateCommittedResource(&up, D3D12_HEAP_FLAG_NONE, &cbDesc, D3D12_RESOURCE_STATE_GENERIC_READ, nullptr, IID_PPV_ARGS(cb.GetAddressOf())); // 描述符堆:票据册。类型必须是 CBV_SRV_UAV,槽位数按需 D3D12_DESCRIPTOR_HEAP_DESC heapDesc{}; heapDesc.NumDescriptors = FrameCount; heapDesc.Type = D3D12_DESCRIPTOR_HEAP_TYPE_CBV_SRV_UAV; heapDesc.Flags = D3D12_DESCRIPTOR_HEAP_FLAG_SHADER_VISIBLE; // 着色器可见才可被管线用 ComPtr<ID3D12DescriptorHeap> cbvHeap; device->CreateDescriptorHeap(&heapDesc, IID_PPV_ARGS(cbvHeap.GetAddressOf()));
第三步:登记票据。 每一帧的缓冲区段各登记一张描述符,槽位按帧号排开——这就是"环形"的由来:不同帧写不同区段,CPU 写第 N+1 帧数据时 GPU 还在读第 N 帧,互不打扰。
for (UINT i = 0; i < FrameCount; ++i) { D3D12_CONSTANT_BUFFER_VIEW_DESC cbvDesc{}; cbvDesc.BufferLocation = cb->GetGPUVirtualAddress() + i * cbSize; cbvDesc.SizeInBytes = cbSize; // 256 的倍数 device->CreateConstantBufferView(&cbvDesc, CD3DX12_CPU_DESCRIPTOR_HANDLE(cbvHeap->GetCPUDescriptorHandleForHeapStart(), i, cbvIncrement)); }
第四步与第五步:根签名与每帧更新。 根签名加一个常量缓冲根参数(3.3 节的 register b0 与它对应),每帧写入时按帧号偏移:
// 每帧更新:写入第 frameIndex 个槽位 memcpy(cbDataBegin + frameIndex * cbSize, &worldViewProj, sizeof(worldViewProj)); // 录制命令时把整册堆绑定,再设根参数指向当前帧槽位 cmdList->SetDescriptorHeaps(1, cbvHeap.GetAddressOf()); cmdList->SetGraphicsRootDescriptorTable(0, CD3DX12_GPU_DESCRIPTOR_HANDLE(cbvHeap->GetGPUDescriptorHandleForHeapStart(), frameIndex, cbvIncrement));
跑起来:三角形绕屏幕中心匀速旋转。旋转的每一度,都走完了"CPU 写内存 → 描述符定位 → GPU 读取 → 顶点变换"的完整油路。
结果解读与两个追问
实验通了,值得停下来回答两个高频追问。为什么槽位要按帧环形? 直接覆盖上一帧数据,若 GPU 还没读完,就会画面抖动或数据撕裂——环形偏移用空间换同步的简单,而"哪帧才安全可覆盖"的精确答案由栅栏给出,第六章展开。为什么不把矩阵直接塞进绘制调用? 绘制调用是录进命令流的,内容固定;每帧变化的数据必须走资源通路,这就是常量缓冲存在的理由——它是指令与数据两个世界的分界线。
常见疑问:数据量很小时也要走描述符吗
不一定,D3D 12 给了三档绑定成本,数据体量决定走哪档。第一档是根常量(Root Constants):把几个 32 位值直接塞进根签名里,随命令流一起提交,没有资源、没有描述符——适合只传一两个偏移量或索引的场景。第二档是根描述符(Root CBV):直接把缓冲的虚拟地址放进根参数,省掉描述符表的一次间接,适合单个常量缓冲这种"就一间房"的引用。第三档才是本节主角描述符表:从堆里切一段指过去,一次绑定铺开一排资源——纹理数组、材质库这类"一整条街"的引用只有它划算。三档的取舍逻辑与 PSO 一脉相承:绑定也是有带宽的,根签名越大,每次绘制要摊的签名成本越高。实验里走描述符表,是为了把完整油路走一遍;真实项目里常常三种混用——高频小数据走根,大宗资源走表。实际项目常见的分工是:动画混合权重这类两三个标量走根常量,相机矩阵这类单一缓冲走根描述符,材质贴图阵列走描述符表——一条命令流里三档并存,各按体量认领成本。
本节要点回顾
- 描述符 = 地址 + 解读规则,堆是票据册,根签名是要票清单——三个词从此不再是天书。
- 16 字节对齐是铁律:C 结构体与 HLSL 常量缓冲的排布必须显式对齐,错位不报错只出诡异数值。
- 环形缓冲是每帧更新的标准姿势,空间换同步简单,精确同步靠栅栏。
- 初始化期把票据排好、运行期只换槽位——"预排布、快绑定"是 D3D 12 数据通路的总纲。
油路通了,顺路接上电路:UI 文本与二维图形——为什么它们不该用三角形硬拼,下一节见分晓。