4.5 慢查询会诊实录
4.5 慢查询会诊实录
本节摘要:一条涉及连接、过滤与按周聚合的业务查询跑了四秒,业务方希望"再快一点"。本节完整记录会诊四步——读计划、找症结、动手术、验疗效——最终把它压到八十毫秒。四秒到八十毫秒之间没有任何魔法,只有四节知识的合围。
案例背景与初始查询
主线案例进入深水区:业务方要求按周统计"大额退款里 VIP 用户的金额走势"。查询涉及两张表——列式交易表与用户维表:
SELECT date_trunc('week', t.trade_time) AS 周, u.vip_level, sum(t.amount) AS 退款金额 FROM trades_clean t JOIN users u ON t.user_id = u.id WHERE t.status = 'refunded' AND t.amount > 500 AND u.vip_level >= 3 AND t.trade_time >= TIMESTAMP '2024-01-01' GROUP BY 周, u.vip_level ORDER BY 周;
实测耗时约四秒。数据量在千万行级,四秒不算灾难,但这条查询要嵌进定时报表反复跑,且业务方暗示后续数据还会涨。会诊开始。
第一步:读计划,找大头
EXPLAIN ANALYZE -- 前述查询原样放入 ;
计划输出里三个信号值得圈出来。其一,哈希连接的构建侧选了用户表(对),但探测侧——也就是交易表的输入行数——是全表扣掉状态过滤后的行数,大额与 VIP 两个条件都还没生效:过滤发生在连接之后,几千万行白白流过探测端。其二,时间条件的下推生效了,扫描端确实跳过了行组,这一项没问题。其三,估算行数与实际行数偏差不大,统计没有失真,代价决策可信。
症结明确:过滤时机太晚。vip_level >= 3 写在连接条件之外,优化器没有足够信息提前收窄交易表的流。这是写法问题,不是引擎问题。顺便记下会诊的第一条元规则:三个信号里先看"有没有白流的行",再看"下推有没有生效",最后才看估算准不准——前两条是结构性问题,改动小收益大;第三条是情报问题,修正起来绕得远。按这个顺序看计划,多数会诊在第一步就能锁定方向。
第二步:动手术——让数据先变瘦
手术分两刀。第一刀,把 VIP 条件从连接后的过滤改成"先挑出 VIP 用户子集",用小表驱动大表:
WITH vip_users AS ( SELECT id, vip_level FROM users WHERE vip_level >= 3 ) SELECT date_trunc('week', t.trade_time) AS 周, u.vip_level, sum(t.amount) AS 退款金额 FROM trades_clean t JOIN vip_users u ON t.user_id = u.id WHERE t.status = 'refunded' AND t.amount > 500 AND t.trade_time >= TIMESTAMP '2024-01-01' GROUP BY 周, u.vip_level ORDER BY 周;
第二刀,确认金额与时间条件的顺序不影响(它们在同一张表上,引擎会合并下推),再把 SELECT 里用不到的列确认无冗余——本例本来就只有三列,无需裁剪。改写后实测:约一点二秒。有改善,但离理想还远——大头变成哈希连接本身:千万行探测端还是要过一遍。
第三步:布局手术——行组的又一次红利
改写把逻辑理顺了,接下来动物理布局。诊断依据是 Zone Maps 的剪枝报告:按时间过滤后仍要读取的行组太多,因为这张表当时是按原始顺序导入的,时间列在每个行组内跨度极大。按时间重排数据再入库,每个行组的时间跨度收窄,"大额且今年"的条件能整组整组地跳:
-- 按时间排序后重建工作表(一次性代价,换长期收益) CREATE TABLE trades_ordered AS SELECT * FROM trades_clean ORDER BY trade_time; -- 后续查询改指向新表;老表确认无误后删除
重建后再跑同一查询:约两百毫秒。扫描端读的行组只剩零头,连接与聚合的输入量断崖式下降。
第四步:验疗效与收尾
最后一步是固化成果。既然这条查询要反复跑,就把"周、VIP等级"粒度的中间结果物化成小表,定时刷新一次,报表查询只碰几万行的小表——最终报表查询稳定在八十毫秒以内:
CREATE TABLE refund_weekly_vip AS SELECT date_trunc('week', trade_time) AS 周, u.vip_level, sum(t.amount) AS 退款金额 FROM trades_ordered t JOIN vip_users u ON t.user_id = u.id WHERE t.status = 'refunded' AND t.amount > 500 GROUP BY 周, u.vip_level;
物化这步还留了一个小尾巴:刷新的职责归谁。答案在数据上游——新交易批次落库的流程末尾追加一条刷新语句,把"报表表的新鲜度"绑定在"数据入库"这个事件上,而不是绑在某个定时器上。数据不动表就不动,动了就立刻跟上,新鲜度语义因此变得无比清晰:报表永远不比库旧。
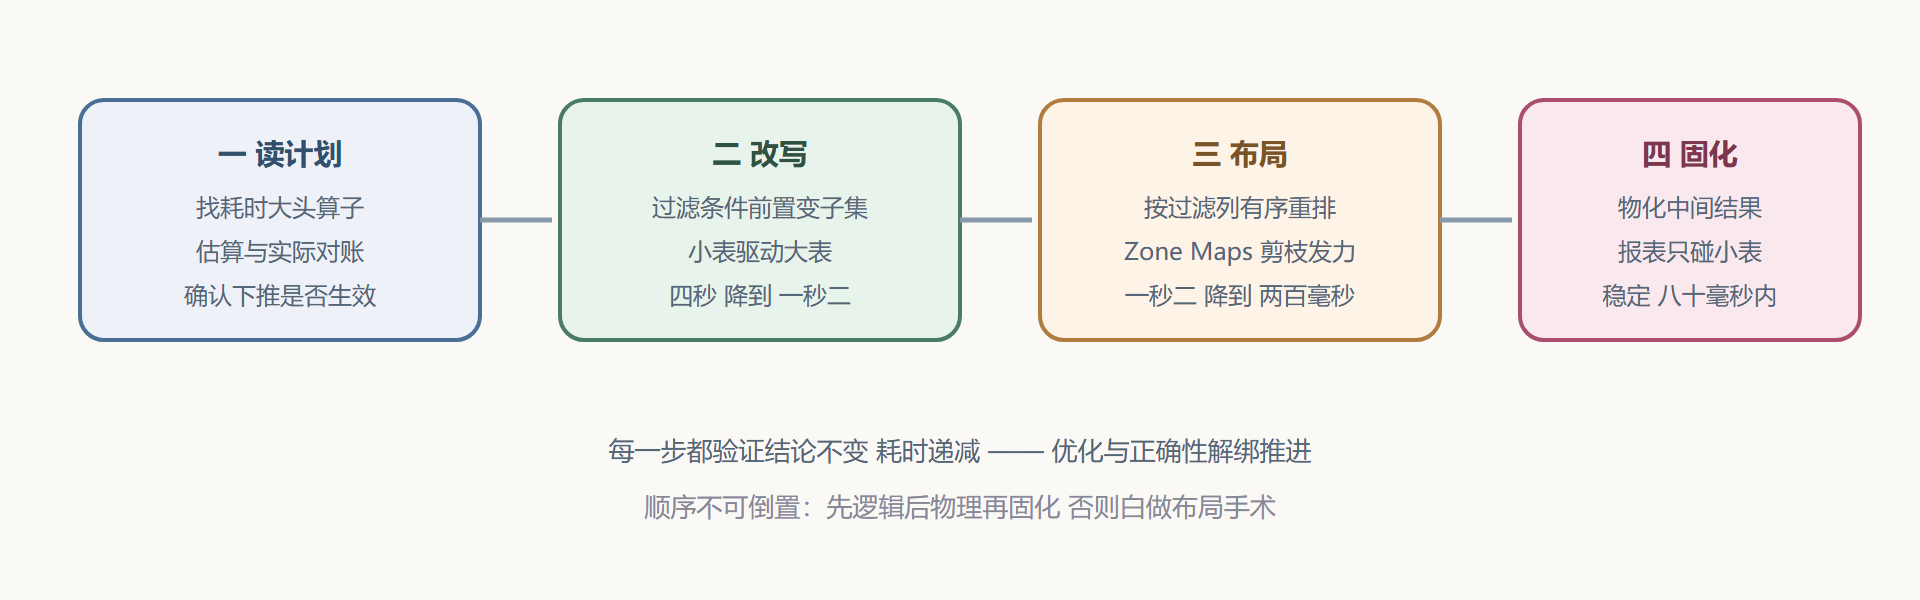
图4-5 会诊路线:四步闭环
复盘与变式
四秒到八十毫秒的每一步都对应一节知识:读计划是第4.2节,过滤前置与子集驱动是第4.4节的小表驱动思想,有序重建是第3.1节布局加第4.4节剪枝,物化是"预计算换实时"的经典取舍。会诊心法可以浓缩成一句话:先看计划再动手,先逻辑后物理,每步都留着对账的基线。这句话里最容易被忽略的是"对账"——每步手术后都跑一遍结果对比(行数、总额、抽样明细),确保数字纹丝不动;速度的收益如果伴着结果漂移,就不是优化而是事故。
三个变式供迁移。其一,连接爆炸型:探测侧降不下来时,先给大表做按连接键的部分物化。其二,聚合爆炸型:按高基数列聚合时,套用第2.4节的两级聚合再叠加本节布局手术。其三,报表固化型:任何反复执行、结果可接受分钟级延迟的查询,都值得问一句"能不能物化"——延迟换速度,是分析系统里最便宜的交换。把四步路线加三个变式合起来,其实是一张覆盖九成慢查询的会诊地图;地图之外剩余的一成,多半要回到第7.1节的三层排查去逐层过——会诊是精确诊断,三层排查是全身体检,两套工具互补而非互斥。
会诊的预备动作与禁忌
四步闭环之外,会诊还有自己的纪律,比技巧更保命。预备动作两条:留基线——动任何手术前,先跑一遍原查询记下耗时与结果样本(结果前一百行),否则你连"优化后结果没变"都无法证明;一次一刀——第4.2节的改写、本节的布局、物化固化,每做一步重测一次,两步一起做的会诊永远说不清哪步起效。禁忌三条:忌在业务高峰对生产数据做重排重建(布局手术是重负载动作,挑窗口期);忌把会诊结论直接当普适真理(这条查询的手术未必适配别的数据分布,迁移前重走四步);忌跳过读计划直接凭经验开方——四秒的慢有四种病根,凭感觉开对处方是赌博。纪律看着啰嗦,它们存在的原因只有一个:会诊最大的事故不是"没治快",是"治快了但结果悄悄变了"。
本节要点回顾
- 会诊四步:读计划、改写、布局、固化——顺序不可倒置。
- 过滤时机是第一症结:条件留在连接之后,千万行白流;提前收窄子集立竿见影。
- 物理有序激活剪枝:按过滤列排序重建表,让 Zone Maps 从摆设变主力。
- 物化收尾:反复执行的查询固化成小表,用分钟级延迟换毫秒级响应。