4.4 索引机制:Zone Maps与ART
4.4 索引机制:Zone Maps与ART
本节摘要:列存引擎的索引哲学和行式库不同:Zone Maps 免维护、随数据自动生长,负责"整块跳过";ART 索引是唯一的传统树索引,负责约束与点查。本节讲清两者的分工、各自的失效场景,以及"为什么大多数分析查询不需要你建索引"。
反直觉的起点:先别建索引
从行式数据库过来的人,见到慢查询的第一反应常是"加个索引"。在列式分析引擎里,这个直觉多数时候要按下。原因在第3.1节已经埋好:扫描本来就是按列段批量进行的,过滤靠段头统计整块跳过,聚合靠向量化批量算——B 树式索引的"从一行快速定位到另一行"的能力,在批量扫描场景里根本没出场机会。索引在 DuckDB 里是精细武器而非万金油:两种索引、两种职责,先分清场景再动手。
Zone Maps:自动生长的剪枝地图
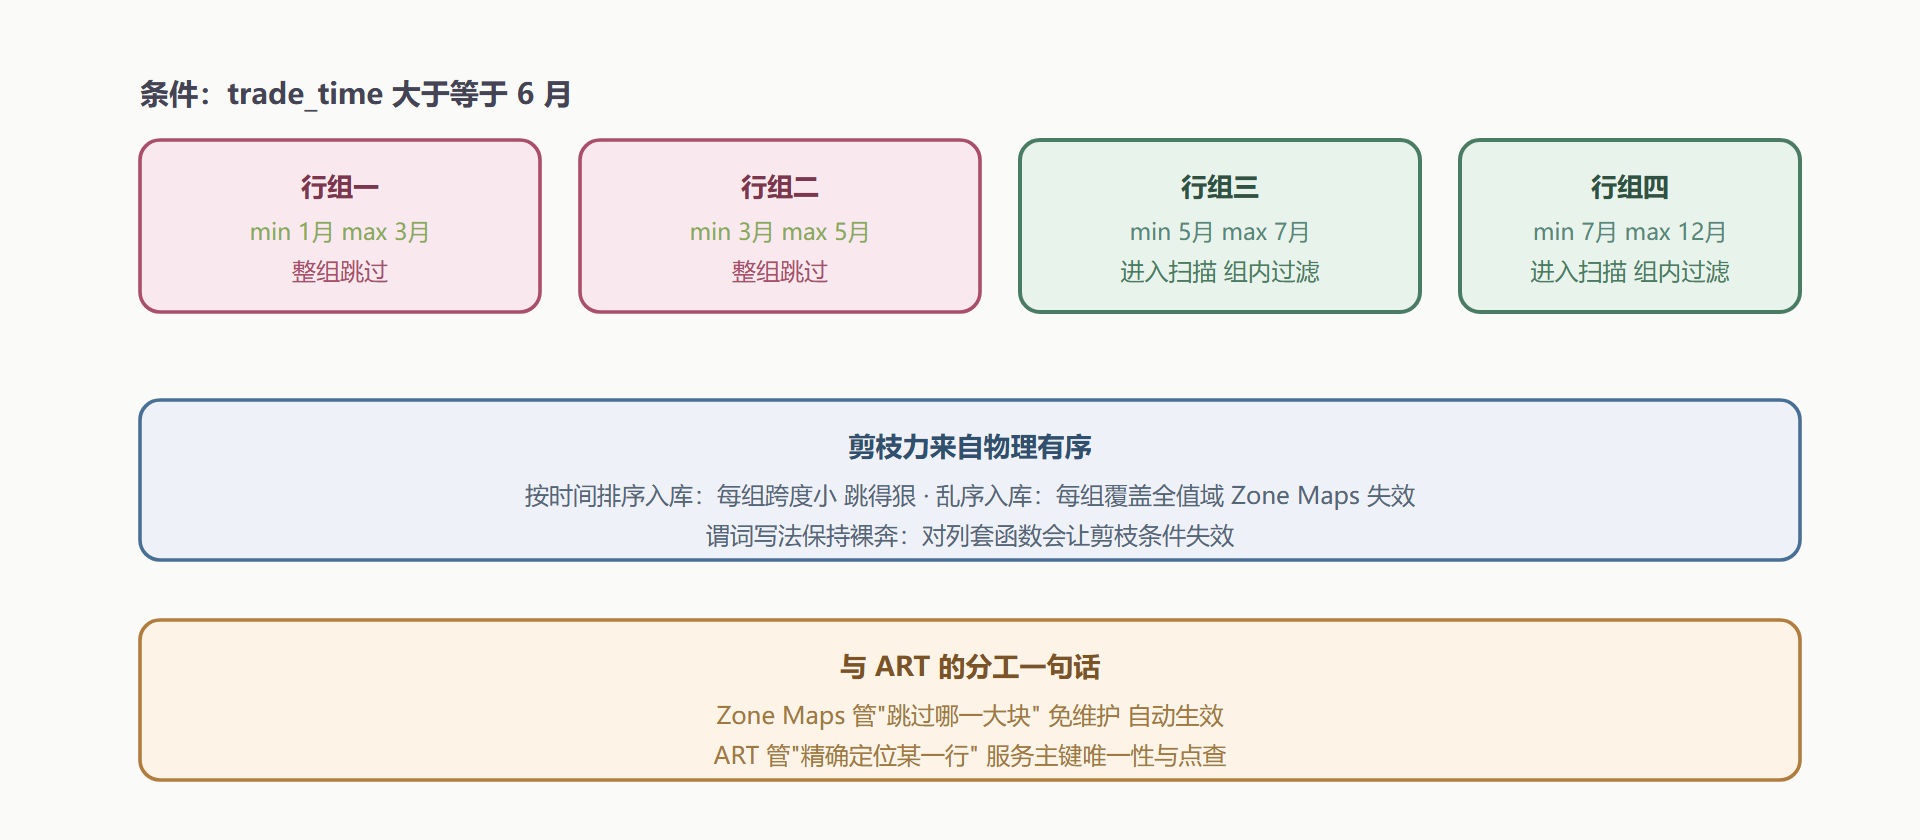
Zone Maps 不是你建的索引,而是存储层的天然赠品:每个列段的 min、max 等统计(第3.1节讲过)在查询时被自动利用。查询带着 trade_time >= 某日 进场,扫描器先看每个行组该列的统计:最大值都小于某日的行组直接整组跳过。没有维护成本、不占额外空间(统计本来就在段头)、对一切范围条件自动生效——这是分析场景里性价比最高的"索引"。它还有一个常被误认的亲戚:分区目录(第3.4节)看似也在"剪枝",但那发生在文件层、靠路径匹配;Zone Maps 发生在块层、靠数值比较——两级各干各的,一个粗而便宜,一个细而免费,叠加使用互不冲突。
它也有软肋:统计的剪枝力取决于数据的物理排布。时间列若按时间顺序写入,每个行组的时间跨度小,一跳一大片;若写入顺序乱七八糟,每个行组的 min-max 都覆盖全值域,Zone Maps 就退化成摆设。这就导出一个重要技巧:对最常过滤的列做有序写入(例如按时间排序后再入库),剪枝效率立刻体现。同理,对列做函数包裹(对时间截断后再比较)会让剪枝条件失效——保持谓词"裸奔"到扫描端。
图4-4 Zone Maps 剪枝示意
ART:约束与点查的唯一树
ART 是一种自适应基数树,DuckDB 里唯一需要显式创建的索引类型。它的主场有两个。主场一:约束。主键与唯一约束背后就是 ART——插入时用它快速判重,这解释了为什么给大表加主键会让导入变慢(每行都要查一次树),也解释了为什么分析场景常常干脆不设主键、把唯一性校验放在入库前的清洗阶段。主场二:点查与少量范围查。从百万行里找某几个键值,ART 直达目标行,比全表扫描划算。两个主场之外还有一块边缘地带值得知道:连接的小构建侧如果反复复用,引擎会自动为它维护哈希结构——这属于执行层的临时结构,不占你的索引名录,也不需要你建,知道它的存在是为了不重复造轮子。
-- 约束场景:唯一性背后是 ART(导入因此变慢,需要权衡) CREATE TABLE users (id BIGINT PRIMARY KEY, vip_level INTEGER); -- 点查场景:手工为高频精确查找建 ART CREATE INDEX idx_user ON trades_clean (user_id); SELECT * FROM trades_clean WHERE user_id = 884213; -- 观察索引是否存在 SELECT index_name, table_name FROM duckdb_indexes();
三个语句三种角色:约束是声明式的(引擎自动配 ART),手工索引是负载驱动的(先证明点查高频再动手),目录查询是审计用的(接手老库先盘点)。
判断口诀可以压缩成一句:过滤一大片靠 Zone Maps 与有序布局,定位某几个靠 ART。分析查询九成是前者;后者主要出现在"点查补充信息"的混合负载里。给每张表都套一排索引的行式习惯,在这里既浪费导入时间又帮不上扫描——第4.5节的会诊里你会看到,提速靠的是布局与改写,不是索引。口诀背后还有一个值得内化的视角转变:行式世界里索引是"给查询铺的路",列式世界里布局本身就是路——你要做的不是多修路,而是把数据摆到离路近的地方。
主线案例的索引决策
主线案例的典型查询是按时间过滤加按用户聚合——全是"一大片"型,Zone Maps 配合按时间有序入库已经足够。唯一考虑过 ART 的场景是退款核查:业务方偶尔要按用户号精确调单笔交易。解法不是给大表建索引,而是把"疑点用户清单"(几十行)先挑出来,再与主表做半连接——小表驱动大表,扫描端照样跳块。索引决策至此闭环:能靠布局的不建索引,能靠小表驱动的不动大表。这个决策还有一个时间维度值得记住:布局是随数据落定一次到位的,索引是随负载生长的——数据规模翻十倍后,去年合理的索引决策未必还成立,把"索引盘点"放进季度体检清单(第7.3节的资产化思路)比一次决策管得久。
混合负载的点查实战
"定位某几个"的场景值得走一个完整例子,因为它最容易做错方向。需求:风控给出五十个疑点用户,要求调出他们在全年交易里的全部退款记录。行式本能会想"给 user_id 建索引";按本节思路走小表驱动:
-- 疑点清单小表(五十行) CREATE OR REPLACE TABLE suspect AS SELECT * FROM (VALUES (884213), (901472), (775302)) AS t(user_id); -- 小表驱动大表:扫描端对大表只做一遍带跳块的扫描 SELECT t.user_id, t.trade_time, t.amount FROM trades_clean t JOIN suspect s ON t.user_id = s.user_id WHERE t.status = 'refunded';
两种方案的成本结构差异很大:给千万行大表建 ART,要付一次全量构建(分钟级)加持续的导入开销(每行判重),换来点查加速——但这批疑点只用这一次。小表驱动方案的构建成本是五十行的哈希表,大表扫描靠 Zone Maps 跳块,整体秒级。一次性点查走小表驱动,常驻点查才值得 ART——判断的标尺是"这个查找动作会重复多少次"。这个例子还顺带演示了 VALUES 子句造临时小表的技巧,排查与核查场景里出场率很高。
索引决策流与两条补充
把本节的判断力压成决策流:查询形态是"过滤一大片"还是"定位某几个"?前者——检查布局(过滤列有序入库了吗)与谓词写法(有函数包裹吗),基本到此为止;后者——问复用频次,一次性走小表驱动,常驻再建 ART;要加约束——权衡导入速度损失,大批量导入的表考虑"先导后约束"或清洗期校验。两条补充让决策流完整。其一,索引信息要查目录: duckdb_indexes 这类目录视图能看到当前库里有哪些索引——接手别人的库文件时先看一眼,别被历史遗留的索引拖慢了你的导入。其二,删索引和删表不同:索引是附加结构,删除即回收,不影响数据本体;重构索引策略可以随时推倒重来,没有心理负担。
本节要点回顾
- 先别建索引是常态:批量扫描场景里,B 树式点查索引多数没有出场机会。
- Zone Maps 免维护:段头统计自动剪枝,剪枝力取决于物理有序度。
- ART 只管两件事:约束判重与点查定位;主键会让大表导入变慢。
- 口诀:一大片靠布局,某几个靠 ART;能靠布局的不建索引。