8.3 性能计数器调优演练
8.3 性能计数器调优演练:从"有点慢"到"改这一行"
本节摘要:性能调优的第一手数据来自处理器自带的性能计数器。本节完整演练一次:一段在开发板上跑得"说不清哪里慢"的数组处理任务,如何用三个基础计数锁定瓶颈、如何设计对照实验排除干扰、如何把计数特征翻译成数据布局改动,以及改动后如何验证收益。全套方法可直接迁移到任何带计数器的目标上。
背景:一个说不清的慢
任务是一段经典的图像邻域滤波:对一幅按行列存储的灰度图,每个像素取上下左右邻居的平均值。裸机环境直接跑在开发板的应用核上,开发者只留下一句抱怨:"比参考实现慢了一大截,感觉核不行。"没有剖析、没有对照,只有体感——这是性能工作的常态起点。板上的核支持标准的可编程性能计数器,操作系统把它封装成了剖析命令,一切观测条件齐备。
操作:三层剖析,逐步收窄
第一层:先量体温——每周期指令数。用 7.3 的入门三计数跑一遍:
# 剖析命令输出(按真实工具输出形态改写示意) # perf stat -e cycles,instructions,l1d_misses ./filter 52,410,833 cycles # 周期计数 31,862,091 instructions # 退休指令 2,144,687 l1d_misses # 一级数据缓存未命中 IPC = 31,862,091 / 52,410,833 ≈ 0.61 # 每周期指令数 每千指令未命中 ≈ 2,144,687 / 31,862 × 1000 ≈ 67.3
每周期指令数远低于这颗顺序核的满值一——流水线大量时间在等待;同时每千条指令近七十次一级缓存未命中,远超健康线。瓶颈画像初步成形:不是"核不行",是"核总在等内存"。
第二层:对照实验,排除嫌疑。慢未必是布局问题——算法写糟、编译没优化、缓存本身太小,都会呈现类似计数。设计两个对照:把同一算法改为按行复制到一块紧凑连续的缓冲区再处理(数据量相同、布局更紧凑),未命中率显著下降——说明不是缓存容量不够,是访问模式与布局不友好;把编译优化等级提高重跑,指令数下降但未命中特征不变——说明不是代码质量问题。嫌疑收窄到数据布局。
第三层:定位结构,找到那一行。邻域滤波天然按列跨步访问:处理每个像素要碰上下两行——按行存储的图像里,垂直邻居每次访问都隔着整行宽度,缓存行装进来的邻居数据利用不充分。锁定结构后,改动选项有三:换存储顺序(转成按列处理局部条带)、分块处理(把图像切成宽条带,条带内的行边界留在缓存里)、预处理搬运(先把感兴趣的窗口聚成连续块)。考虑代码侵入度,选择分块处理:一次处理若干行,块内垂直邻居的缓存行在下个像素立刻复用。
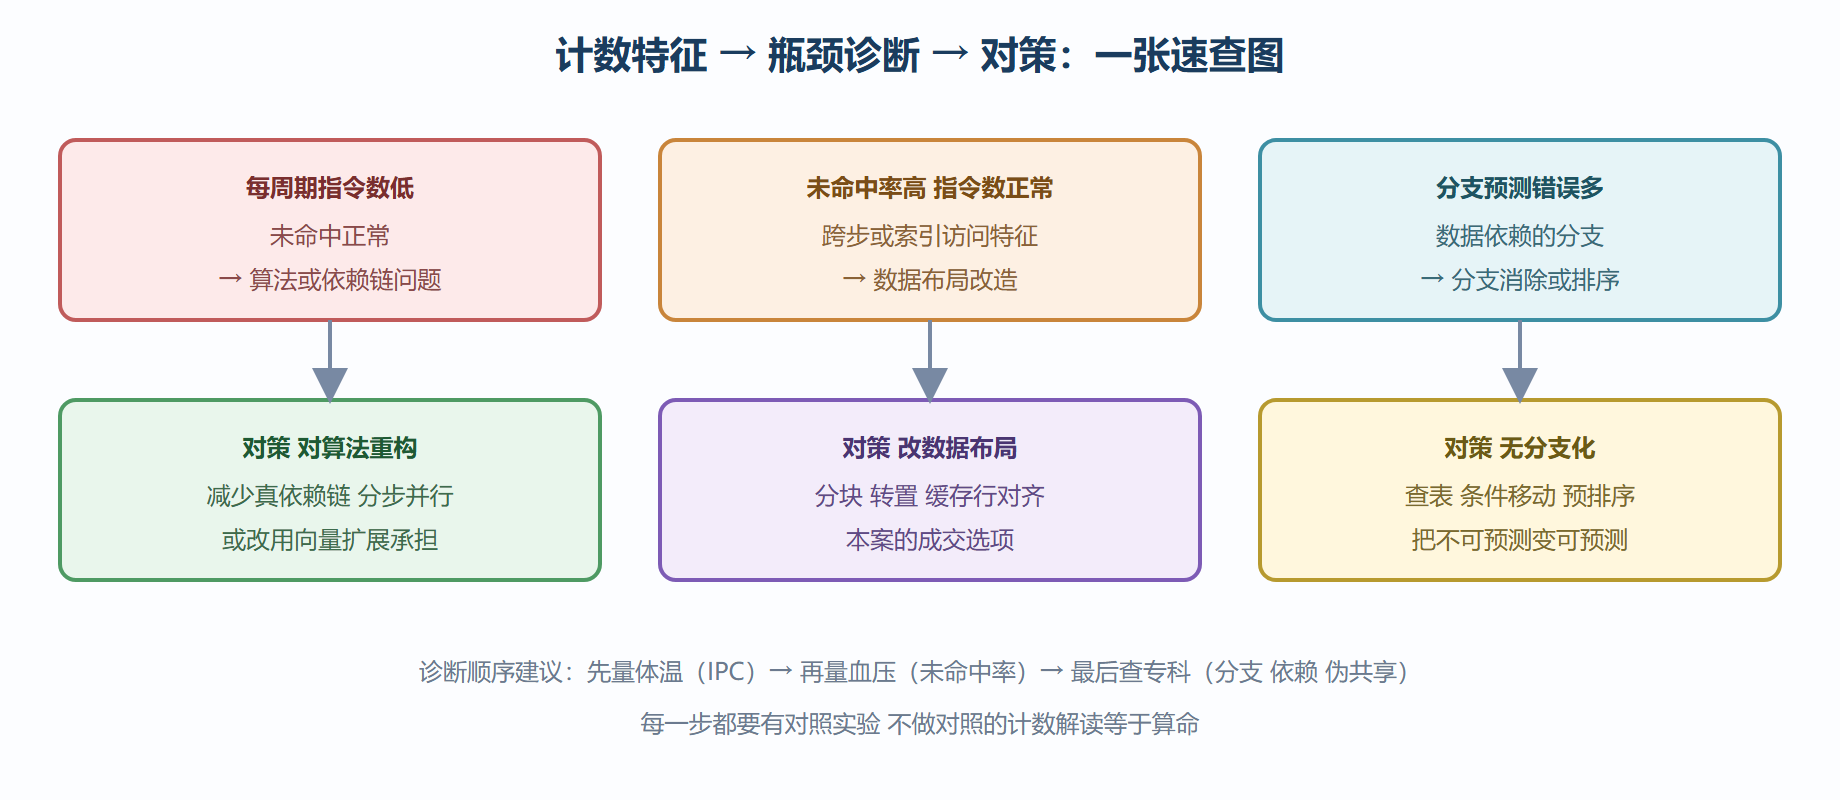
瓶颈特征与对策映射表
结果:一行改动级别的收益
分块改动落地后重跑剖析:每千条指令的一级缓存未命中从近七十次降到二十上下,每周期指令数从大约零点六回升到零点九附近,总运行时间缩短四成出头。改动本身只有十几行——尺寸计算加两层循环重排,算法语义一字未动,全部回归用例原样通过。这就是数据布局改造的典型气质:不动算法、不动硬件,只把"数据怎么躺"安排明白。
解读与变式:方法比结论值钱
本案的三步法可以原样迁移:先量体温定方向(计算型还是等待型)、再设计对照排嫌疑(算法、编译、容量逐个隔离)、最后按特征对号入座。三个变式值得预演:其一,若未命中率在多核环境居高不下且缓存远未装满,嫌疑应转向 4.4 的伪共享——对策从分块换成缓存行对齐;其二,若向量核上跑出类似计数,先查向量利用率(车道是否吃满),再查访存形态是不是索引式(6.1 的最贵档);其三,若每周期指令数低而未命中正常,多半撞上真依赖链——这时该找的是算法重构或向量化,布局改造帮不上忙。
⚠️ 常见坑:拿着单次运行的计数就下结论。缓存与分支的历史状态会让单次数据带噪声,正规做法是多次运行取中位数、改动前后用同一随机种子同一输入对照——性能数字的科学性,不比任何实验科学低。
把方法沉淀成团队资产
一场演练的价值有限,把方法变成团队资产才算真正收官。建议沉淀三样东西:一份事件速查卡——常用的计数器事件、健康区间、异常特征对照表,贴在每个开发工位(本节的映射图可以直接当底稿);一套剖析脚本——从清零配置、跑负载、读数到生成对比表的完整流程脚本化,让"跑一次剖析"的成本降到一条命令,成本越低、用得越勤;一本决策台账——每次调优的"计数特征、假设、改动、结果"四元组记录,季度回看就能发现团队代码的模式性问题(比如某类模块总在跨步访问上翻车),这是从个案经验到组织能力的跃迁。8.2 的排错档案与 8.4 的覆盖率闭环,本质上都是同一件事:让数据与决策留下痕迹。
常见问题快答
问:剖析要不要在量产固件里常开? 轻量计数器可以常开(开销近零),用作运行健康监测——指标越界即告警;采样式深度剖析按需开启。把计数器当"车载仪表盘"而非"年检设备",是成熟团队的普遍做法。
问:优化后总时长没变,但瓶颈计数明明改善了,怎么回事? 瓶颈转移了。原来的瓶颈修好后,时间占比最大者换人——继续剖析新的最痛项即可。性能优化是多轮迭代,一轮只解决一个主要矛盾,指望一次改动解决全部问题通常会导致改得到处都是、哪都不深。
演练的复算练习:不看正文,自己推一遍本案的数字链条——从三个原始计数算出每周期指令数与每千指令未命中,再倒推改动后的预期数字,最后与实测对账。能独立复算,说明剖析的"读数—换算—结论"链路已经属于你;复算卡壳的环节,就是下次上手时要慢下来的地方。
本节要点回顾
- 三步法:量体温(每周期指令数)、排嫌疑(对照实验)、对号入座(特征映射对策);
- 本案链条:等待型画像 → 高未命中 → 跨步访问结构 → 分块处理 → 未命中降三倍、时间砍四成;
- 对照实验是剖析的灵魂:不做对照的计数解读等于算命;
- 数据布局是性价比之王:不动算法不动硬件,只安排数据怎么躺;
- 变式预案:多核先查伪共享、向量核先查车道利用、依赖链找算法而非布局。
最后一场实战留给质量兜底——验证方法与功耗面积性能的总谈判。