1.4 第一铲试金:跑通 yesno 全流程并读懂报表
1.4 第一铲试金:跑通 yesno 全流程并读懂报表
本节摘要:yesno 是 Kaldi 自带的最小数据集,每条录音只含若干个"yes"与"no"。用它完整走一遍数据准备、特征提取、模型训练、解码与评估,并把日志逐段读明白。本节是第 1 章的实战收口,也是后续所有章节的"缩微沙盘"。承接 1.3 的目录地图,通往第 2 章原理地基。
从按下回车到看到成色报表
场景代入:你已经按前两节装好了场子、拿上了地图,现在站在最小的矿区前。这个矿区小到什么程度?全部家当是一批短录音,每条由八个词组成,每个词要么是 yes 要么是 no,同一个说话人念的。任务简单:听录音,输出这八个词的序列。正因为任务简单,产线上任何一环出问题都会立刻暴露,它是理想的试金石。
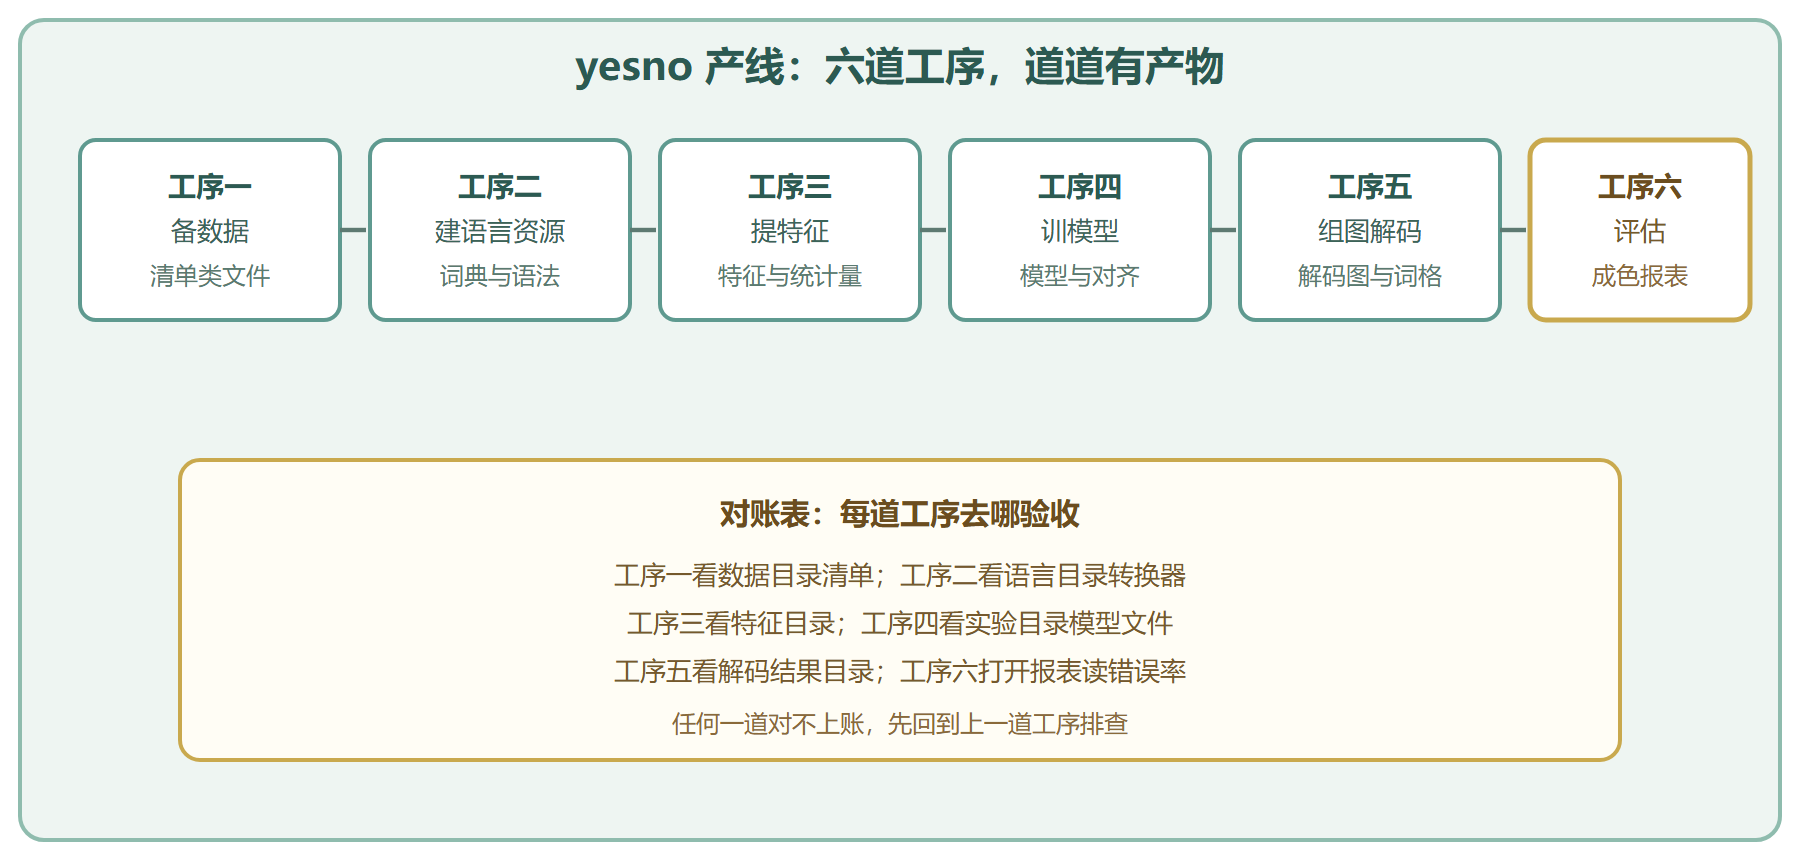
图 yesno 产线六道工序与产物对账
开机:一次跑通
背景交代完,动手。进入食谱目录,主脚本一键跑完全部六道工序:
cd ~/kaldi-field/kaldi/egs/yesno/s5 ./run.sh 2>&1 | tee run.log # 首次运行会自动下载数据集(几兆字节); # 全程几十秒到几分钟,取决于机器
日志按工序滚动,几处关键台词值得划线。特征阶段会打印每条话语的帧数统计;训练阶段会输出似然值随迭代轮次上升的表格;解码阶段安静地生成词格;最后打分脚本汇总出错误率。似然值一路走高、错误率收在低位,就是产线健康的标志。
# 训练日志里的健康信号(节选) # 第 1 轮迭代:平均对数似然 -xx.x,之后逐轮上升 # 直到最后若干轮基本走平——收敛 # 打分阶段的收尾输出(节选) # %WER 0.00 [ 0, 232, 30, 0, 0 ] # 含义:错误率 0,三十条测试话语共 232 个词, # 替换 0、删除 0、插入 0
看报表:成色鉴定
# 解码与打分产物在实验目录下 ls exp/mono/decode_test_yesno # 预期输出(节选): # lat.1.gz log/ wer_10_0.0 wer_11_0.0 ... scoring/ # 打开一份成色报表 cat exp/mono/decode_test_yesno/wer_10_0.0 # 预期输出: # %WER 0.00 [ 0 / 232, 0 ins, 0 del, 0 sub ] # 首行是汇总:232 个参考词,零错误 # 后续若有个别错句,会按 误识 / 参考 成对列出
结果解读要冷静:错误率为零不代表你训练出了通用识别系统。yesno 的测试集与训练集来自同一批录音、同一个说话人,词汇表只有两个词加静音,这更像"用已知成分的矿样校准仪器"。它验证的是产线本身:六道工序全部跑通、产物齐全、指标可复现。
逐段日志判读表
跑通只是及格线,会读日志才算入门。六道工序在日志里各有标志性台词,把这张判读表收好,它同样适用于大型食谱:
| 工序 | 日志关键词 | 健康判据 | 出问题的样子 |
|---|---|---|---|
| 备数据 | 话语数统计、排序提示 | 话语数与录音条数一致 | 条数对不上、校验脚本报错 |
| 建语言资源 | 生成转换器的进度行 | 转换器文件全部生成 | 词典行格式非法被拒 |
| 提特征 | 每条话语的帧数 | 帧数为正、无超时警告 | 某条音频读不出或时长为零 |
| 训模型 | 迭代轮次与似然值 | 似然逐轮上升后走平 | 似然不升反降或直接崩溃 |
| 组图解码 | 解码进度与束宽警告 | 每条话语都有输出 | 大量超时、束宽耗尽提示 |
| 评估 | 错误率汇总行 | 报表文件生成且数值合理 | 参考文本为空导致除零 |
训练阶段的似然值值得多看两眼。它是模型对训练数据"解释力"的打分,从很负的数起步,逐轮爬升,最后若干轮几乎不动,这就是收敛。如果爬到一半掉头向下,通常是数据或配置出了问题;如果第一轮就崩,多半是特征文件与清单对不上。养成"先看收敛曲线,再看错误率"的习惯,第 4 章调参时你会感谢这个习惯。
对齐产物也值得认识一下。训练结束后,实验目录里会多出对齐文件——它记录每一帧音频被分配给了哪个音素状态,相当于把矿石逐粒贴上了成分标签。下一代的训练以它为起点,越贴越准,这是传统流水线"逐级精炼"思想的具体体现。
第一次事故处理演练
假设跑挂在数据准备阶段,报错说清单文件与实际音频对不上。处置顺序如下:第一步看报错最后几行,确认它指向哪个文件哪一行;第二步检查清单与音频目录,通常是文件名拼写不一致或有多余文件;第三步跑数据校验脚本让它指出所有问题,而不是改一处再跑一次碰下一处。这套"看尾部、查两头、整体校验"的三步法,适用于绝大多数食谱事故。
# 事故演练:故意制造一处不一致再修复(在副本数据目录操作) # 第一步:看校验脚本怎么说 utils/validate_data_dir.sh data/train_yesno # 预期输出:指出具体哪个清单的哪一项不合法 # 第二步:修复后让目录自愈(重建反向索引与排序) utils/fix_data_dir.sh data/train_yesno # 预期输出:删除若干不一致条目的提示,条目数应为零或个位数
⚠️ 常见坑:看到零错误率就调大任务难度,直接跳到大语料食谱。更稳的路径是先在 yesno 上做变式实验,把"改参数、看变化"的肌肉记忆练出来,再去碰动辄几小时的训练。
变式:改一个秤砣再称一次
解码时声学分数与语言分数的配比是个可调的"秤砣"。默认配比不一定是任务最优,试几个组合感受权衡:
# 用不同的语言模型权重重打分(示意:权重从小到大) for wgt in 5 10 15; do local/score.sh --lm_weight $wgt data/test_yesno \ exp/mono/decode_test_yesno done # 然后比较各权重的报表文件, # 复杂任务里错误率会随权重变化画出一个 U 形, # 最优配比在 U 形底部
变式实验的价值不在结果本身,而在建立因果感:改一个参数,看一个指标,知道谁动了谁的奶酪。这套"改、跑、看"的循环,会贯穿第 4、5、6 章的调参工作。
再加一个更有意思的变式:让 yesno 多训一代模型。yesno 的主脚本默认停在单音素,你可以手动接续三音素训练,再各解码一次,比较两代模型的报表。任务太简单时两代差异可能为零,但操作本身把"下一代模型以上一代对齐为起点"的接力关系演了一遍——这正是第 4 章要展开的核心机制,先在沙盘上留下手感。
第一铲的收成
- 沙盘意义:yesno 是整条产线的缩微模型,六道工序与大型食谱一一对应,术语与目录结构完全同构。
- 健康信号:似然逐轮上升、错误率报表生成,两条信号确认产线无恙。
- 正确心态:零错误率是仪器校准,不是矿脉品位;下一步该补的是原理地基。
场子转起来了,但你可能还答不上"模型到底在算什么"。第 2 章进入矿石学,把音素、声学模型、语言模型、解码算法这些名词背后的机制讲透。