1.3 矿区地图:目录结构、食谱组织与脚本分工
1.3 矿区地图:目录结构、食谱组织与脚本分工
本节摘要:Kaldi 食谱目录有固定套路——主脚本按阶段调度,通用脚本库通过符号链接进场,数据放数据区、语言资源放语言区、产物放实验区。看懂这张地图,任何陌生食谱都能在几分钟内定位到关键文件。承接 1.2 的编译验收,为 1.4 的 yesno 实跑做导航。
一张目录表就是矿区地图
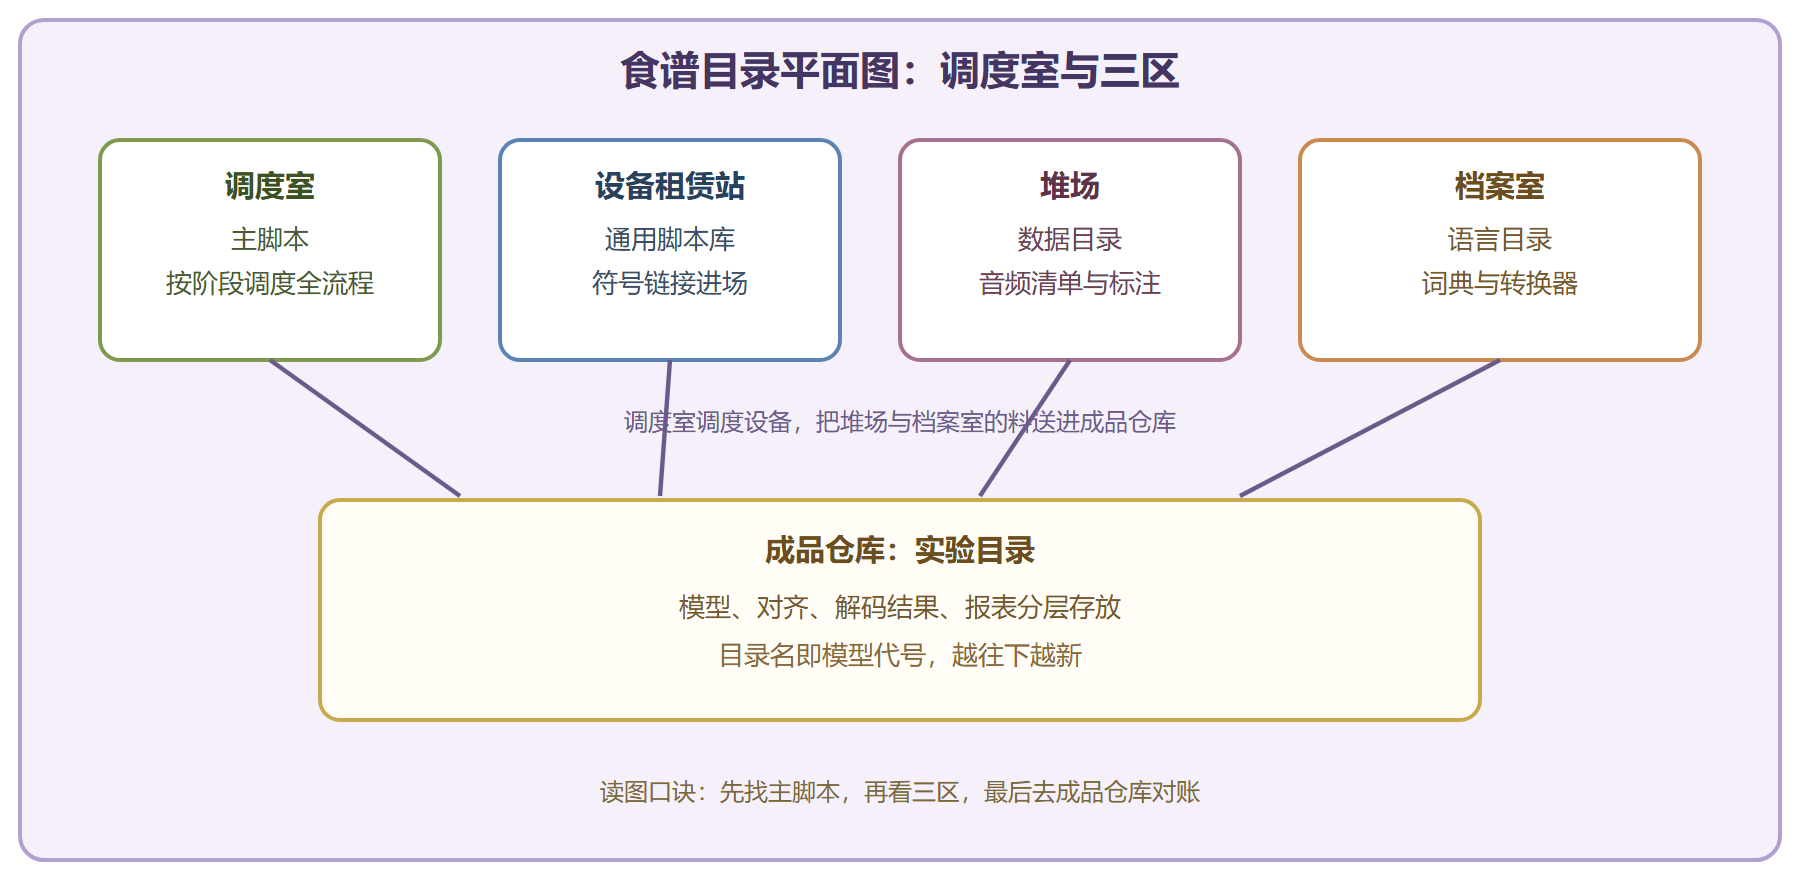
矿工下井前先看平面图,跑 Kaldi 前先看目录表。食谱目录的命名习惯是:数据集名下面跟一个版本号目录,数字越大脚本越新,通行做法是直接进最大号的那层。地图上有几座固定建筑:主脚本是调度室,通用脚本库是设备租赁站,数据目录是堆场,语言目录是档案室,实验目录是成品仓库。
图 食谱目录平面图与三条物流线
逛一遍真实目录
用最小食谱 yesno 当样板。先进目录、看建筑:
cd ~/kaldi-field/kaldi/egs/yesno/s5 ls -F # 预期输出(节选): # conf/ data/ exp/ local/ steps@ utils@ path.sh run.sh ... # 注意 steps 和 utils 末尾的 @ 符号:它们是符号链接, # 指向 kaldi/egs/wsj/s5 下的通用脚本库
几座建筑各司其职。主脚本负责全流程调度,你训练时九成的操作围绕它展开;本地目录存放这个数据集专属的准备脚本(下载、切分、打分);配置目录放特征与解码参数;数据目录存放"喂进产线的清单";实验目录存放"产线吐出的成品"。符号链接是精妙设计:所有食谱共享同一套通用脚本,升级一次全线受益,你也能改链接指向自己的副本做实验。
主脚本几乎都采用"阶段开关"写法,看懂这个模式,你就能自由控制流程进度:
# 主脚本常见的阶段化骨架(示意) stage=0 # 从哪个阶段开始跑 stop_stage=3 # 跑到哪个阶段停 . ./path.sh # 把工具可执行文件路径加入本次会话 if [ $stage -le 0 ]; then # 阶段 0:数据准备,产出训练与测试数据目录 local/prepare_data.sh fi if [ $stage -le 1 ] && [ $stop_stage -ge 1 ]; then # 阶段 1:特征提取,产出声学特征与归一化统计量 steps/make_mfcc.sh data/train_yesno fi if [ $stage -le 2 ] && [ $stop_stage -ge 2 ]; then # 阶段 2:训练单音素模型,产出实验目录下的模型与对齐 steps/train_mono.sh fi
阶段开关的价值在复跑:训练中断或只想重跑后半段时,改一个数字就能从断点续跑,不必从头再来。调试自定义流程时,也可以用它把新工序插进链条。
三区对账:数据、语言、实验
数据目录与语言目录最容易混淆,区分标准一句话:数据目录描述"这批音频是什么"(哪些文件、谁说的、说了什么),语言目录描述"这套语言怎么拼读"(音素集合、词典、语法规则)。实验目录则是唯一允许不断膨胀的地方,模型代号按训练轮次命名,新一代模型永远比上一代数字大。
# 看一眼实验区的分层(以 yesno 为例,跑完 1.4 后再看) ls exp # 预期输出: # mono mono_ali tri1 tri1_ali # mono 是单音素模型,tri1 是三音素模型, # *_ali 存放上一代模型给出的帧级对齐 # 数据区与语言区的关键文件分布 ls data/train_yesno data/lang # train_yesno 里:清单类文件(音频映射、转写、说话人) # lang 里:符号表与转换器(音素表、词典转换器、语法转换器)
设备租赁站里的常用工具
通用脚本库体量庞大,但日常高频的工具就那几件。提前认脸,后面章节用到时不必再翻目录:
| 工具类别 | 代表脚本 | 你会用它做什么 |
|---|---|---|
| 数据体检 | 数据目录校验脚本 | 检查清单文件格式与一致性 |
| 数据修复 | 目录修复脚本 | 顺带清理孤儿条目、重建排序 |
| 特征提取 | 特征生成与统计脚本 | 产出声学特征与归一化统计量 |
| 模型训练 | 单音素与三音素系列 | 逐级训练声学模型 |
| 对齐 | 帧级对齐脚本 | 把帧分配给音素状态 |
| 解码 | 通用解码脚本 | 用解码图识别测试语音 |
| 打分 | 错误率汇总脚本 | 生成成色报表 |
注意表里刻意没写具体文件名,因为不同食谱对同一工序可能有自己的封装,名字略有出入。找工具的正确姿势是"按工序找":在主脚本里定位到对应阶段的调用行,反手就能看到这件工具的名字与用法。主脚本因此是最好的教科书,读一个食谱的主脚本,胜过背十条命令。
还有一处小机关值得点破:环境脚本。食谱目录里那个环境设置文件的作用,是把源码区各子目录的可执行文件路径注入当前会话。这就是为什么你可以直接敲工具名而不写长路径。自己写独立脚本时,开头记得先引用它,否则工具名一个都找不到。
配置目录同样别忽略。特征参数(帧长、帧移、滤波器组个数)与解码参数(束宽、最大活跃路径数)都有默认值,食谱会把与默认不同的部分放进配置文件。改参数前先看一眼这里,能避免"我明明没改过,为什么结果不一样"的困惑——答案常常是食谱作者早替你改好了。版本号目录的命名也蕴含信息:同一食谱保留多个历史版本,越新的版本脚本越现代化,遇到老教程提到旧版目录名时,对照着看新版本往往能找到等价实现。
拿到一个陌生食谱,推荐三步上手法。第一步通读主脚本的阶段划分,把流程抄成一张工序单;第二步找到数据准备阶段,确认输入数据的形态与获取方式;第三步直奔实验目录,看看这个食谱默认训练到哪一代模型。三步走完,这个矿区对你而言就不再陌生。
# 验证环境脚本的效果(在食谱目录内执行) . ./path.sh which compute-wer || echo "未找到,检查环境脚本" # 预期输出:一个指向源码区可执行文件的路径, # 说明工具已可用;若打印未找到,说明环境脚本没被引用
⚠️ 常见坑:把符号链接当普通目录拷贝。用图形工具或某些同步工具搬食谱目录时,符号链接可能被展开成实体目录,导致脚本库版本错乱。搬动后用列表命令确认链接仍以箭头指向原处;链接失效的表现是主脚本一启动就报"找不到脚本"。
带走三样东西
- 读图口诀:先找主脚本定流程,再看数据区、语言区、实验区三处对账,遇到本地脚本就进本地目录找。
- 阶段开关思想:主脚本的阶段变量是断点续跑与流程插桩的钥匙,自己写流程时沿用这个约定。
- 共享脚本库意识:通用脚本被所有食谱共用,改动前先复制一份改链接,别在公共库上直接动刀。
地图在手,下一节正式开第一铲:跑通 yesno,把这张地图上的每座建筑都点亮一遍。