4.3 实战演练:从零训练一个手写数字 GAN
4.3 实战演练:从零训练一个手写数字 GAN
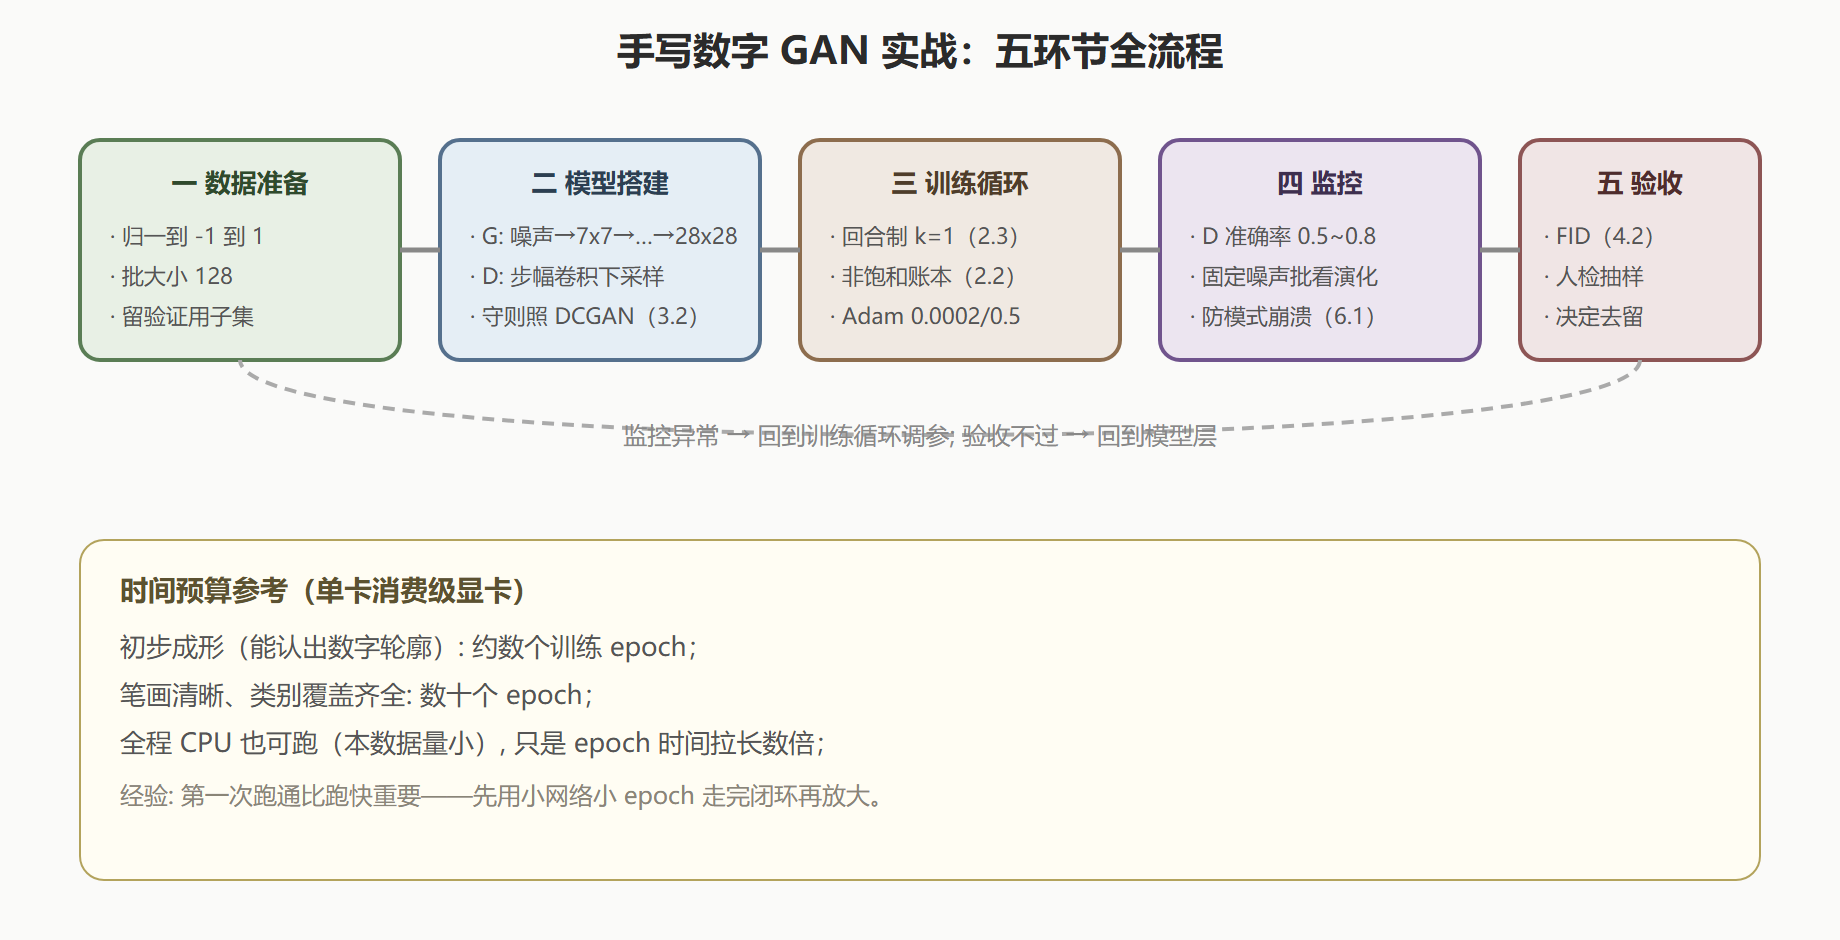
本节把前四章的知识合龙成一次完整实战:用手写数字数据训练一个 DCGAN 风格的 GAN,覆盖数据准备、模型搭建、训练循环、监控与验收五个环节。 全流程的每个决策点都回指前文的相应章节,训练数值来自可复算的等价小实验。
兵法收官:全流程合龙。前四节散装的知识——回合制、账本、守则、指标——在这节里各就各位。本实战用经典的手写数字数据集(28×28 灰度图,十个数字类别,训练集数万张),目标不是刷纪录,而是走通"从零到验收"的完整闭环。
战役地图:五个环节的依赖
实战全流程
环节一与二:数据与模型
数据侧三件事:像素归一到 −1~1(匹配生成器 tanh 输出范围);批大小 128(对抗训练对批统计敏感,太小的批让判别器的批归一化失真);留出固定验证子集算 FID(4.2 节的尺子要固定样本量)。
模型侧照 DCGAN 守则,但注意手写数字是 28×28 的奇数边长,转置卷积翻倍链是 7→14→28(核 4 步 2 填 1 时 7 出 14、14 出 28,核对公式 (7−1)×2+2=14、(14−1)×2+2=28)。生成器入口把 100 维噪声投影成 256×7×7,两级转置卷积到 28×28;判别器镜像下采样。关键尺寸用代码核对:
import numpy as np def tconv_out(H): return (H - 1) * 2 + 2 # 核4 步2 填1 print("生成器上采样链: 7 ->", tconv_out(7), "->", tconv_out(tconv_out(7))) # 输出: 生成器上采样链: 7 -> 14 -> 28 # 判别器下采样链(同核参数的普通卷积输出公式相同): 28 -> 14 -> 7 def conv_out(H): return (H - 4 + 2) // 2 + 1 # 核4 步2 填1 的卷积 print("判别器下采样链: 28 ->", conv_out(28), "->", conv_out(conv_out(28))) # 输出: 判别器下采样链: 28 -> 14 -> 7 # 参数量(生成器): g_layers = [(100, 256), (256, 128), (128, 64), (64, 1)] print("生成器参数量:", f"{sum(i*o*16+o for i,o in g_layers):,}") # 输出: 生成器参数量: 1,428,737
环节三:训练循环(PyTorch 惯用写法)
# 训练循环骨架(PyTorch 风格伪码, 关键行全保留) # G_optim/D_optim: 两个独立 Adam, lr=0.0002, betas=(0.5, 0.999) for epoch in range(50): for real, _ in dataloader: # 标签用不上: 自监督 # --- 步骤一: 训 D --- z = randn(batch, 100) fake = G(z).detach() # detach: 截断对 G 的梯度 d_loss = bce(D(real), ones*0.9) + bce(D(fake), zeros) # 单边标签平滑 d_loss.backward(); D_optim.step() # --- 步骤二: 训 G --- z = randn(batch, 100) # 新噪声批 g_loss = bce(D(G(z)), ones) # 非饱和账本 g_loss.backward(); G_optim.step() # --- 每回合监控 --- with no_grad(): d_acc = ((D(real) > 0.5).float().mean() + (D(G(fixed_z)) < 0.5).float().mean()) / 2 log(epoch, d_loss, g_loss, d_acc) # d_acc 落 0.5~0.8 为健康 save_grid(G(fixed_z), f"epoch{epoch}.png") # 固定噪声批: 看同一批噪声的演化
四个决策点逐一回指:detach 与新噪声批是 2.3 节的实现铁律;单边标签平滑与低压 Adam 来自 2.2 与 3.2 节;固定噪声批是人检的关键技巧——同一批噪声每个 epoch 采样一次,看起来是"同一批种子发芽",进步与退步一目了然,比每次随机采样好读得多。
环节四与五:监控读数与验收
监控什么、健康形态长什么样,本实战的判读表:
| 观察项 | 健康形态 | 危险信号 | 回指 |
|---|---|---|---|
| D 判别准确率 | 0.5~0.8 波动 | 长期 >0.9(碾压)或 <0.5(失灵) | 2.3/4.1 |
| D 损失 | 缓慢波动,不归零 | 快速归零(自信过度) | 6.2 |
| G 损失 | 与 D 损失反向拉扯 | 单边飙升且样本变差 | 6.2 |
| 固定噪声批 | 轮廓渐清、样式渐多 | 所有图趋同(模式崩溃前兆) | 6.1 |
验收阶段两把尺:FID 固定一万生成样本与验证子集计算,与基准(比如上一版模型)同尺比较;人检抽样看三件事——笔画完整、十类覆盖、样本间差异。两把尺都过,模型留下;只过一把,按判读表回炉。一个常见的健康插曲:训练早期出现"全部像同一个数字"的阶段后自行恢复——这通常是模式间竞争的过渡态,先别急着判崩溃,多看几个 epoch 的固定噪声批再下结论(与 6.1 节的真崩溃区分:真崩溃会持续并固化)。
⚠️ 常见坑:用训练集算 FID 验收——判别器见过的数据会低估差距,验收必须用留出的验证子集。
本节要点回顾
- 尺寸链:手写数字是 7→14→28 的上采样链,奇数边长要用公式核对每层;
- 循环四铁律:detach、新噪声批、独立优化器、低压 Adam;
- 固定噪声批:人检的最佳工具,看"同一批种子的发芽过程";
- 判读表:D 准确率 0.5~0.8、损失反向拉扯、样本渐多样;
- 验收双尺:留出集上的同尺 FID 加人检三看(完整/覆盖/差异)。
常见问题:实战排错
训了几个 epoch 样本还是噪声,正常吗? 先查三处:学习率是不是用了框架默认(应压到 0.0002 量级)、判别器是不是碾压(查 D 准确率)、数据缩放与输出激活是否匹配(正负 1 对 tanh)。三处都对仍噪声,耐心等——小数据集上十个 epoch 内见轮廓是常态。
数字能认出来但笔画发虚,怎么提高? 三个方向按性价比排序:延长训练(最便宜)、加大生成器通道(第二层最划算,3.2 节参数经济学)、加轻微 dropout 防判别器过拟合。别急着换架构,先把基线榨干。
出现"所有样本都是同一个数字"怎么办? 先区分暂时与持续:固定噪声批观察五个 epoch,持续固化才是模式崩溃(第 6.1 节),对策在那里;暂时的模式竞争会自行分化。
演算自测
把手写数字实战的尺寸链改到 32 乘 32:上采样链怎么走?答案:投影成 8 乘 8,两级转置卷积到 16、32(公式 (8 减 1) 乘 2 加 2 等于 16)。判别器第一层卷积从 32 出多少?答案:15 到 16 之间取决于填充,核 4 步 2 填 1 时出 15。改尺寸先核尺寸链,这是把结构公式用成工具的标准动作。