6.1 负迁移与常见施工事故排查
6.1 负迁移与常见施工事故排查
本节摘要:微调不总是一帆风顺,本章第一节当排错手册用。负迁移是"预训练起点反而拖累目标任务"的现象,理论根源在界定量迁移的差异项过大(第 2.4 节)。本节给出事故分级对照表(负迁移、学习率过大、数据泄漏、验证虚高四类),一套"先对照实验确认、再逐项排除"的排查流程,以及三个可以复现的对照实验代码模板。
排错先分级:症状对照总表
工地上出了事故,老师傅第一件事不是动手拆,是先判断是哪类事故。微调事故分四级,症状与处方各不相同:
| 事故等级 | 典型症状 | 病根层 | 第一处方 |
|---|---|---|---|
| 负迁移 | 微调版不如同架构随机初始化版 | 策略层 | 换预训练源或做领域适应 |
| 学习率过大 | 首轮验证远低于特征提取基线 | 工序层 | 降十倍重来加预热 |
| 数据泄漏 | 训练曲线完美、独立测试崩盘 | 数据层 | 重建切分、复查管道 |
| 验证虚高 | 验证好测试差、上线再掉一截 | 评测层 | 检查验证集决策泄漏与分布 |
四类事故的处置顺序有讲究:先排数据层(最隐蔽、影响最大),再排评测层,最后才是工序层与策略层——在泄漏的数据上调学习率,调得越准错得越远。
确认负迁移:对照实验是唯一铁证
负迁移的判定不能靠"效果不如预期"的感觉,唯一的铁证是对照实验:同架构、同数据、同训练配置,仅初始化不同。
import numpy as np # 对照实验的记录模板(同配置跑两版的伪结果) def compare_to_random(pretrained_val, random_val, n_repeats=3): """预训练版与随机初始化版的多次重复对照""" # 工程上每版换三个随机种子各跑一次,看均值与波动 diff = np.mean(pretrained_val) - np.mean(random_val) verdict = ("负迁移成立:预训练平均低 " f"{abs(diff):.1%},回策略层处理" if diff < -0.01 else f"负迁移不成立(差 {diff:+.1%}),去工序层排查") return verdict # 场景一:疑似负迁移的伪结果 print(compare_to_random([0.71, 0.69, 0.72], [0.75, 0.74, 0.76])) # 输出: 负迁移成立:预训练平均低 4.5%,回策略层处理 # 场景二:只是微调没调好 print(compare_to_random([0.73, 0.74, 0.72], [0.61, 0.63, 0.60])) # 输出: 负迁移不成立(差 +12.7%),去工序层排查
对照实验通过后,负迁移的成因再往下追三层:领域过远(特征层面无共性,第 2.2 节的 KS 检验可以复查分布差异)、源任务冲突(源任务学到的判别方向与目标相反)、源模型偏置(预训练数据的系统性偏差被目标侧放大)。
排查流程:从确认到逐项排除
确认负迁移成立后的标准排查流,按成本从低到高逐项做:
# 排查项一:加深冻结(成本最低,先试) # 冻结到只剩最后一段可训,看是否恢复到基线以上 # 若恢复 -> 预训练浅层仍有用,问题在深层被带偏,用层冻结模式收尾 # 排查项二:换预训练源(成本中) # 换领域更近的模型(第3.3节选宅四关重走),对比两版的对照实验 # 排查项三:数据侧复查(成本中,与排查项二并行) def check_label_noise(labels, preds, suspect_threshold=0.6): """用当前模型标记疑似标注噪声的样本""" agree = (labels == preds) print(f"模型与标注一致率: {agree.mean():.1%}") # 一致率低于七成且错误样本高度集中 -> 标注质量问题嫌疑 return 1 - agree.mean() print(check_label_noise(np.array([0,1,1,0,1]), np.array([0,1,0,0,1]))) # 输出: 模型与标注一致率: 80.0%(返回值 0.2)
事故排查决策树
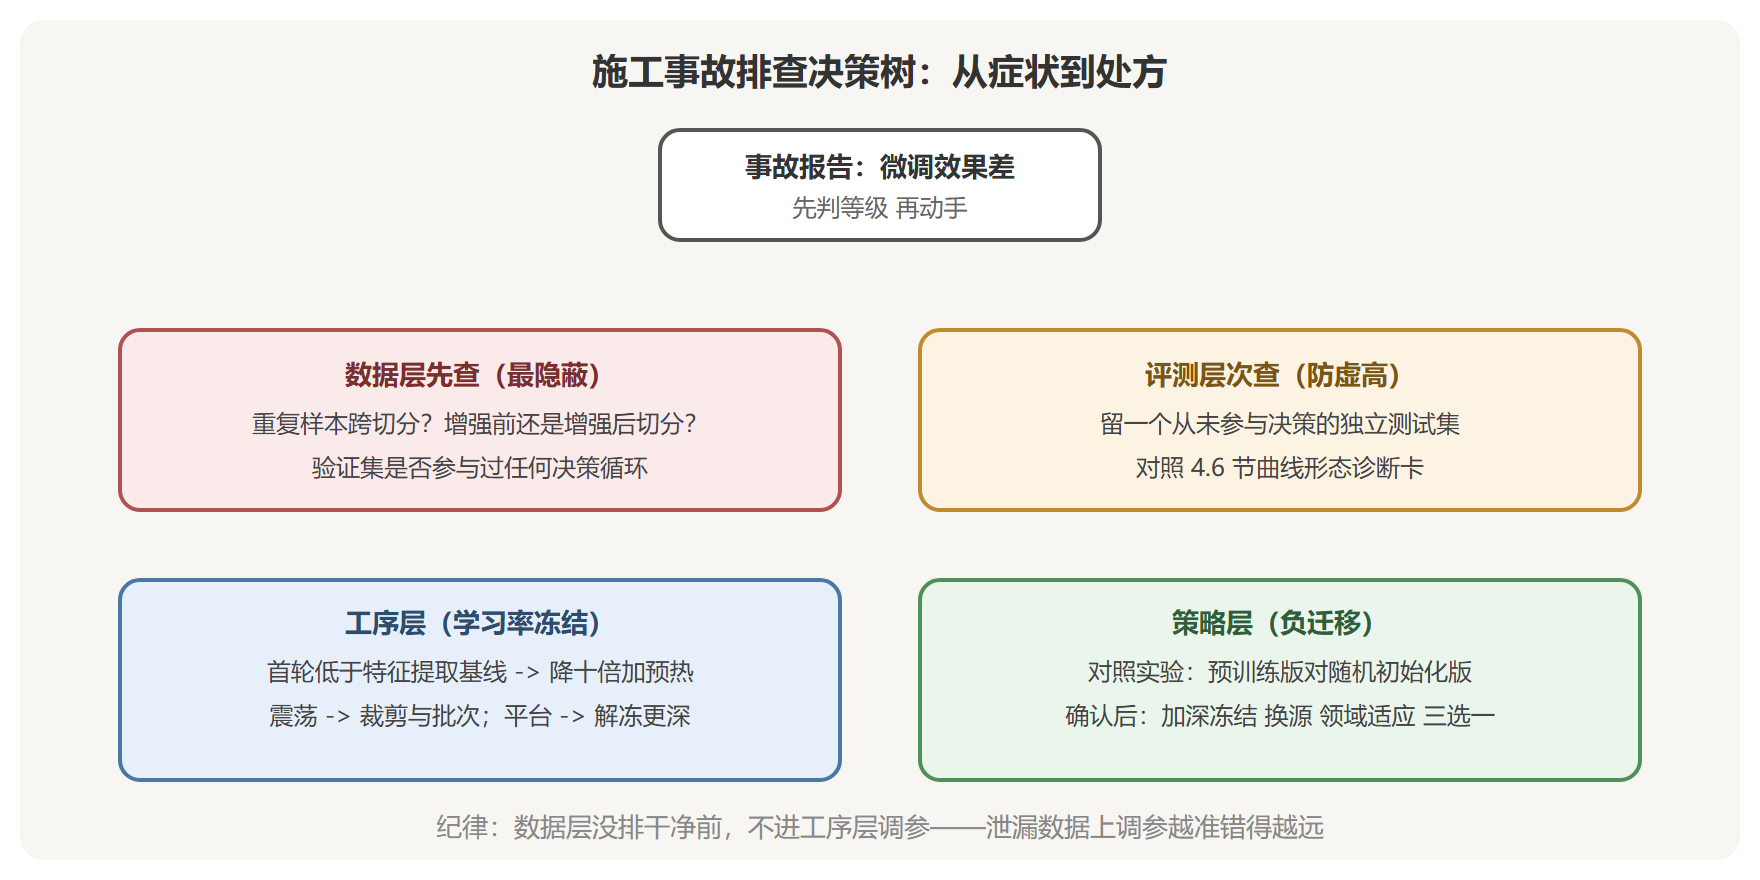
这棵决策树的要点是:越靠上层的检查越便宜且影响越大,先排干净再往下走。
三个高频事故的现场还原
**事故一:学习率过大。**第 4.4 节已详述机理,现场症状补充一条:训练损失下降反而比正常更快——模型在快速记忆训练集,验证精度首轮就低于特征提取基线。处方固定:降十倍、加预热,两分钟验证。
**事故二:数据泄漏。**现场症状是"训练验证都好、独立测试塌方"。最常见泄漏源:切分前做了重复样本去重之外的合并(近重复样本跨切分)、在全部数据上估计归一化参数、验证集参与超参选择的循环过深。处方:重建切分管道,切分严格先于一切数据统计。
**事故三:验证虚高。**与泄漏的区别在于没有信息流入训练,而是验证集本身被"用旧了"——反复用于决策后,你等于在验证集上做隐式搜索。处方:验收前换一个从未参与决策的测试集重测,虚高幅度超两个点就说明验证集需要轮换。
⚠️ 常见坑:把负迁移当成工序问题,降学习率、调冻结反复折腾两周。对照实验半天就能定案——先花半天定性,再决定往哪层投入。
一次完整排查的时间线示范
把流程串成时间线,展示一次教科书式的排查(原型来自真实项目形态,数字为典型量级):某缺陷检测微调项目报告"预训练版验证精度七成一,随机初始化版反而七成五"。第零天下午,团队做对照实验(三种子重复)确认差异稳定存在,负迁移定案,排除工序层。第一天,排查项一加深冻结:只放开最后一段后精度回到七成六——说明浅层仍有用、深层被源任务带偏,项目以层冻结模式收尾,挽回大部分损失。第二天起,并行做排查项二:换用工业图像预训练的模型重跑,全量微调到七成九——成为下一版本的方案。整个事故从报告到双方案落地三个工作日,核心开销是两次对照实验。
反面对照同样常见:同样的症状,若先在工序层折腾(降学习率试四组、换优化器试三组、调冻结试五组),两周后仍回到原点——因为病根在策略层,工序层的药再猛也到不了病灶。
💡 关键直觉:排错的经济学——每个排查动作按"信息量除以成本"排序。对照实验的信息量最大(直接分流策略层与工序层),成本半天,永远是第一个做。
本节要点回顾
- 四级事故:负迁移(策略层)、学习率(工序层)、泄漏(数据层)、虚高(评测层),症状对照表先分级
- 排除顺序:数据层最优先,泄漏数据上调参越准错得越远
- 负迁移铁证:对照实验(预训练版对随机版,多种子重复),差超过一个点即定案
- 三大处方:加深冻结、换源、领域适应——确认负迁移后的三选一
- 本节位置:事故处理完毕,下一节看大模型时代"全量微调训不动"时的进阶工艺