6.2 参数高效微调进阶:LoRA与外挂扩建
6.2 参数高效微调进阶:LoRA 与外挂扩建
本节摘要:当旧宅大到整体翻新不可行(显存装不下、多任务切换成本高),LoRA 用"在承重墙上外挂轻钢"的思路解决:冻结原权重,在旁边并上一个低秩分解的增量支路,只训增量。本节讲清低秩假设的直觉、手算 LoRA 参数量与全量微调的悬殊对比、秩的选择手感,以及它与适配器在结构与推理开销上的差异,最后演示权重合并——外挂训完可以焊死成普通权重,推理零开销。
从一个显存困境说起
七十亿参数的语言模型,混合精度全量微调的训练态显存约一百 GB(第 3.3 节的粗算),单卡二十四 GB 的团队根本装不下。三条出路:换小模型(精度受限)、云端多卡(成本高)、参数高效微调(只训极少量新增参数)。LoRA 是第三条路里当下最流行的工艺。
LoRA 的全称暗含其核心假设:预训练模型在适配下游任务时,权重的变化量是低秩的——不需要动整个权重矩阵的全部自由度,一个低秩的增量就足以表达任务适配。工程类比:整面承重墙不用重新砌,在旁边加两根轻钢梁就能改变整体受力。
机理:低秩增量支路
原权重矩阵保持冻结,旁边并上一条支路:先降维(乘一个瘦长矩阵)、再升维(乘一个扁宽矩阵),输出与原支路相加。可训练的只有支路里的两个小矩阵。
import torch import torch.nn as nn class LoRALinear(nn.Module): """LoRA 层的最小实现:冻结原权重,外挂低秩支路""" def __init__(self, original: nn.Linear, rank=8, alpha=16): super().__init__() self.base = original # 原支路:冻结 for p in self.base.parameters(): p.requires_grad = False d_out, d_in = original.weight.shape self.rank = rank self.scaling = alpha / rank # 缩放系数 alpha/r self.A = nn.Parameter(torch.randn(d_in, rank) * 0.01) # 降维 self.B = nn.Parameter(torch.zeros(rank, d_out)) # 升维,零初始化 # B 零初始化:训练开始时支路输出为零,模型行为与预训练完全一致 def forward(self, x): return self.base(x) + self.scaling * (x @ self.A @ self.B) # 参数账(以 768x768 的投影层为例) layer = LoRALinear(nn.Linear(768, 768), rank=8) n_lora = layer.A.numel() + layer.B.numel() n_full = 768 * 768 print(f"单层 LoRA 参数: {n_lora:,} / 全量 {n_full:,}({n_lora/n_full:.1%})") # 输出: 单层 LoRA 参数: 12,288 / 全量 589,824(2.1%)
两个实现细节继承自适配器的经验:升维矩阵零初始化保证起步无损;缩放系数(阿尔法除以秩)把不同秩的更新幅度归一到可比的量级,调秩时不用重调学习率。
全模型账本:手算一遍
def lora_total(d_model=4096, n_layers=32, rank=8, alpha=16): """粗算一个七十亿级模型的 LoRA 参数(只挂注意力投影)""" # 每层 4 个投影矩阵:Q K V O,每个 d_model x d_model per_layer_per_proj = 2 * d_model * rank # A 与 B 各一份 n = n_layers * 4 * per_layer_per_proj return n n_lora = lora_total() n_model = 7_000_000_000 print(f"LoRA 可训练参数: {n_lora:,}") # 输出: 8,388,608 print(f"占全模型: {n_lora/n_model:.2%}") # 输出: 0.12% # 训练态显存按 3.3 节口径重算(骨干冻结,无梯度无优化器状态) base_bytes = n_model * 2 # 半精度骨干前向 lora_train = n_lora * (2 + 2 + 8) # 参数+梯度+优化器状态 print(f"训练态粗估: {(base_bytes + lora_train)/1024**3:.1f} GB") # 输出: 训练态粗估: 13.4 GB —— 单卡 24GB 装得下,激活再占一部分仍有余量
百分之零点一二的可训练参数,把一百 GB 的训练需求压到十几 GB——这就是外挂扩建的账面魔力。多任务场景同样受益:骨干只存一份,每个任务只存几 MB 的 LoRA 增量,切换任务等于换插件。
秩的选择与合并
秩是容量旋钮:秩越高表达能力越强、参数越多。经验区间四到六十四:常规分类任务四到八够用,风格迁移或领域差异大的任务十六到三十二,超过六十四收益通常递减。缩放系数阿尔法常取秩的两倍,调容量时保持阿尔法与秩同比例放大即可。
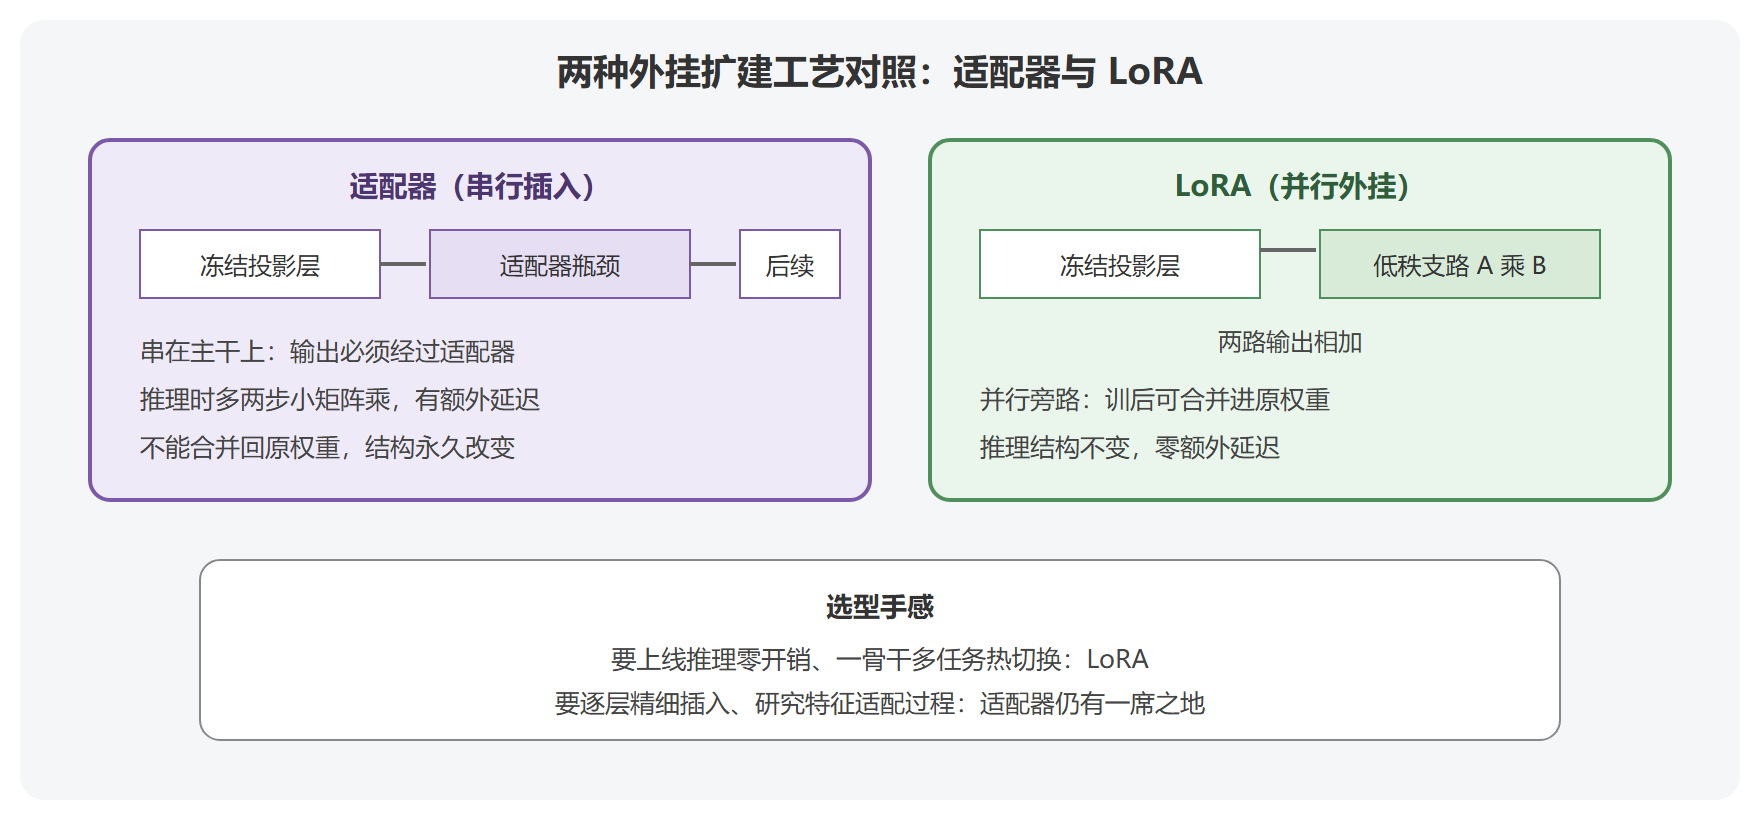
LoRA 相对适配器的一个关键优势:可合并。训练完成后,把支路的两个矩阵相乘加到原权重上,外挂焊死成普通权重,推理结构零改动、零开销:
def merge_lora(layer: LoRALinear): """训后合并:增量并入原权重,推理零开销""" delta = (layer.scaling * (layer.A @ layer.B).T) # 与权重同形的增量 merged_weight = layer.base.weight.data + delta return nn.Linear(layer.base.in_features, layer.base.out_features), merged_weight # 合并演示(数值验证增量并入) layer = LoRALinear(nn.Linear(768, 768), rank=8) with torch.no_grad(): layer.A.normal_(0, 0.02); layer.B.normal_(0, 0.02) # 模拟训练后的非零增量 _, merged = merge_lora(layer) diff = (merged - layer.base.weight).norm() / layer.base.weight.norm() print(f"合并后权重相对原权重的改动幅度: {diff:.2%}") # 典型输出: 合并后权重相对原权重的改动幅度: 1.37% # 改动温和 —— 低秩假设成立的侧面证据:任务适配只需小幅、低维度的调整
LoRA 与适配器对照
⚠️ 常见坑:把 LoRA 挂到所有层所有模块(包括层归一化与前馈)追求"全覆盖"。经验上挂在注意力的投影矩阵已够大多数任务,全挂徒增显存与过拟合面。
💡 关键直觉:LoRA 的哲学是"承认预训练权重已经很好,任务适配只是低维方向上的微调"。第 2.4 节的层次规律在参数空间里的投影,就是低秩假设的直觉来源。
本节要点回顾
- 低秩假设:任务适配所需的权重变化量是低秩的,一支降维升维的旁路即可表达
- 参数账:七十亿模型挂注意力投影、秩八,可训练约八百三十九万,占百分之零点一二,训练显存从百 GB 级压到十几 GB
- 工程细节:升维零初始化起步无损、缩放系数阿尔法比秩归一幅度、秩四到六十四按任务复杂度取
- 合并红利:训后增量并入原权重,推理零开销——这是它对适配器的决定性优势
- 本节位置:事故排查(6.1)解决"改不好",LoRA 解决"改不起",最后一节立验收标准