5.3 工地三:用BERT完成文本分类改造
5.3 工地三:用 BERT 完成文本分类改造
本节摘要:语言侧工地。用 HuggingFace 工具链把中文 BERT 微调成评论情感分类器,走完分词、数据整理、训练器配置、训练监控、推理验证全流程。重点看语言微调与视觉微调在配置直觉上的差异:学习率小两个量级、批次与序列长度决定显存、评测口径换成文本任务的指标。验收环节给出典型数字与错误样本复盘方法。
背景
任务:电商评论情感二分类(正面/负面),标注约六千条,中文短文本平均三十字左右。选宅(第 3.3 节流程):中文预训练 BERT 基础版,编码器系(理解类任务),参数约一亿一千万,领域距离中等(电商口语与通用语料有差异但可控),单卡预算充足。施工模式:数据中等偏少,采用全量微调但学习率压到语言模型的常规区间。
操作:从分词到训练器
**第一步:分词与数据整理。**语言侧多一道工序——文本要先变成词元序列:
from transformers import BertTokenizer tok = BertTokenizer.from_pretrained("bert-base-chinese") def encode(texts, labels=None, max_len=64): enc = tok(texts, padding="max_length", truncation=True, max_length=max_len, return_tensors="pt") out = {"input_ids": enc["input_ids"], "attention_mask": enc["attention_mask"]} if labels is not None: out["labels"] = labels return out sample = encode(["这家店的物流快得离谱,包装也扎实,五星!"]) print(f"序列长度: {sample['input_ids'].shape[1]}") # 输出: 序列长度: 64 print(f"非填充词元数: {sample['attention_mask'].sum().item()}") # 典型输出: 非填充词元数: 21(含 CLS 与 SEP) # max_len 取 64:覆盖绝大多数短评,兼顾显存与速度
**第二步:定义模型与训练器。**用高层训练器 API,把第 4 章的工艺配置全部显式化:
from transformers import BertForSequenceClassification, TrainingArguments model = BertForSequenceClassification.from_pretrained( "bert-base-chinese", num_labels=2) args = TrainingArguments( output_dir="ckpt", # 检查点目录(仅训练期使用) num_train_epochs=3, # 语言微调轮数很少:2-4 轮常见 per_device_train_batch_size=16, learning_rate=2e-5, # 语言微调核心差异:1e-5 到 5e-5 区间 warmup_ratio=0.1, # 预热占总步数一成 lr_scheduler_type="cosine", # 余弦衰减(4.4 节) weight_decay=0.01, # AdamW 衰减(4.5 节) max_grad_norm=1.0, # 梯度裁剪阈值(4.5 节) evaluation_strategy="epoch", # 每轮验证(4.6 节监理) save_strategy="epoch", load_best_model_at_end=True, # 训练结束自动回滚到最优检查点 metric_for_best_model="accuracy", ) print("训练器配置 = 第4章工艺的语言侧翻译:小学习率、少轮数、强调度")
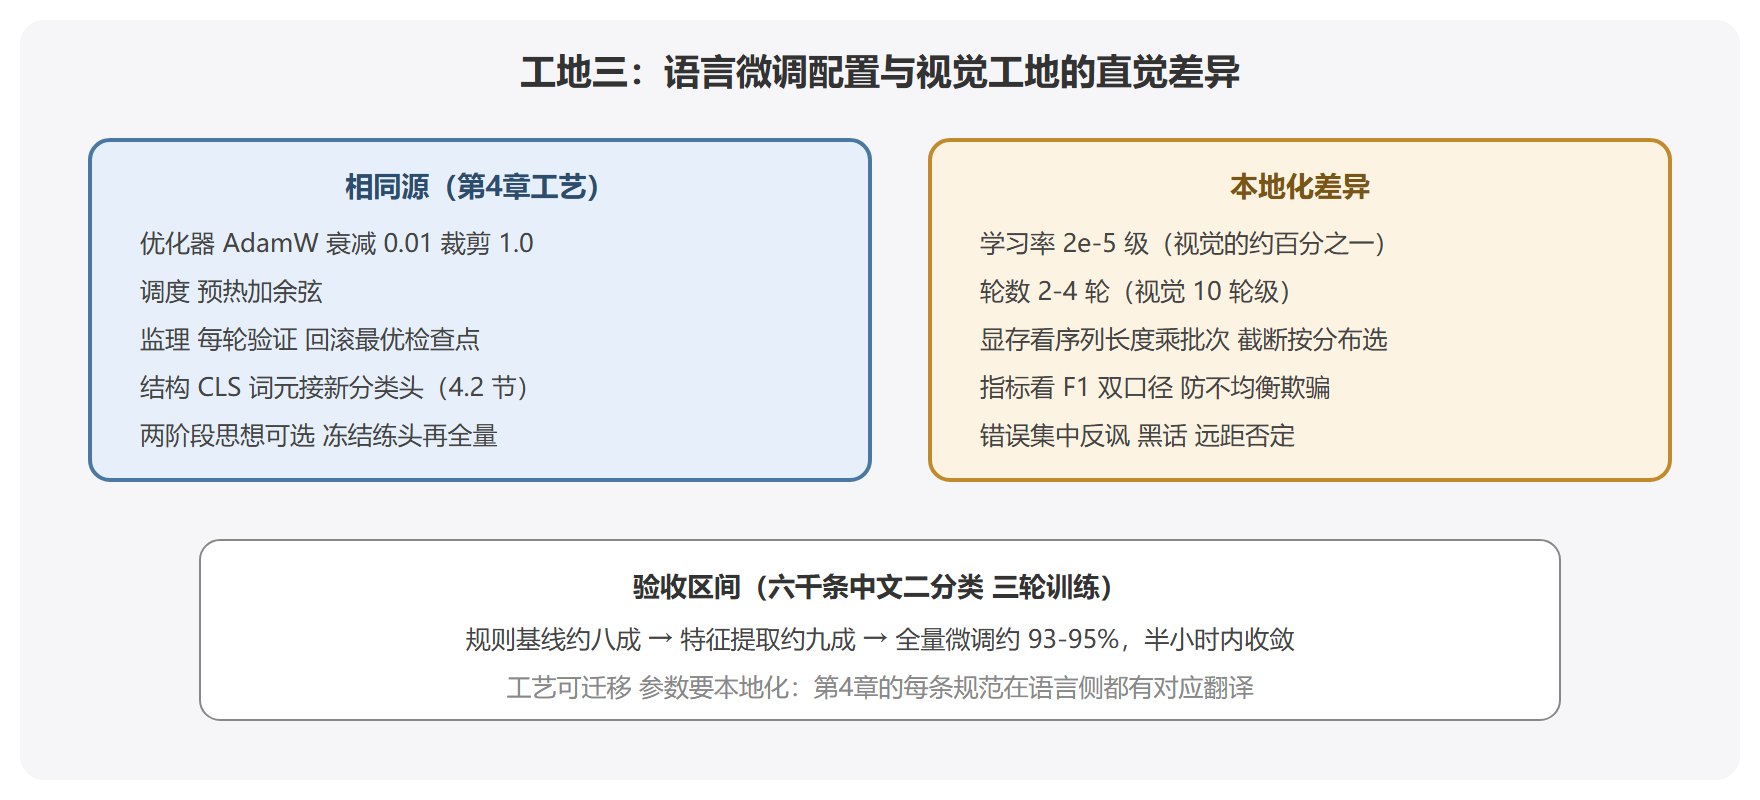
注意这些参数与视觉工地二的对照:学习率从万分之一级再压一个量级到五万分之一级(预训练语言模型对参数扰动更敏感);轮数从十轮级压到三轮级;其余工艺(预热、余弦、裁剪、衰减、每轮验证、回滚最优)完全同源——这就是"工艺可迁移、参数要本地化"。
**第三步:训练与监控。**训练器接管循环,监理信息在每轮验证输出里,判读方法沿用 4.6 节的曲线诊断卡。
import numpy as np def compute_metrics(pred): """验收指标:准确率与 F1 双口径(类别不均衡时看 F1)""" logits, labels = pred preds = np.argmax(logits, axis=1) acc = (preds == labels).mean() tp = ((preds == 1) & (labels == 1)).sum() fp = ((preds == 1) & (labels == 0)).sum() fn = ((preds == 0) & (labels == 1)).sum() precision = tp / max(tp + fp, 1) recall = tp / max(tp + fn, 1) f1 = 2 * precision * recall / max(precision + recall, 1e-9) return {"accuracy": acc, "f1": f1} # 指标计算演示 demo_logits = np.array([[2.0, -0.5], [-1.0, 1.5], [1.8, 0.3], [0.2, 1.1]]) demo_labels = np.array([1, 1, 0, 0]) print(compute_metrics((demo_logits, demo_labels))) # 输出: {'accuracy': 0.5, 'f1': 0.5} # 准确率与 F1 双口径都健康才算验收通过,单看准确率会被不均衡骗
结果
同类规模任务(六千条中文二分类、训练三个轮次)的典型验收区间:验证准确率约百分之九十三到九十五,F1 相近;训练单卡半小时以内。对照组:仅用关键词规则的基线约八成出头;冻结 BERT 只训分类头的特征提取版约九成到九成一。全量微调比特征提取多赚约三个点——与视觉工地二的增益结构一致。
解读
三个语言侧特有的观察:
**其一,轮数少得反直觉。**语言微调两三个轮次常到顶,第四轮起验证损失开始回升。原因与参数扰动敏感同源:预训练语言模型的损失面在下游任务附近很"陡",多走一步就过。早停与回滚最优因此从工艺建议变成硬纪律。
**其二,显存由序列长度与批次乘积决定。**注意力计算量随序列长度平方增长,截断长度从六十四翻到一百二十八,显存占用近乎翻倍。工地原则:按数据实际分布选截断长度(覆盖九成五样本即可),不要无脑设成五百一十二。
**其三,错误样本复盘价值极高。**抽看验证集里预测错的样本,典型错误集中在反讽("好得很,等了半个月")、领域黑话、否定词远距搭配三类。这些样本清单一方面提示数据增强方向(反讽样本加权),另一方面为第 6 章验收环节的错误分析提供素材。
语言工地配置对照
变式
- 标注更少(千条级):降学习率到一万分之一级、轮数减到两轮,或退回特征提取加轻量头
- 多类别或回归:换头与损失函数相应调整(多类交叉熵、均方误差),流程不变
- 领域更强(医疗、法律):在通用 BERT 上先做领域继续预训练(掩码目标),再做本工地流程,两步串联
⚠️ 常见坑:拿视觉的学习率直觉(万分之一)微调 BERT,第一轮就把预训练语言知识冲垮,验证精度反而低于特征提取——语言侧请从五万分之一级起调。
💡 关键直觉:语言微调的全部谨慎源于一点——预训练语言模型的参数空间对下游任务的"坡度"极陡,小步慢行不是保守,是必须。
本节要点回顾
- 完整流程:分词编码(截断六十四)→ 训练器显式配置全部工艺 → 双口径指标验收 → 错误样本复盘
- 配置翻译:学习率两万分之一级、轮数两到四、其余工艺与视觉同源
- 验收区间:六千条二分类约九成三到九成五,特征提取对照约九成
- 语言特有:显存看序列乘批次、F1 防不均衡、反讽与远距否定是错误重灾区
- 三工地闭环:最小施工、全量施工、语言施工齐了,下一章处理收尾——事故排查与上线验收