5.2 工地二:全模型微调与两阶段施工
5.2 工地二:全模型微调与两阶段施工
本节摘要:同一个工地升级改造——解冻 ResNet-18 全部层做全量微调,并采用两阶段施工节奏:先冻结练头两三轮,再解冻骨干小学习率整体微调。对照工地一的基线,你会看到解冻带来的增益与代价(精度提升、耗时与过拟合风险同来),并掌握判别式分组学习器与 BN 统计量处理这两个关键细节。
背景
工地一的验收留下两条线索:基线健康(特征提取约九成精度),但缺陷类里的细划痕样本置信度普遍偏低——预训练特征对这类细粒度差异"看不清"。这符合升级改造的触发条件:任务相似但局部差异超出冻结特征的分辨力。方案定为两阶段全量微调。
为什么两阶段而不是直接解冻训练?直接解冻时,新头的随机输出会产生混乱梯度,反向冲击尚未适应的骨干,前几个轮次等于"新头带着骨干乱撞"。先把头练到基本可用(冻结骨干),骨干再解冻时梯度已有意义——这就是第 4.3 节渐进解冻思想的最常用形态。
操作:两阶段施工全程
import torch import torch.nn as nn from torchvision import models model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1) model.fc = nn.Linear(model.fc.in_features, 2) # ---------- 阶段一:冻结骨干,练头 ---------- for p in model.parameters(): p.requires_grad = False model.fc.weight.requires_grad = True model.fc.bias.requires_grad = True opt1 = torch.optim.AdamW(model.fc.parameters(), lr=1e-3) print(f"阶段一可训练参数: {sum(p.numel() for p in model.parameters() if p.requires_grad):,}") # 输出: 阶段一可训练参数: 1,026 # 跑 2-3 轮,验证精度到平台即进入阶段二(工地一已完成等价动作) # ---------- 阶段二:解冻全部,判别式学习率 ---------- for p in model.parameters(): p.requires_grad = True opt2 = torch.optim.AdamW([ {"params": [p for n, p in model.named_parameters() if not n.startswith("fc.")], "lr": 1e-4}, # 骨干:小步慢行 {"params": model.fc.parameters(), "lr": 1e-3}, # 已练好的头:维持原速 ]) # 关键细节一:BN 统计量冻结(4.3 节的陷阱在此生效) n_bn = 0 for mod in model.modules(): if isinstance(mod, nn.BatchNorm2d): mod.eval(); n_bn += 1 print(f"阶段二解冻全部权重,同时固定 {n_bn} 个 BN 层统计量") # 输出: 阶段二解冻全部权重,同时固定 20 个 BN 层统计量
阶段二的调度配 4.4 节的带预热余弦:预热一百步内学习率线性爬升,给刚解冻的骨干一个缓冲。
import math from torch.optim.lr_scheduler import LambdaLR warmup, total = 100, 800 def lr_lambda(step): if step < warmup: return step / warmup t = (step - warmup) / (total - warmup) return 0.5 * (1 + math.cos(math.pi * t)) sched = LambdaLR(opt2, lr_lambda) # 训练循环骨架(沿用 4.6 节监理器件) # for epoch in range(num_epochs): # train_one_epoch(...) # 含梯度裁剪 max_norm=1.0(4.5 节) # acc = validate(...) # if stopper.step(acc, model): break print("阶段二配置:骨干1e-4 头1e-3 预热100步 余弦衰减 裁剪1.0 早停耐心3")
结果
同类规模任务(八百张二分类)上两阶段全量微调的典型验收区间,与工地一并列:
| 方案 | 验证精度 | 训练耗时 | 过拟合风险 |
|---|---|---|---|
| 工地一 特征提取 | 约 90% | 分钟级 | 极低 |
| 工地二 两阶段全量 | 约 93% 到 94% | 十倍耗时 | 中(需早停) |
| 直接解冻(跳过阶段一) | 约 91% 到 93%,方差大 | 同上 | 偏高 |
增益两到四个点,且细划痕样本的置信度明显改善——这正是解冻深层的价值所在。但注意代价列:训练耗时约十倍(特征缓存红利消失,骨干要反传),过拟合风险抬头(验证曲线在第四五轮后常出现缓升),早停与最优快照从可选变为必选。
解读
三个层面的解读:
**增益从哪来。**解冻让 layer3、layer4 的卷积核可以针对划痕这类细长低对比度模式调整响应,冻结特征"看不清"的样本获得表达空间。可以做个侧面验证:对比两方案在这些难样本上的预测分布,微调版的置信度分布整体右移。
**为什么两阶段稳。**阶段一把头的输出从随机推到合理,阶段二解冻时骨干收到的梯度信号已经"讲道理"。跳过阶段一的直接解冻不是不能收敛,而是前几轮梯度混乱,收敛路径方差大——上表第三行就是证据。
**什么时候升级不值得。**若工地一的验收已经九成五以上、难样本清单很短,全量微调的预期增益可能不到一个点,十倍耗时纯属浪费。升级改造要有证据(难样本清单、增益预估),不是习惯。
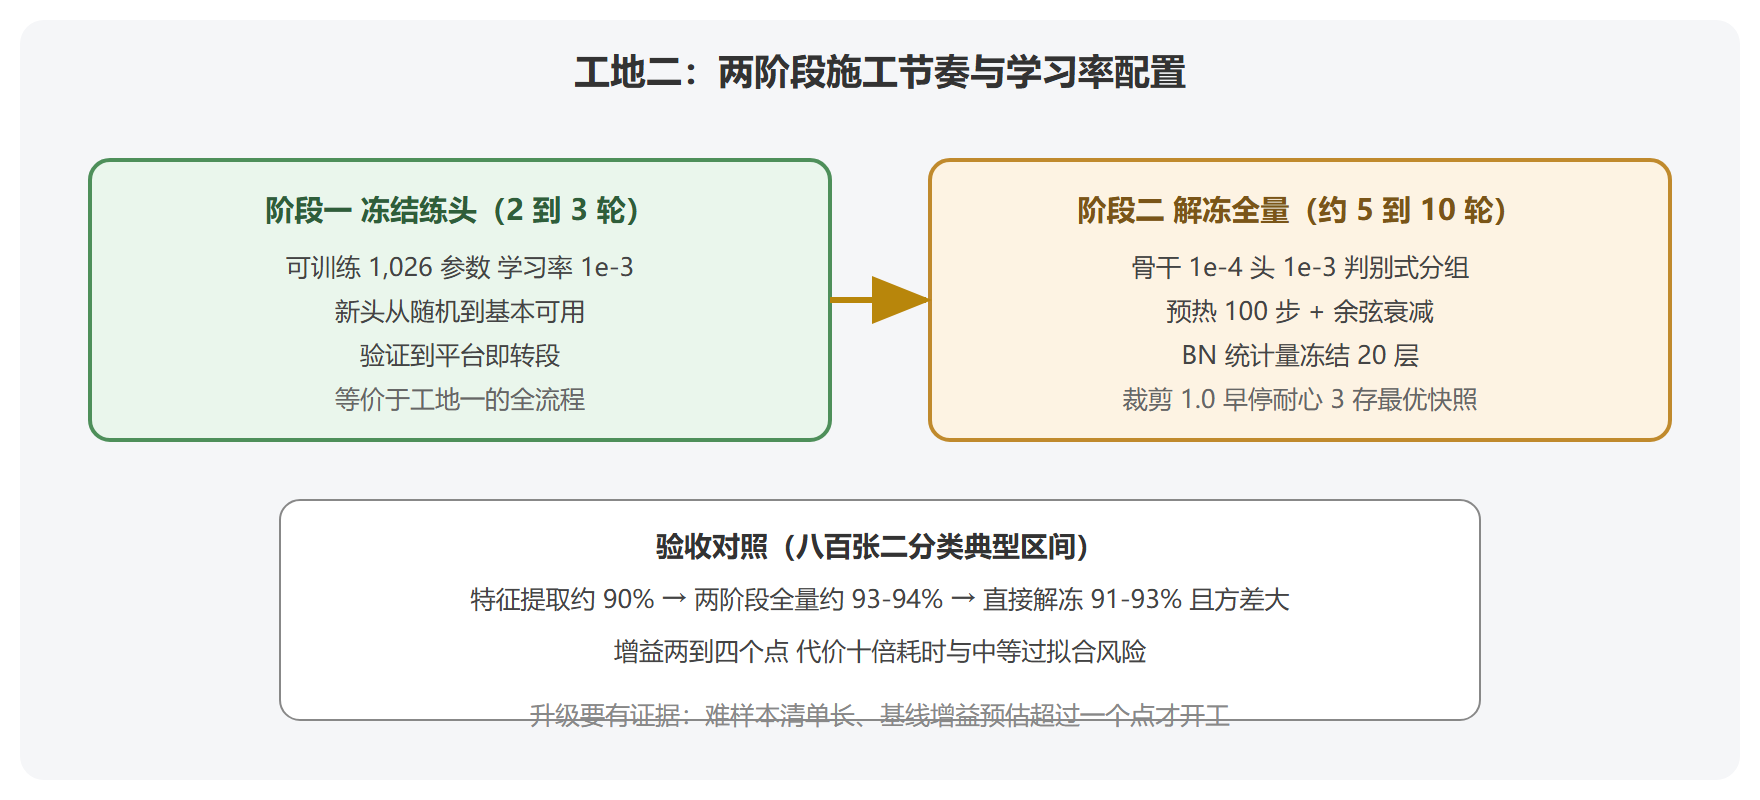
两阶段施工节奏图
变式
- 数据减半(四百张):两阶段节奏保持,但阶段二只解冻 layer4(第 4.1 节矩阵左移一格),骨干学习率再降一半
- 数据翻倍(一千六百张):可尝试跳过阶段一、直接全量加预热——数据足以支撑梯度质量,流程能简化
- 多类别十分类:流程不变,新头维度替换即可,两阶段的收益随类别数增加更明显
⚠️ 常见坑:转段时忘了把新头学习率保留在原量级。全模型统一用万分之一学习率,会让已经练好的头突然"变笨",前几轮验证掉点再缓慢爬回,白白浪费耐心值。
💡 关键直觉:两阶段施工的本质是"先让新增结构成熟,再动存量结构"。任何带新模块的微调(换头、加适配器)都适用这条节奏。
本节要点回顾
- 两阶段节奏:冻结练头两三轮(等价工地一)→ 解冻全量判别式学习率,比直接解冻稳且方差小
- 关键细节:骨干一万分之一配头千分之一、BN 统计量冻结二十层、预热加余弦、裁剪一点零
- 验收对照:九成基线升到九成三到九成四,代价十倍耗时与中等过拟合风险
- 升级纪律:难样本清单与增益预估是开工证据,不是习惯性升级
- 下一站:视觉侧两个工地闭环,工地三换到语言侧,工艺同源、工具链升级