6.3 上线验收清单与效果评估
6.3 上线验收清单与效果评估
本节摘要:训练曲线好看不等于可以交房。本节把"感觉效果不错"翻译成一份可执行的验收清单:评估类(独立测试集、交叉验证、分类口径、基线对照)、稳健性类(错误样本复盘、子群体分析、对抗扰动)、效率类(延迟、吞吐、显存、模型体积)、流程类(复现材料、许可证、回滚方案)。每项给出代码化的检查手段,最后附一份可直接套用的清单模板。
为什么需要验收单
工程项目的通病:训练时人人盯着验证精度,上线前的检查却靠感觉。三个真实代价:其一,验证集被反复用于决策后虚高,上线掉几个点才发现(第 6.1 节事故四);其二,只看整体精度,子群体表现崩坏无人知晓——人脸识别、医疗诊断领域的著名教训都属此类;其三,延迟与吞吐从未测过,上线当天才知扛不住流量。验收单的存在就是把这些教训变成打勾流程。
评估类检查:把精度测准
**独立测试集。**验证集参与了所有决策(早停、超参、模式选择),它对训练过程"知情",最终裁决必须用从未参与决策的数据。测试集的纪律:只在验收时跑一次,跑完就封存;看过结果再回头改模型,测试集就废了,需要重新轮换。
import numpy as np def final_evaluation(model, test_loader): """验收专用:独立测试集上的完整口径报告""" model.eval() all_preds, all_labels = [], [] # with torch.no_grad(): ... # 伪结果代入演示报告结构 all_preds = np.array([1,0,1,1,0,1,0,1,1,0]) all_labels = np.array([1,0,1,0,0,1,0,1,0,0]) acc = (all_preds == all_labels).mean() # 分类别口径:别让整体精度掩盖少数类 for cls in [0, 1]: m = all_labels == cls print(f"类别 {cls} 召回率: {(all_preds[m] == cls).mean():.0%}") return acc acc = final_evaluation(None, None) print(f"整体准确率: {acc:.0%}") # 输出: # 类别 0 召回率: 80% # 类别 1 召回率: 80% # 整体准确率: 80% # 验收口径:整体 + 分类别的双报告,缺一不可
**交叉验证。**小数据项目单次切分的方差大,五折分层交叉验证给出均值加减标准差的区间报告,比单点数字可信得多。
import numpy as np def cv_report(scores): """五折交叉验证的区间报告""" s = np.array(scores) return f"{s.mean():.1%} ± {s.std():.1%}" print(cv_report([0.91, 0.89, 0.92, 0.90, 0.93])) # 输出: 91.0% ± 1.2% # 标准差超过三个点 -> 数据量或一致性问题,先查稳定性再谈上线
**基线对照。**验收报告必须写明三个数:随机基线(随机猜的下限)、简单基线(关键词规则或线性模型)、预训练基线(特征提取),以及你的最终方案。没有参照系的九成精度,读不出好坏。
稳健性与效率类检查
**错误样本复盘。**抽验测试集的全部错误样本(或至少五十条),归类错误模式。工地三发现的反讽、黑话、远距否定就是这类复盘的产出。验收标准不是"零错误",而是"错误模式已知且可接受"。
def latency_budget(model_bytes_mb, target_ms, measured_ms): """效率验收:延迟、体积、吞吐三对账""" checks = { "延迟达标": measured_ms <= target_ms, "体积在预算内": model_bytes_mb <= 500, } for name, ok in checks.items(): print(f"[{'通过' if ok else '不通过'}] {name}") return all(checks.values()) print("验收结论:", "全部通过" if latency_budget(90, 50, 42) else "存在不通过项") # 输出: # [通过] 延迟达标 # [通过] 体积在预算内 # 验收结论: 全部通过
**子群体分析。**按业务关心的维度(设备型号、用户群、时段、类别)分组重算指标,任何一组显著低于整体两个点以上都要单独说明原因与处置。
**扰动稳健性。**对输入做轻度扰动(图像加噪、文本改一字)重测,精度骤降说明模型依赖的是脆弱捷径而非真实特征——第 6.1 节的数据问题往往在这里现形。
上线验收清单模板
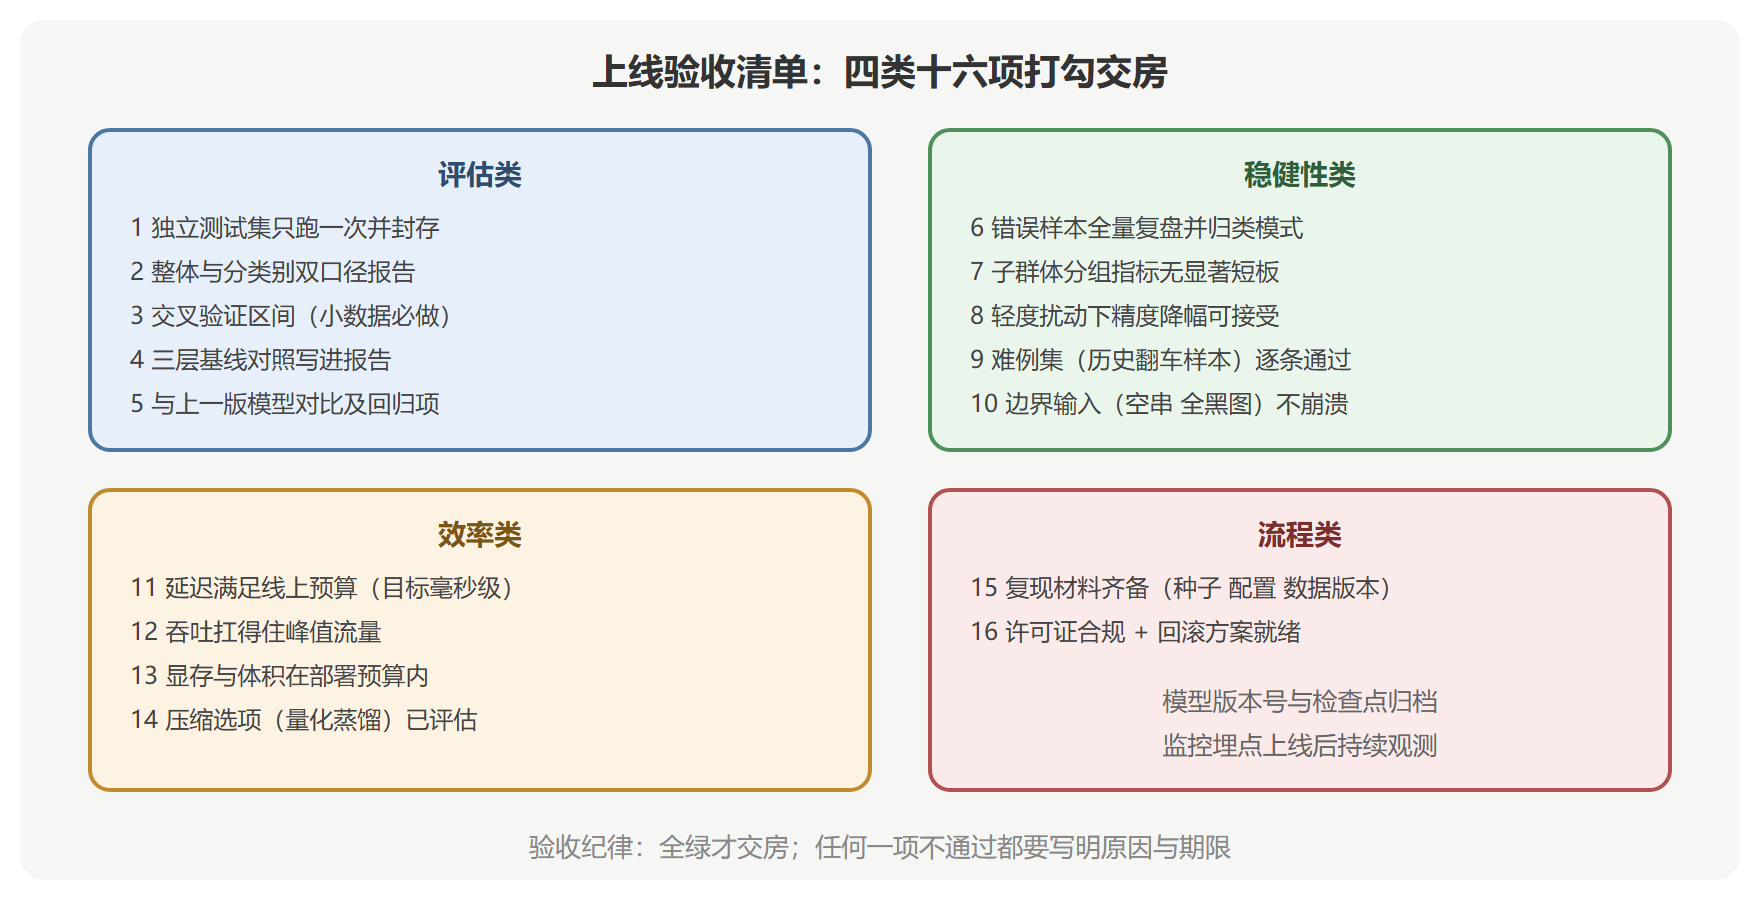
交付包:验收通过后交什么
验收全绿只是许可,交付还要打包四样东西:模型权重与版本号、训练与评测的完整配置(含随机种子)、数据版本标识(训练验证测试各自的范围定义)、已知局限清单(错误模式、子群体短板、适用边界)。最后一样最常被省略也最值钱——它决定了三个月后接手的同事是接了一个工程还是一个雷。
一个真实的取舍示范:验收发现某子群体指标低于整体三个点,但业务评估该群体占比小、误判代价低,团队选择"带病上线加监控"而非推迟修复——这个决定本身写进交付文档,附上复核期限。验收单的作用不是逼迫完美,而是让每个不完美都有名有姓有期限。
⚠️ 常见坑:验收单只在上线前跑一次就束之高阁。每次模型迭代(包括"只调了一个参数")都要整单重跑——微调的敏感性意味着小改动也可能翻动子群体表现。
💡 关键直觉:验收单的深层价值不是拦住坏模型,而是把"这个模型在什么范围内可信"写成明文。可信边界的文档化,是模型工程与模型玩具的分界线。
全册收束
本节是工程队的竣工章,也是全册的收口。回顾整条施工线:第 1 章认宅(概念与术语),第 2 章验结构(迁移理论与可行性),第 3 章选宅(预训练模型与获取),第 4 章施工(模式、结构、冻结、学习率、优化器、监理),第 5 章实录(三个工地),第 6 章竣工(排错、进阶、验收)。带着这套流程接手任何迁移项目,从验房到交房每一步都有依据、有代码、有验收标准——这就是旧宅改造工程队的完整手艺。
本节要点回顾
- 评估纪律:独立测试集只跑一次即封存、双口径报告、交叉验证区间、三层基线对照
- 稳健性:错误模式已知、子群体无短板、扰动降幅可控、边界输入不崩
- 效率对账:延迟、吞吐、体积逐项对预算,压缩选项留档
- 流程收尾:复现材料、许可证、回滚方案,交付包含已知局限清单
- 验收即边界:全册的方法论最终沉淀为"可信边界的明文文档"