第三章 记忆怎么管:短期与长期的分工
第三章 · 记忆怎么管:短期与长期的分工
本章要回答的三个问题:窗口装不下任务需要的全部信息时,有限的空间怎么分配?什么值得长期记住、记在哪里、怎么找回来?记忆会错会旧,怎么让它可靠地过期与更新?
为什么会有这一章
第 2 章的循环有一个隐含假设:所有信息都在当前上下文里。这在演示代码里成立,在生产环境立刻破产——一个跑了两周的助理,要记得住用户的偏好、部门的流程、上周任务的中途结论,而这些加起来早就超过任何模型的窗口容量。更麻烦的是,窗口不是装得下就万事大吉:塞得越满,模型对中间内容的注意力越差,关键信息被淹没在常规信息里的"检索失败"比"没有存储"更冤枉。
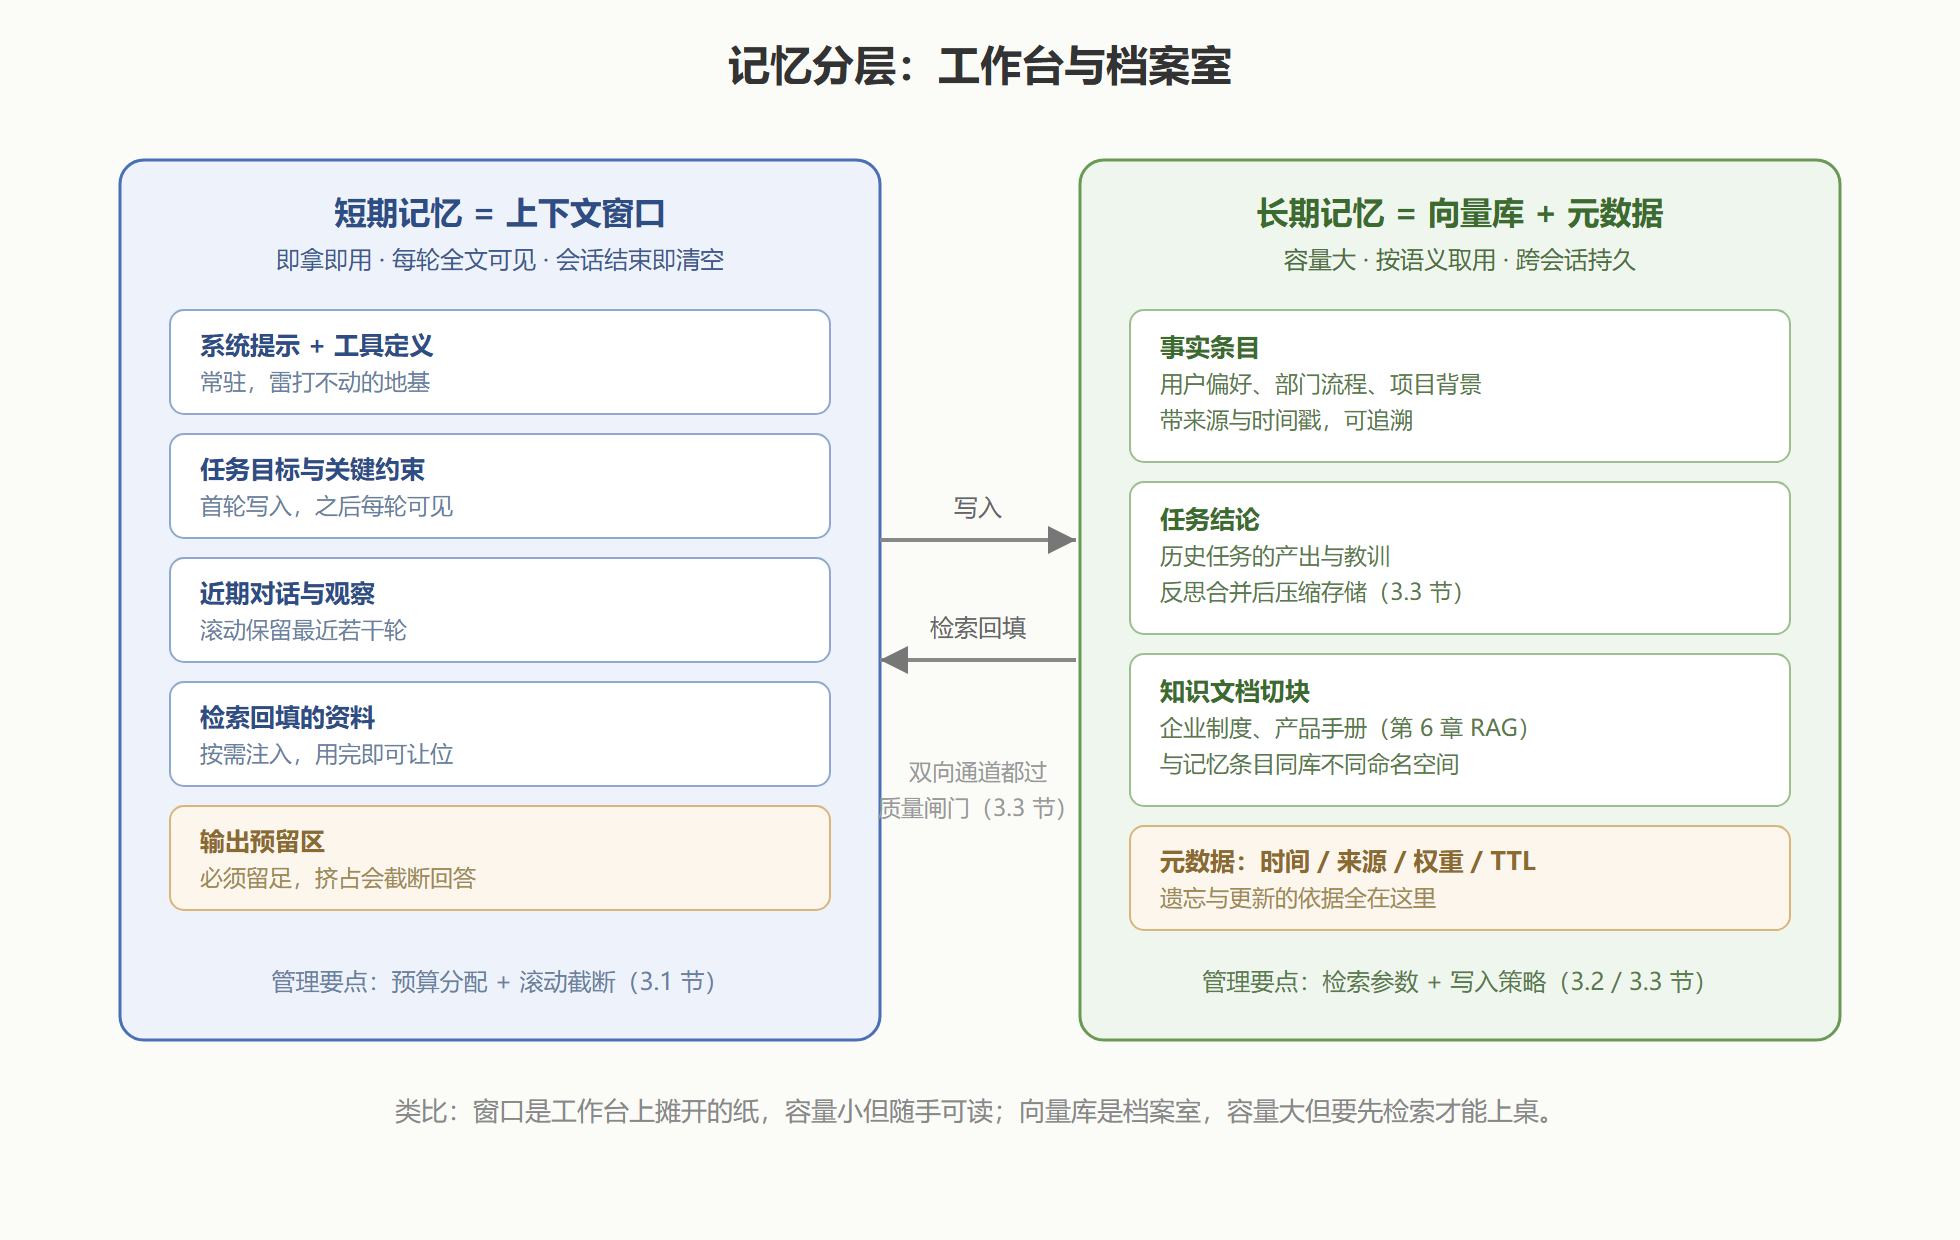
所以记忆管理的本质是一门分配的经济学:空间有限、注意力有限、预算有限,要在短期窗口、长期存储、检索机制之间做出取舍。本章把这这套取舍拆成三节:短期的窗口怎么分配,长期的库怎么建怎么查,以及跨两层的写入、遗忘与反思怎么协同。
本章全景
图:记忆分层架构——短期窗口与长期库的分工
读完能解决什么
- 能为一类任务算清窗口账:五块内容各占多少 token、什么先被挤出、输出留多足。
- 能实现滚动窗口与中段摘要,避免"越聊越长、越长越忘"。
- 能搭建最小可用的长期记忆:切块、嵌入、入库、按语义检索,并对 top_k、阈值、过滤参数给出有依据的取值。
- 能设计记忆的写入门槛、过期策略与周期反思,防止长期库变成无人认领的垃圾场。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 3.1 短期记忆 | 窗口空间怎么分配、装不下怎么办 | 预算分配表与滚动截断代码 |
| 3.2 长期记忆 | 怎么存、怎么查、参数怎么定 | 检索链路与参数建议表 |
| 3.3 分层记忆实战 | 写什么、何时查、怎么忘、怎么反思 | MemoryStore 类骨架与协同策略 |
先决条件
- 读完第 2 章,理解观察回填与上下文滚动的关系——记忆的写入物正是观察与结论。
- 知道"向量"是什么(一串数字表示的语义坐标)即可,不需要算法推导。
- 3.2 节涉及任选一个向量数据库的基本用法,概念对所有产品通用。
往下走到哪
记忆解决了"记住过去",但任务变大后还缺一环:怎么把大目标拆成有依赖关系的步骤序列。第 4 章的规划模块会大量消费本章的产出——检索回来的背景知识,正是拆解任务时的依据。
选型前的两个判断
要不要长期记忆,先看任务有没有"第二次"。一次性问答不需要向量库——窗口里装得下的任务,引入长期记忆纯属负债。判断口径:同一个用户(或同一类任务)是否会跨会话地再次到来?上下文里是否有"上次说过/做过"的诉求?两个答案都是否,把预算花在检索质量与提示词上回报更高。
记忆的边界感:记住不等于全都存。用户测试里最受好评的助理,往往不是"记得最多"的,而是"记得最准"的——它在恰当的时刻想起恰当的事,其余时间保持安静。这背后是本章反复出现的取舍:写入门槛(3.3)挡住流水账,检索阈值挡住弱相关,遗忘策略给记忆自然代谢。记忆系统的口碑不靠容量堆出来,靠三次关键时段的"恰好转述"挣出来。
另一个实用提醒:记忆功能灰度上线时,给用户一个"查看与删除它记住的事"的入口。这个入口在生产中极少被使用,但它对信任的建立作用远超其功能价值——用户知道记忆可见、可控,才愿意让它继续记下去。