1.4 类别不平衡:从指标失灵到处理清单
1.4 类别不平衡:从指标失灵到处理清单
本节摘要:类别不平衡不是数据问题而是代价问题:错报的代价不对称,指标才会失灵。处理清单有五招——重采样、代价敏感损失、阈值调整、集成策略、换评估口径,每招都有副作用。本节给出一套可在面试里复述的决策顺序与追问防御。
第 1.3 节埋下的伏笔在此兑现:当正例占比跌破百分位量级,准确率失真、ROC 钝感、PR 敏感,这条指标结论链几乎必然被面试官拿来当追问的入口。这一节把散落的处理手段整理成一张可背诵的清单,并说清每种的副作用——面试官真正想听的从来不是「你会过采样」,而是「你知道过采样会在什么场合坑你」。
主问题与答题框架
主问题:「正负样本比例悬殊,你怎么处理?」
这题答成一句「用过采样或欠采样」是典型的及格线止步回答。推荐先做归因再上手段:不平衡之所以是问题,本质是业务上漏报正例(FN)与误报正例(FP)的代价不对称,而标准损失函数把两类错误等权对待。归因说完,手段清单按「动数据、动损失、动阈值、动模型、动指标」五个层次展开,条理立刻清晰。
标准答案
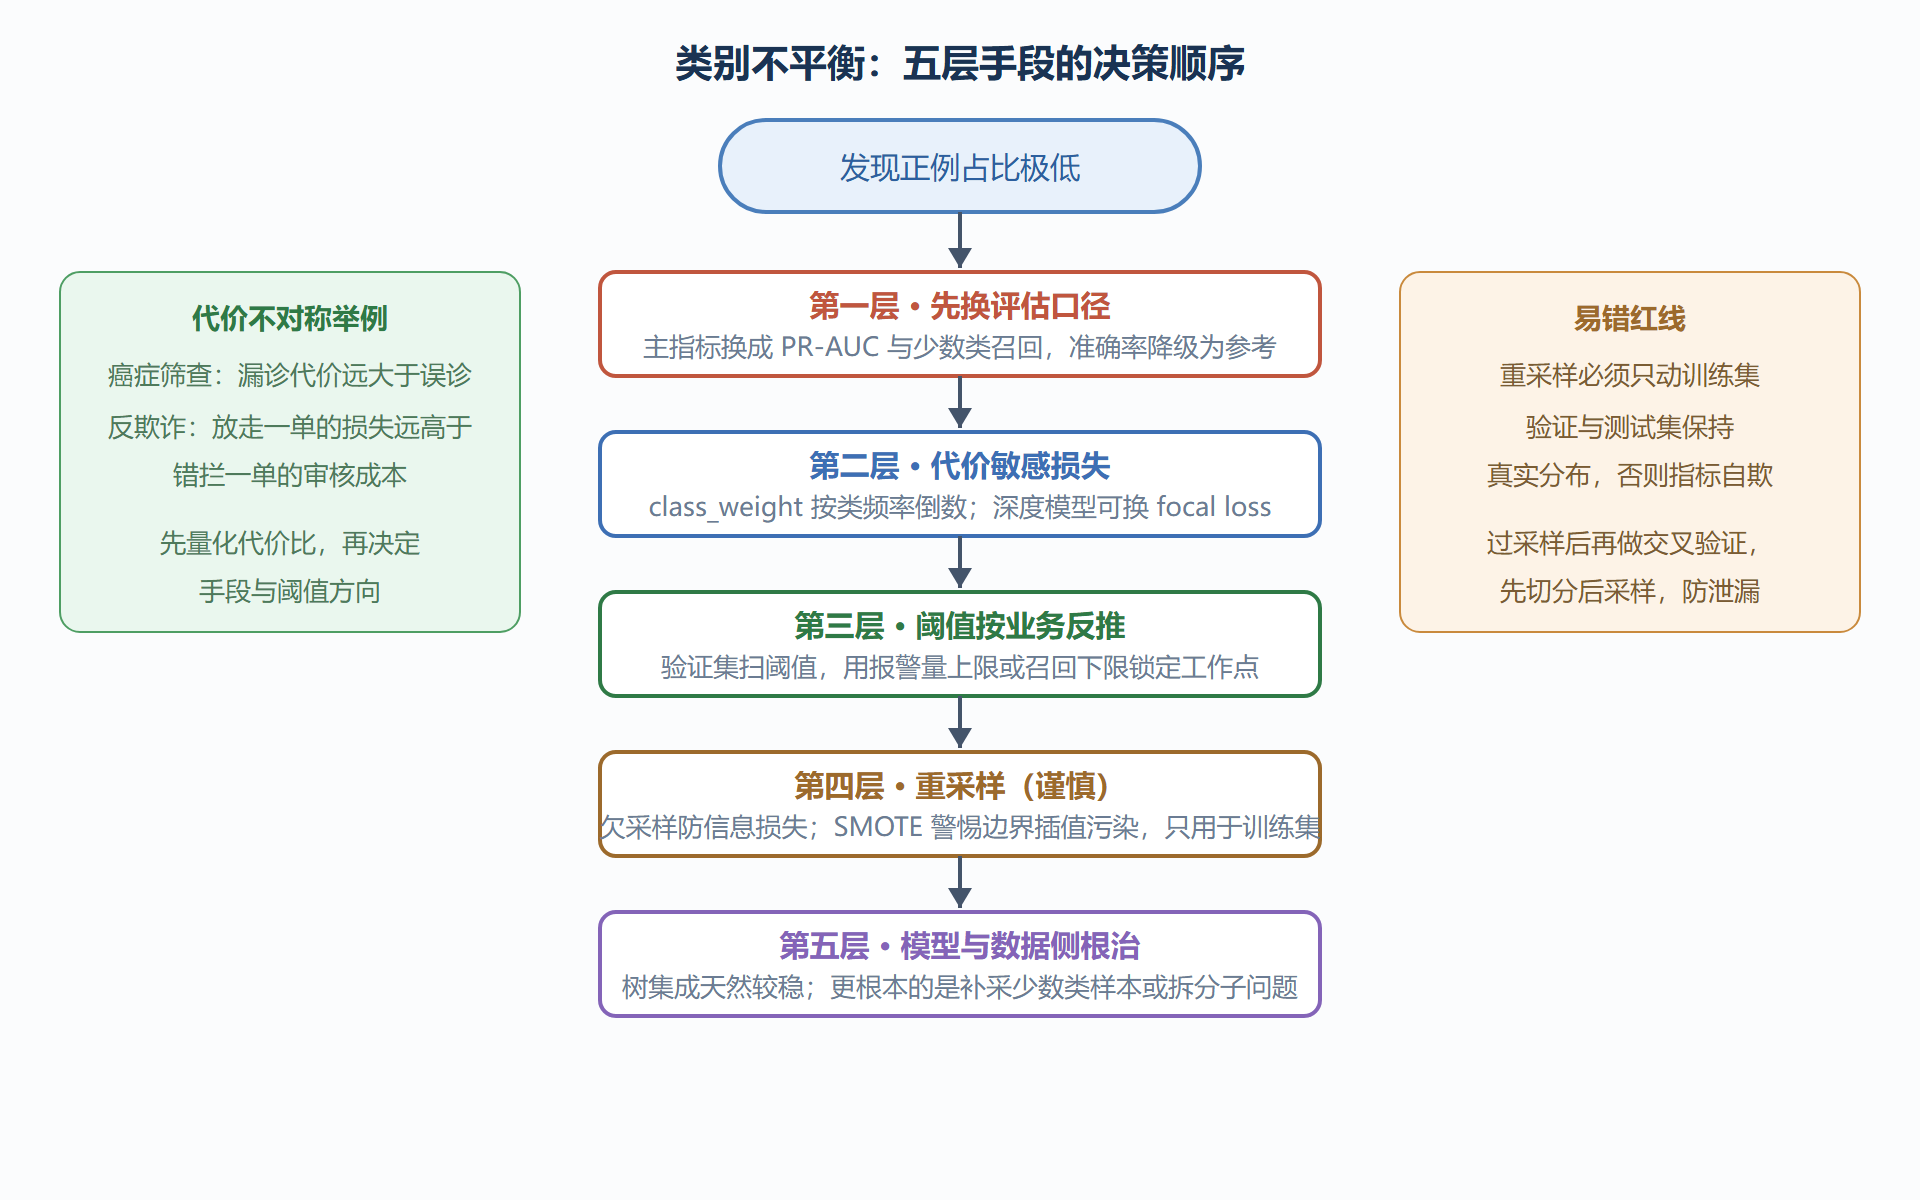
处理类别不平衡按优先级有五类手段。其一,重采样:过采样少数类(SMOTE 在插值生成新样本)、欠采样多数类(可配 EasyEnsemble 这类集成式欠采样);其二,代价敏感:在损失函数里给少数类更高权重,类别加权交叉熵或按类频率倒数设 class_weight;其三,阈值调整:不改模型,把决策阈值从默认值下移,用验证集按业务约束(如目标召回)反推;其四,模型层手段:把不平衡问题交给对不平衡相对鲁棒的模型,如树模型集成,或用 focal loss 压制易分负例的梯度贡献;其五,评估口径换血:放弃准确率,主看 PR-AUC、少数类的召回与精确率。
追问一层:SMOTE 的隐患
追问:「SMOTE 插值出来的样本,有什么问题?」
面试官在考你对「造数据」这件事的警惕心。参考答法:SMOTE 在少数类近邻连线上做线性插值,隐含假设是「同类样本之间的连线仍然同类」。这个假设在特征空间边界处会破产——插值点可能落进多数类地盘,制造出标签可疑的样本,把决策边界搅得更模糊。此外插值不产生新信息,只是对既有少数类流形的加密,遇到少数类本身支离破碎(多峰、子簇)时容易过拟合这些碎片。改进方向要么在采样前先清洗(如 Borderline-SMOTE 只在边界带插值),要么换到代价敏感路线完全不造样本。能说出「造数据不如改代价」这个权衡,比背出算法名高一个档位。
追问二层:阈值怎么定才算讲道理
追问:「你说阈值要按业务反推,具体怎么操作?」
这题从方法论落到操作,很多人在这里含糊。可背的操作序列如下:模型照常输出正例概率;在验证集上扫一遍阈值,画出每个阈值对应的精确率与召回率;把业务约束翻译成筛选条件——例如风控要求「人工审核队列每天最多消化千条」,就取预测为正的样本量等于千条时的阈值;再如要求「漏掉的坏账不超过一成」,就取召回不低于九成的最严阈值。关键句是:阈值是业务决策变量,不是模型超参数,它不该进网格搜索,而该进与业务方的对齐会议。
图:类别不平衡处理决策流程
处理清单的对照表
| 手段 | 改了什么 | 副作用 | 适用信号 |
|---|---|---|---|
| 类别加权损失 | 损失函数里的类权重 | 校准被破坏,概率不再可直接用 | 任何不平衡场景的第一动作 |
| 阈值下移 | 决策规则 | 报警量上升,下游成本增加 | 模型排序尚可、只是工作点不对 |
| 欠采样 | 训练集多数类规模 | 丢信息,需集成式补偿 | 多数类海量且冗余 |
| SMOTE 过采样 | 训练集少数类规模 | 边界插值污染、过拟合碎片 | 少数类样本极少且分布连续 |
| focal loss | 梯度分配 | 引入新的超参数需调 | 深度模型、极低正例占比 |
易错点:在切分训练验证集之前做重采样,让合成样本同时出现在训练与验证两侧,指标虚高到离谱——这是不平衡场景最常见也最致命的泄漏,第 6.1 节还会从交叉验证角度再敲一次黑板;另一种常见失误是给概率输出做了加权训练后,直接拿概率当风险定价用,校准早已偏移,应先做概率校准(如 isotonic 或 Platt)再对外输出。
评分要点
及格:能列出重采样与代价敏感两类手段;良好:五层清单完整,且对 SMOTE 或阈值反推能讲出操作细节;优秀:把不平衡归因到代价不对称与校准失真,指出「只动训练集」的红线,并能结合业务给出代价比量化的思路。这节的处理手段在树模型语境下还有变体(样本权重在 XGBoost 里的落点),第 2.2 节的集成学习会顺带回收这个线头。
到这里,第 1 章的概念链闭环:范式、误差、指标、不平衡。下一章进入具体算法的内部,从最古老也最常青的线性模型开始。
高频追问速答
问:类别加权后概率还准吗,怎么修?
加权改变了损失里的先验假设,输出概率向少数类系统性偏移,不再反映真实频率。要对外输出概率,先做概率校准:在独立的校准集上拟合 Platt 缩放或保序回归,把偏移的概率映射回真实频率。「加权训练加校准输出」是这个考点的完整答案。
问:不平衡场景的验证集该怎么切?
切分方式与常规一致(时序或分层),但评估口径必须换成对少数类敏感的指标(PR-AUC、少数类召回与精确率)。真正的坑在于重采样与切分的顺序:先切分、后仅对训练侧重采样,让验证与测试集保持真实分布——顺序反了,指标立刻虚高到不可信。
问:极端不平衡(百万分之一)还能直接学吗?
先怀疑任务定义。常见做法是把问题改写成更容易学的方式:异常检测框架(无监督或自监督建模正常模式,偏离即报警)、两级漏斗(宽召回加精排序)、或按业务事件重新定义正例(把欺诈检测改成欺诈金额预测)。能在「调采样」之前说出「改任务定义」,是资深判断的标志。
白板自测:默写五层处理清单,并给每层配一个副作用;卡壳即回炉。
深水区:不平衡下的集成与校准细节
问:为什么树集成在不平衡下相对稳,还要再加权重吗?
分裂增益对少数类的收益天然被多数类稀释,加类权重能让分裂点向少数类倾斜;但树集成的概率输出同样会因加权而偏移,权重越大校准越歪。实践组合是「适度权重加事后校准」,权重拉满而不校准是常见翻车配置。
问:不平衡数据的验证指标如何选聚合口径?
优先 macro 或按业务指定少数类的单独指标;micro 口径在不平衡下会被多数类淹没,等于变相回到准确率。报数时同时给出少数类的混淆矩阵原始数字,比任何单一聚合都诚实。
问:欠采样丢掉的信息怎么办?
集成式欠采样(多数类切多份分别与少数类组合训练多个模型再聚合)让每个多数类子样本的信息都被利用;或欠采样只用于加速实验、最终模型用全量数据加类权重训练。手段的取舍要落到「信息利用率」这把尺子上。